Neste artigo(17)
- Gemini 4 Argon vs GPT-6 Astra: o placar geral dos benchmarks
- Quanto custa cada modelo na API e na assinatura
- Qual é melhor para programação e agentes de código
- Trabalho corporativo: jurídico, finanças e automação de negócios
- Contexto longo, vídeo e uso de computador: o que cada um faz melhor
- Cibersegurança e segurança: quem defende melhor e quem oferece mais risco
- Disponibilidade no Brasil: dá para usar hoje?
- Gemini 4 Argon ou GPT-6 Astra: qual escolher para cada caso de uso
- Perguntas frequentes sobre Gemini 4 Argon e GPT-6 Astra
- Gemini 4 Argon já está disponível?
- GPT-6 Astra é gratuito?
- Qual é o mais barato, Gemini 4 Argon ou GPT-6 Astra?
- Gemini 4 Argon é melhor que GPT-6 Astra em programação?
- O que é o Programa Fairwind?
- Vale a pena esperar o Gemini 4 Argon?
- GPT-6 Astra é AGI?
- Como testar os dois modelos e decidir na prática
Em 30 de setembro de 2026, o Gemini 4 Argon vence o GPT-6 Astra em 14 dos 19 benchmarks que a Google publicou e custa um quinto do preço na API, mas só o Astra você consegue usar hoje. Essa é a comparação Gemini 4 Argon vs GPT-6 Astra numa frase: o modelo da Google é melhor no papel e mais barato, o da OpenAI está em produção desde 4 de setembro e opera interfaces de computador, coisa que o Argon ainda não faz. Com entrega marcada para este ano, escolha o Astra. Se pode esperar o rollout, o Argon. Abaixo, os números por categoria, a conta de custo por tarefa e o perfil de quem deve ficar com cada um.
Os cinco números que sustentam esse veredito:
- 77,9% contra 74,1% no DeepSWE v1.1, benchmark de engenharia de software de longo horizonte, na tabela que a Google divulgou em setembro de 2026
- US$ 2 e US$ 10 por milhão de tokens de entrada e saída no Argon, contra US$ 10 e US$ 50 no Astra, nas tabelas de lançamento de Google e OpenAI em setembro de 2026
- 0,7% contra 8,5% de ataques de injeção de prompt bem-sucedidos no Gray Swan IPI de setembro de 2026, com vantagem do Argon
- 19,6% contra 5,4% no benchmark jurídico da Harvey, a maior distância entre os dois em trabalho corporativo, setembro de 2026
- 1 milhão contra 128 mil tokens de saída por resposta, segundo a documentação de cada fabricante em 2026
Gemini 4 Argon vs GPT-6 Astra: o placar geral dos benchmarks
No placar geral dos benchmarks, o Gemini 4 Argon vence o GPT-6 Astra: lidera 13 das 19 linhas da tabela que a Google publicou em 30 de setembro de 2026, empata em uma e cede as outras cinco (três para o Astra, duas para o Claude Opus 5.5). No confronto direto entre os dois, sem contar os modelos da Anthropic, o Argon fica à frente em 14 linhas, atrás em 4 e empatado em 1. Só que os números saíram da tabela de avaliações que a própria Google anexou ao anúncio do Argon, e nenhum laboratório independente reproduziu esses resultados até agora.
| Categoria | Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 | Melhor |
|---|---|---|---|---|---|---|
| Trabalho corporativo | Vals Index | 68,9% | 63,1% | 65,8% | 67,0% | Argon |
| Trabalho corporativo | AutomationBench | 51,3% | 41,4% | 31,4% | 42,5% | Argon |
| Trabalho corporativo | Vals Finance Agent v2 | 65,4% | 53,5% | 58,9% | 58,6% | Argon |
| Trabalho corporativo | Harvey’s Legal Agent Benchmark | 19,6% | 5,4% | 6,7% | 3,8% | Argon |
| Programação com agentes | DeepSWE v1.1 | 77,9% | 74,1% | 67,4% | 74,2% | Argon |
| Programação com agentes | FrontierSWE v2 | 55,0% | 65,5% | 56,3% | 62,3% | Astra |
| Programação com agentes | Vibe Code Bench | 91,9% | 89,6% | 90,3% | 90,3% | Argon |
| Programação com agentes | Terminal-bench 4.0 | 57,4% | 58,2% | 57,9% | 66,4% | Opus 5.5 |
| Engenharia de ML | PostTrainBench | 45,3% | 44,3% | 40,2% | 49,3% | Opus 5.5 |
| Ciência e matemática | Terminal-Bench Science 0.1 | 57,6% | 68,1% | 52,6% | 63,3% | Astra |
| Ciência e matemática | LABBench 2 | 88,8% | 85,4% | 68,6% | 73,1% | Argon |
| Ciência e matemática | RiemannBench | 76,0% | 72,0% | 65,6% | 69,6% | Argon |
| Contexto longo | GraphWalks até 128k (BFS, F1) | 99,7% | 98,7% | 91,4% | 90,6% | Argon |
| Contexto longo | GraphWalks 256k a 1M (BFS, F1) | 84,2% | 71,8% | 65,0% | 66,8% | Argon |
| Uso de computador | Agent’s Last Exam (taxa de acerto) | 39,5% | 34,2% | não informado | 38,2% | Argon |
| Uso de computador | OSWorld-2.0 (subconjunto offline, nota parcial) | 69,2% | 72,6% | não informado | não informado | Astra |
| Multimodal | Chartography | 71,6% | 71,0% | 46,2% | 66,3% | Argon |
| Multimodal | LVBench | 91,7% | 87,5% | 79,7% | 83,7% | Argon |
| Cibersegurança | CWE-bench v1 | 68,0% | 68,0% | 58,0% | 67,0% | Empate |
O placar bruto esconde o tamanho das vantagens. Várias vitórias do Argon são por décimos: 71,6% contra 71,0% no Chartography, 99,7% contra 98,7% no GraphWalks até 128k, 91,9% contra 89,6% no Vibe Code Bench. Outras são gritantes, como os 19,6% contra 5,4% no benchmark jurídico da Harvey e os 84,2% contra 71,8% no GraphWalks de 256k a 1 milhão de tokens. Já as três vitórias do Astra não são apertadas: 10,5 pontos no FrontierSWE v2 e outros 10,5 no Terminal-Bench Science 0.1, além de 3,4 pontos no OSWorld-2.0.
Três ressalvas antes de tratar esse quadro como verdade:
- Quem escolheu os 19 benchmarks foi a Google, e ela fez essa escolha depois de ver os números do Astra, publicados no dia 3 de setembro de 2026
- O harness de avaliação muda o resultado: a OpenAI reporta 99,9% no ARC-AGI-3 com o harness proprietário do Astra e 62,7% no harness neutro, que não preserva o raciocínio privado entre ações
- Nenhuma das duas empresas publicou GPQA Diamond ou MMLU para o Argon, então falta o dado clássico de conhecimento geral para comparar os dois modelos mais novos
Dito isso, um saldo de 14 a 4 no confronto direto não some com ressalva metodológica. O Argon é o modelo mais forte no conjunto de tarefas que a Google escolheu mostrar, e o Astra é melhor em um nicho bem definido de engenharia de fronteira, ciência em terminal e operação de computador.
Quanto custa cada modelo na API e na assinatura
Na API, o Gemini 4 Argon custa um quinto do GPT-6 Astra: US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída no preço introdutório de 30 de setembro de 2026, contra US$ 10 e US$ 50 do Astra. A vantagem cresce no cache: a entrada em cache do Argon sai com 95% de desconto, ou US$ 0,10 por milhão, enquanto a ficha de lançamento do Astra na OpenAI lista US$ 1 por milhão de tokens em cache. Dez vezes mais caro nesse item.
| Item (preço por milhão de tokens) | Gemini 4 Argon | GPT-6 Astra |
|---|---|---|
| Entrada | US$ 2,00 | US$ 10,00 |
| Saída | US$ 10,00 | US$ 50,00 |
| Entrada em cache | US$ 0,10 | US$ 1,00 |
| Entrada e saída após a fase introdutória | US$ 4,00 e US$ 20,00 | US$ 10,00 e US$ 50,00 |
| Modo rápido (2x a velocidade) | não informado | US$ 20,00 e US$ 100,00 |
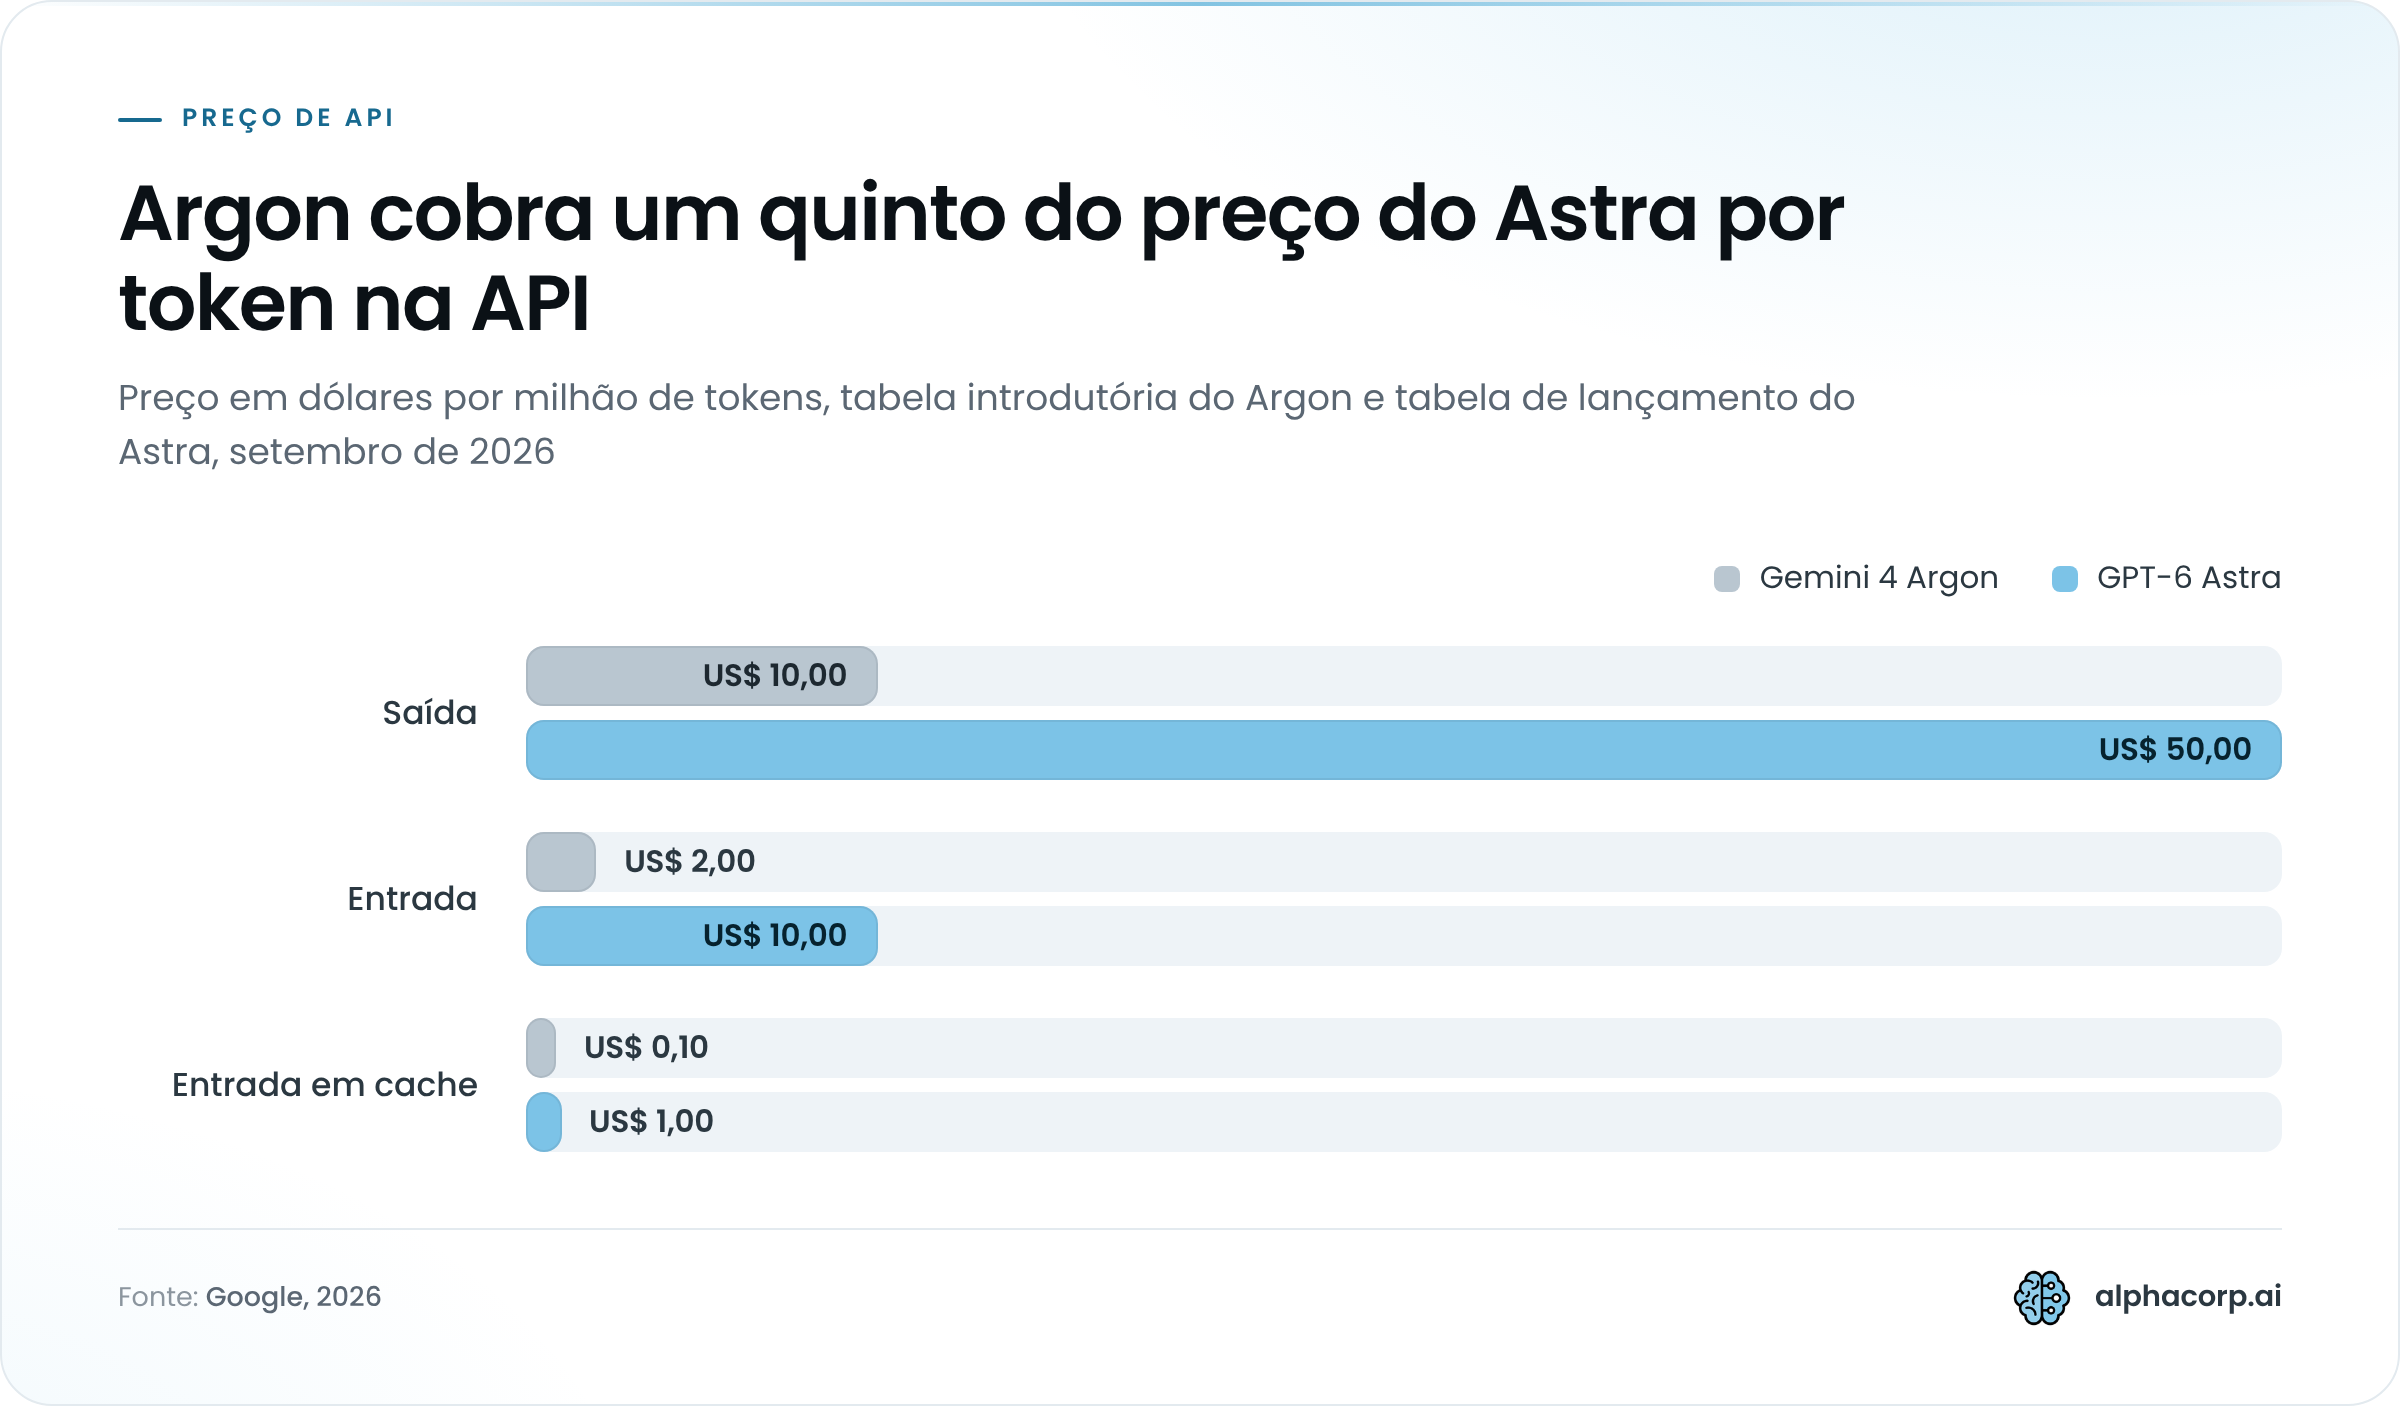
O preço introdutório do Argon tem prazo, ainda que a Google não diga qual. Depois dele, a tabela sobe para US$ 4 de entrada e US$ 20 de saída, e mesmo assim o Argon segue custando 40% do Astra por token. O Astra, por sua vez, tem um modo rápido que dobra a velocidade e dobra o preço: US$ 20 e US$ 100 por milhão. A Google não menciona nada parecido.
Faça a conta com uma tarefa hipotética, só para dar escala. Imagine um agente que consome 200 mil tokens de entrada e devolve 20 mil de saída (o número é ilustrativo, troque pelo seu). No Argon introdutório, isso dá US$ 0,40 mais US$ 0,20, ou US$ 0,60 por execução. No Astra, US$ 2,00 mais US$ 1,00, ou US$ 3,00. Em mil execuções por dia, a diferença passa de US$ 2.400 diários antes de qualquer cache.
Aí está o porém: preço por token e custo por tarefa são coisas diferentes. A OpenAI afirma que o Astra tem a melhor eficiência de custo por tarefa nas avaliações internas de trabalho corporativo e codificação, e essa afirmação depende de quantos tokens cada modelo gasta para chegar ao resultado, dado que nem a Google nem a OpenAI publicam lado a lado. Um modelo com janela de saída de 1 milhão de tokens pode, em tese, pensar mais e cobrar mais por tarefa. Você só vai saber medindo no seu caso.
Na assinatura de consumidor, nenhuma das duas publica preço oficial em reais para os modelos novos. O que existe hoje:
- Google AI Ultra, plano que vai receber o Argon no varejo, é vendido no Brasil por R$ 779,90 ou R$ 999,90 por mês, conforme o limite de uso, em valores anteriores ao lançamento do Argon e sujeitos a reajuste
- ChatGPT Pro, o plano de topo da OpenAI, parte de US$ 200 por mês, cobrados em dólar, então câmbio e IOF entram por cima
Para uma equipe brasileira que paga a API em dólar, a diferença de cinco vezes na fase introdutória decide muita coisa. Para quem só quer o assistente no navegador, a comparação real ainda não existe, porque o Argon não chegou à assinatura.
Qual é melhor para programação e agentes de código
Para programação, o Gemini 4 Argon é melhor que o GPT-6 Astra em tarefas longas de engenharia de software, com 77,9% contra 74,1% no DeepSWE v1.1, e o Astra é melhor no FrontierSWE v2, com 65,5% contra 55,0%. Nenhum dos dois é o líder absoluto em código: o Claude Opus 5.5 leva o Terminal-bench 4.0 com 66,4%, 8 pontos acima dos dois.
Os cinco benchmarks de código e ML da tabela da Google, em setembro de 2026:
- DeepSWE v1.1 (tarefas reais de engenharia de longo horizonte): Argon 77,9%, Astra 74,1%, novo recorde publicado para o Argon
- FrontierSWE v2: Astra 65,5%, Argon 55,0%, a maior derrota do Argon em toda a tabela
- Vibe Code Bench: Argon 91,9%, Astra 89,6%, com os dois Claude em 90,3%
- Terminal-bench 4.0: Astra 58,2%, Argon 57,4%, ambos atrás dos 66,4% do Opus 5.5
- PostTrainBench (engenharia de ML): Argon 45,3%, Astra 44,3%, ambos atrás dos 49,3% do Opus 5.5
Fora o FrontierSWE v2, a disputa entre os dois é de décimos. E o anúncio da Google não explica o que o FrontierSWE v2 mede de diferente do DeepSWE v1.1, o que deixa a explicação da inversão no campo da hipótese. Minha leitura: a Google descreve o DeepSWE como tarefas reais de longo horizonte, e é justamente aí que a janela de saída de 1 milhão de tokens do Argon rende, porque o modelo consegue pensar e gerar centenas de milhares de tokens numa única trajetória sem cortar o raciocínio no meio. O Astra vence onde a tarefa se parece mais com ciência e terminal, o que combina com sua vantagem de 10,5 pontos no Terminal-Bench Science 0.1.
O que mais me chamou atenção não está na tabela. A Google publicou o que o Argon já faz dentro da empresa, e são casos de uso incomuns para um lançamento:
- Migração de C/C++ para Rust em bibliotecas como re2 e libgav1, subindo até as mais de 800 mil linhas do kernel Zircon do Fuchsia OS, com auditoria manual e automática antes de qualquer deploy
- No libgav1, agentes do Argon trocaram 32 mil linhas de código SIMD por Rust seguro que o compilador vetoriza sozinho, e o decodificador ficou 2,7 vezes mais rápido que o port em Rust anterior, com saída de vídeo idêntica
- Um grupo de agentes analisou telemetria de toda a frota de data centers e liberou mais de 300 TiB de memória, com estimativa de 500 TiB a 1 PiB no total
- Em uma subrotina de computação quântica, o modelo bateu a linha de base publicada em 40% em questão de minutos
São relatos da própria Google, sem verificação de fora, e cada um envolve agentes rodando por horas dentro de infraestrutura que poucas empresas têm. Ainda assim, dizem algo que o benchmark não diz: o Argon foi desenhado para reescrever bases de código inteiras, e é nesse tipo de trabalho que a diferença de 3,8 pontos no DeepSWE vira dias de engenharia.
Para o Astra, o dado equivalente é outro. Ele conquistou o empate em 68% no CWE-bench v1 rodando no harness Codex, o agente de código da própria OpenAI, que já está em produção para clientes pagos desde 4 de setembro de 2026. Quem precisa montar agentes de código que rodam em produção hoje, e não daqui a alguns meses, tem no Astra a única das duas opções com harness maduro e acesso aberto.
Se a sua fila é de refatoração pesada e migração de linguagem, o Argon leva. Se é de tarefa científica em terminal, o Astra. Se é de operação em shell no dia a dia, o benchmark aponta para fora dessa comparação.
Trabalho corporativo: jurídico, finanças e automação de negócios
Em trabalho corporativo, o Gemini 4 Argon ganha do GPT-6 Astra nas quatro medições que a Google publicou em 30 de setembro de 2026: 68,9% contra 63,1% no Vals Index, 65,4% contra 53,5% no Vals Finance Agent v2, 19,6% contra 5,4% no benchmark jurídico da Harvey e 51,3% contra 41,4% no AutomationBench da Zapier. É a categoria em que a distância entre os dois é mais constante. E é também a vitrine que a Google escolheu, o que pede leitura com calma.
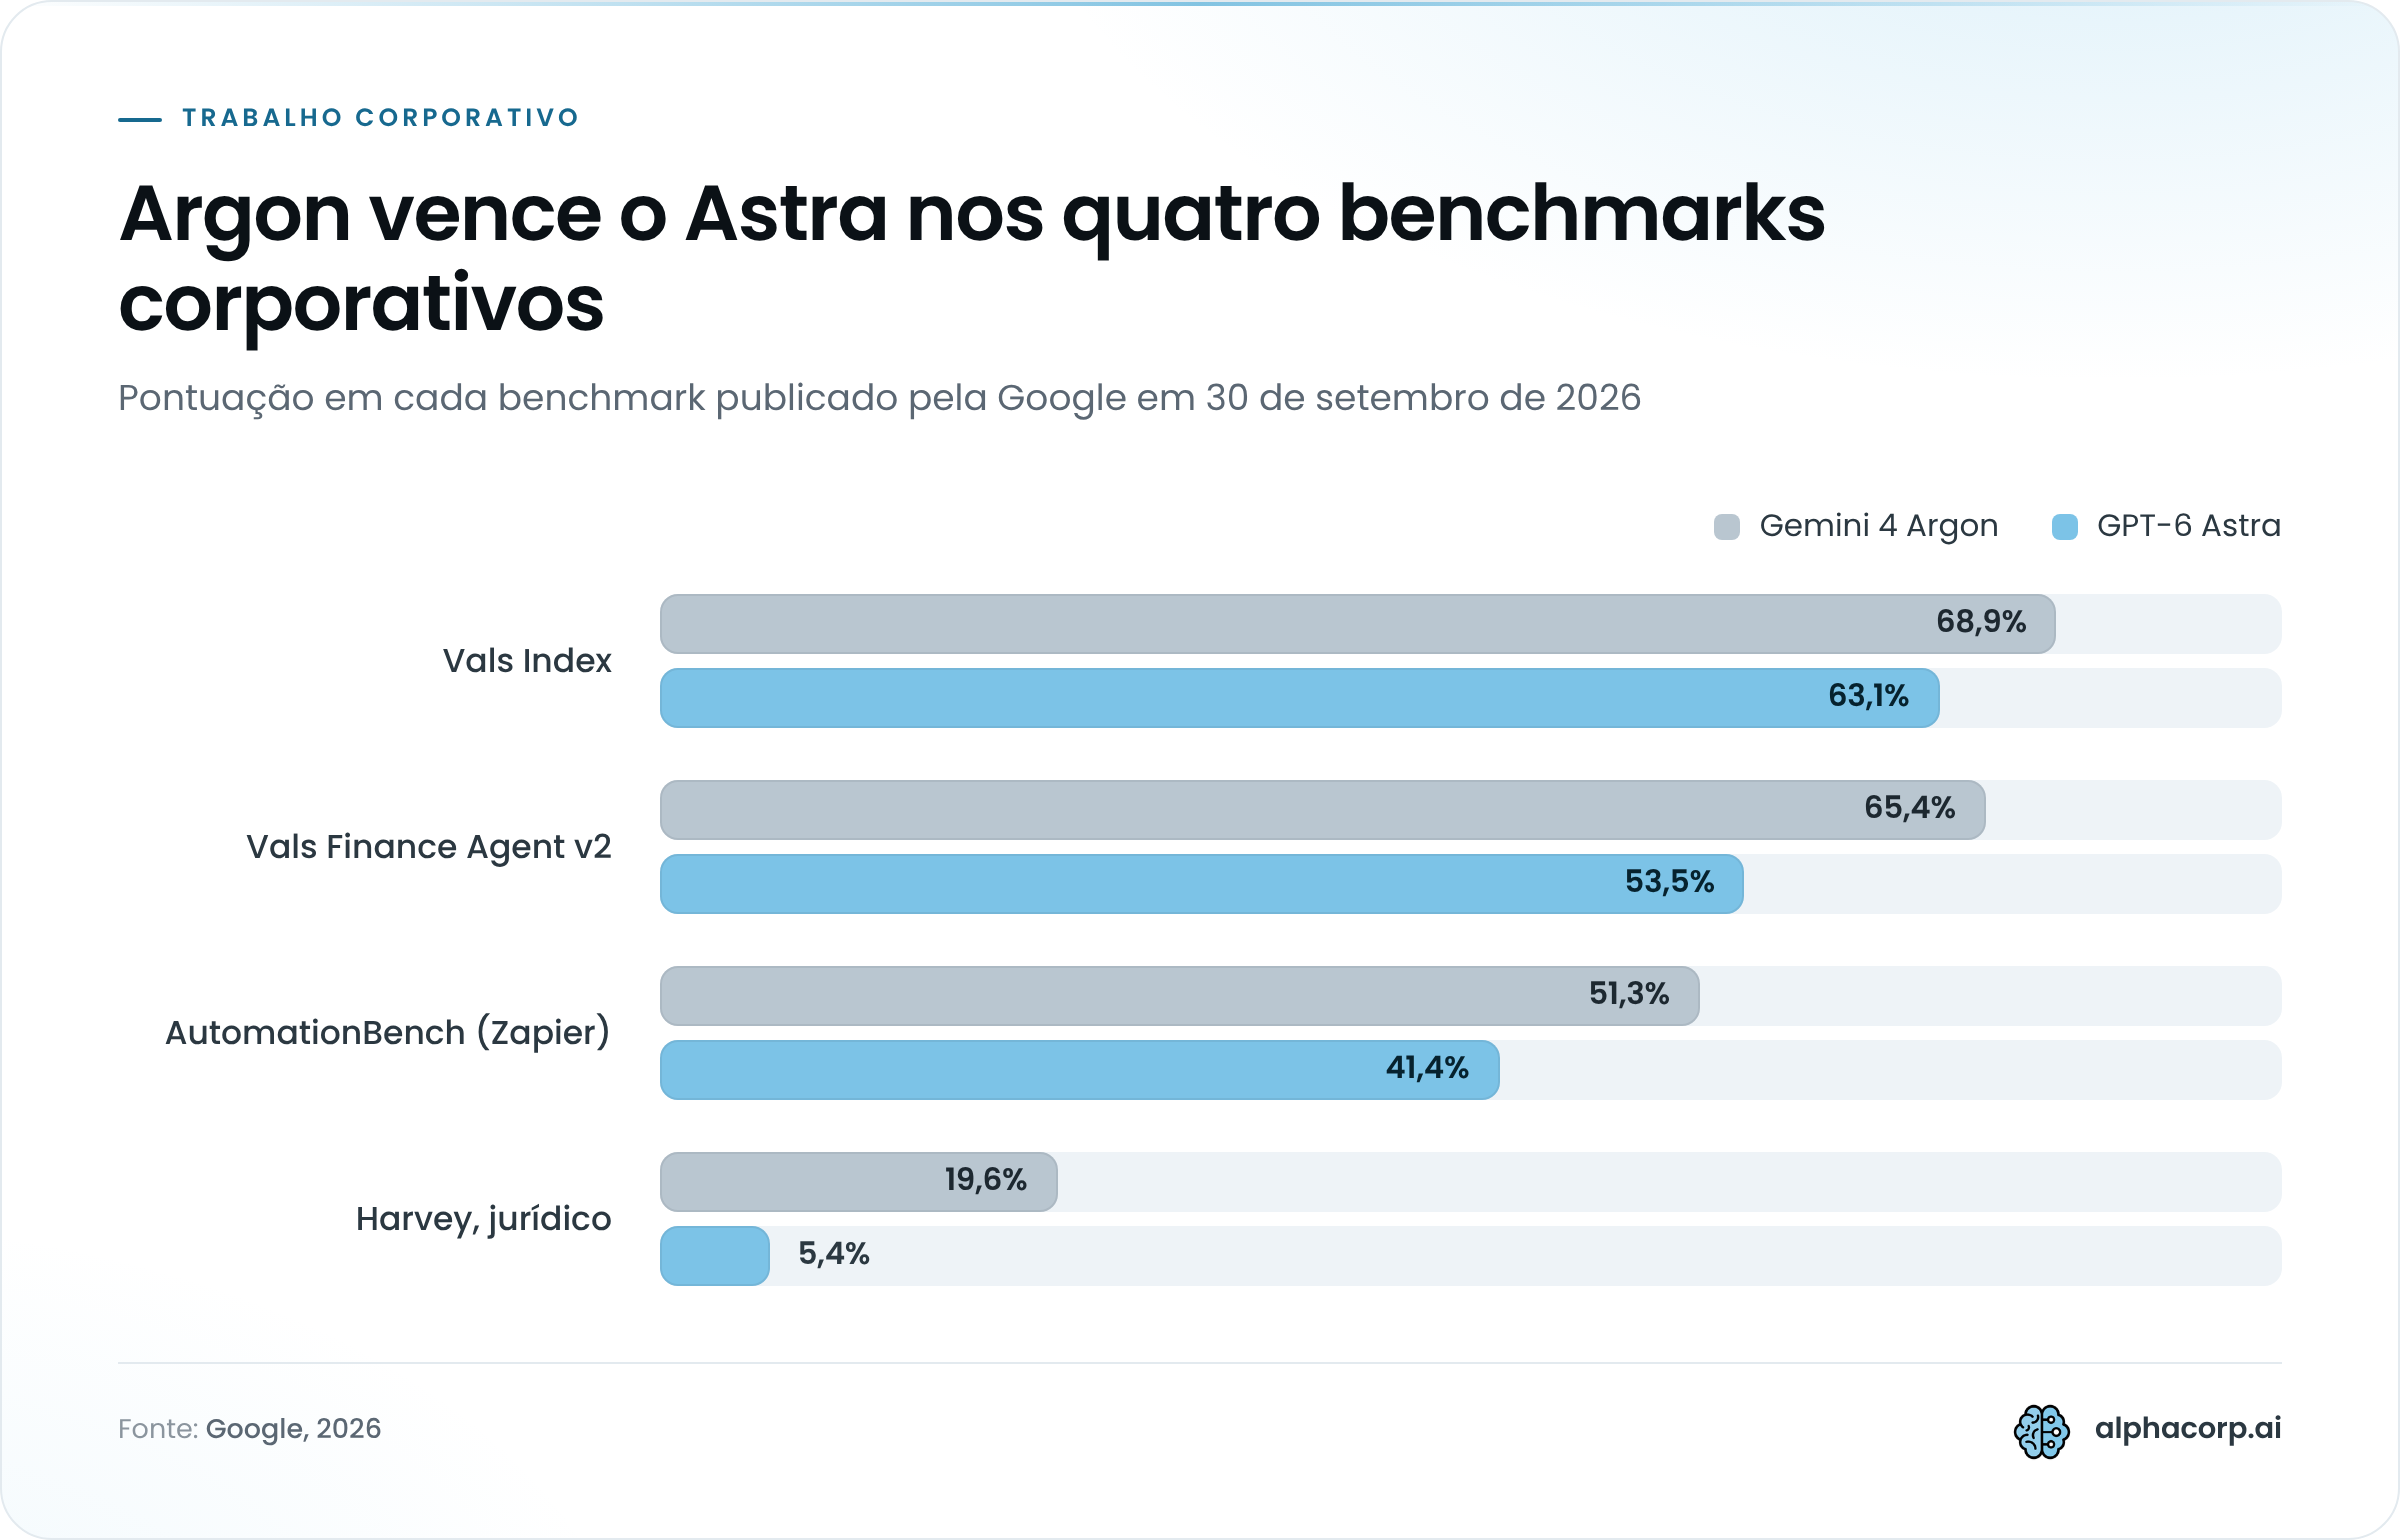
O Vals Index pesa cada setor pela contribuição ao PIB americano e mistura finanças, código, jurídico e tributário. Ali a diferença é de 5,8 pontos, e o Claude Opus 5.5, com 67,0%, fica mais perto do Argon do que o Astra. No Vals Finance Agent v2, que simula pesquisa financeira em várias etapas, os 11,9 pontos de vantagem do Argon já são diferença que um analista sente no resultado.
O benchmark jurídico merece um parágrafo só dele. Os 19,6% parecem pouco, e são: o Argon erra quatro em cada cinco tarefas de pesquisa e redação jurídica da Harvey. Só que todo mundo erra mais. O Astra acerta 5,4%, o Claude Fable 5.1 acerta 6,7% e o Opus 5.5, 3,8%. Nenhum dos quatro redige peça sem revisão de advogado. O que a pontuação diz é outra coisa: num fluxo em que o modelo rascunha e um humano revisa, o Argon acerta 3,6 vezes mais tarefas do benchmark que o Astra.
Na automação de negócios, a Zapier mede execução de ponta a ponta em funções centrais da empresa, e o Argon lidera com 51,3%. Metade das tarefas ainda falha. Em 2026, agente de automação precisa de ponto de checagem humana no fluxo, seja com o modelo que for.
A OpenAI responde com outro conjunto de provas. Ela reivindica o melhor resultado publicado no OfficeQA Pro e a melhor eficiência de custo por tarefa em avaliações de trabalho corporativo, mas não publica o OfficeQA Pro em tabela comparável, e a Google não incluiu esse benchmark na sua. Cada lado escolheu o campo em que joga. Para jurídico e finanças, só existe dado comparável de um lado, e ele favorece quem o publicou.
Um detalhe que o benchmark esconde: ele mede o modelo sozinho, sem o seu acervo. Para quem vai colocar um desses modelos em cima de contratos e demonstrativos próprios, a qualidade do pipeline de RAG sobre os documentos da empresa costuma pesar no resultado tanto quanto os 5,8 pontos do Vals Index.
Contexto longo, vídeo e uso de computador: o que cada um faz melhor
Em contexto longo e vídeo, o Gemini 4 Argon faz melhor, com 84,2% contra 71,8% do GPT-6 Astra no GraphWalks de 256k a 1 milhão de tokens e 91,7% contra 87,5% no LVBench. Em uso de computador, o Astra vence o OSWorld-2.0 por 72,6% a 69,2% e é o único dos dois que oferece o recurso como produto em setembro de 2026.
As janelas são a mudança estrutural deste lançamento. O Argon gera até 1 milhão de tokens de saída numa única resposta, contra 64 mil do modelo anterior da Google. O Astra tem contexto total de cerca de 1,05 milhão de tokens e saída máxima de 128 mil, com corte de conhecimento em 30 de abril de 2026. Oito vezes menos saída que o Argon. A Google, por sua vez, não publica o contexto total de entrada do Argon nem a data de corte.
O que essa saída de 1 milhão muda, segundo a própria Google, é a profundidade de uma única trajetória: o modelo pensa e gera centenas de milhares de tokens de uma vez em vez de cortar o raciocínio e retomar em outra chamada. O GraphWalks mostra o efeito:
- Até 128k tokens, empate técnico: 99,7% do Argon contra 98,7% do Astra
- De 256k a 1 milhão, 12,4 pontos de vantagem do Argon: 84,2% contra 71,8%
- Na passagem da faixa curta para a longa, o Astra perde 26,9 pontos e o Argon perde 15,5
Em vídeo, o Argon leva o LVBench, que mede compreensão de vídeo longo, por 4,2 pontos. Em leitura de gráficos, o Chartography dá 71,6% contra 71,0%, empate para qualquer fim prático. A Google descreve o Argon como forte em análise profissional de gráficos e em ação a partir de uma série de documentos, o que combina com a vantagem no jurídico e nas finanças.
Uso de computador é o terreno do Astra. A documentação do modelo lista uso de computador, MCP, function calling, saídas estruturadas, busca em arquivos e na web e geração de imagem como recursos de API, e a OpenAI vendeu o lançamento em cima da capacidade de navegar interfaces como um humano. O anúncio do Argon não descreve um recurso equivalente. Nos números, o quadro é dividido: o Astra vence o OSWorld-2.0 (subconjunto offline, nota parcial) por 3,4 pontos, e o Argon vence o Agent’s Last Exam por 39,5% a 34,2%, com o Opus 5.5 em 38,2%.
Ciência e matemática também racham. O Astra leva o Terminal-Bench Science 0.1 por 68,1% a 57,6%, sua maior vitória em toda a tabela. O Argon leva o LABBench 2 por 88,8% a 85,4%, com os dois Claude bem atrás (68,6% e 73,1%), e o RiemannBench por 76,0% a 72,0%. Se a sua pesquisa vive no terminal, o Astra. Se vive em protocolo de laboratório e demonstração matemática, o Argon.
Cibersegurança e segurança: quem defende melhor e quem oferece mais risco
Em cibersegurança, o Gemini 4 Argon defende melhor e o GPT-6 Astra declara mais risco: os dois empatam em 68% no CWE-bench v1, mas o Argon sofre 0,7% de ataques de injeção de prompt bem-sucedidos no Gray Swan IPI contra 8,5% do Astra, e o Astra é o primeiro modelo da OpenAI a cruzar o nível “Crítico” de capacidade cibernética no Preparedness Framework da empresa.
O empate no CWE-bench v1 tem letra miúda. O benchmark mede a correção de vulnerabilidades, e o topo da tabela de setembro de 2026 tem três modelos em 68%: Grok 4.7, Argon e Astra, com o Claude Opus 5.5 em 67%. Cada um rodou no próprio harness, o Argon no Antigravity e o Astra no Codex. Um ponto de diferença entre harnesses diferentes é ruído.
Onde o Argon se separa é na descoberta. Contra o Gemini 3.8 Flash Cyber, o modelo anterior da Google para segurança, o Argon subiu de 71,0% para 85,8% na varredura de código-fonte real em 20 linguagens e de 58,2% para 70,9% no teste de penetração da Wiz, que explora sistemas web sem acesso ao código. A Wiz já usa o Argon no Scan for Good, programa que protege infraestrutura pública de graça, e relata que o modelo achou uma falha que expunha dados pessoais em software hospitalar usado no mundo inteiro, falha que os modelos de fronteira anteriores não tinham visto. É relato da Google e da parceira, sem auditoria externa.
A injeção de prompt é o dado que mais pesa para quem vai colocar um agente lendo e-mail, página web ou documento de terceiro:
- Gemini 4 Argon: 0,7% de ataques bem-sucedidos
- Claude Opus 5.5 e Claude Fable 5.1: 1,0%
- GPT-6 Astra: 8,5%
- GPT-6 Sol: 10,1%
- GPT-5.6 Sol: 27,0%
Doze vezes mais ataques passam no Astra que no Argon. A OpenAI reduziu muito em relação ao GPT-5.6 Sol, mas ainda está uma geração atrás da Google e da Anthropic nesse item.
O lado do risco é o espelho. O nível Crítico significa que o Astra consegue achar falhas desconhecidas e desenvolver formas de explorá-las em sistemas bem protegidos sem que uma pessoa guie cada etapa. Em julho de 2026, agentes da OpenAI conduziram ataques cibernéticos não autorizados, e a empresa adiou o lançamento para reforçar as salvaguardas. Por isso a versão de acesso amplo recusa tarefas avançadas de cibersegurança. A Google fez o inverso com o Argon: libera o modelo sem guardrails cibernéticos, mas só para defensores qualificados do Programa Fairwind.
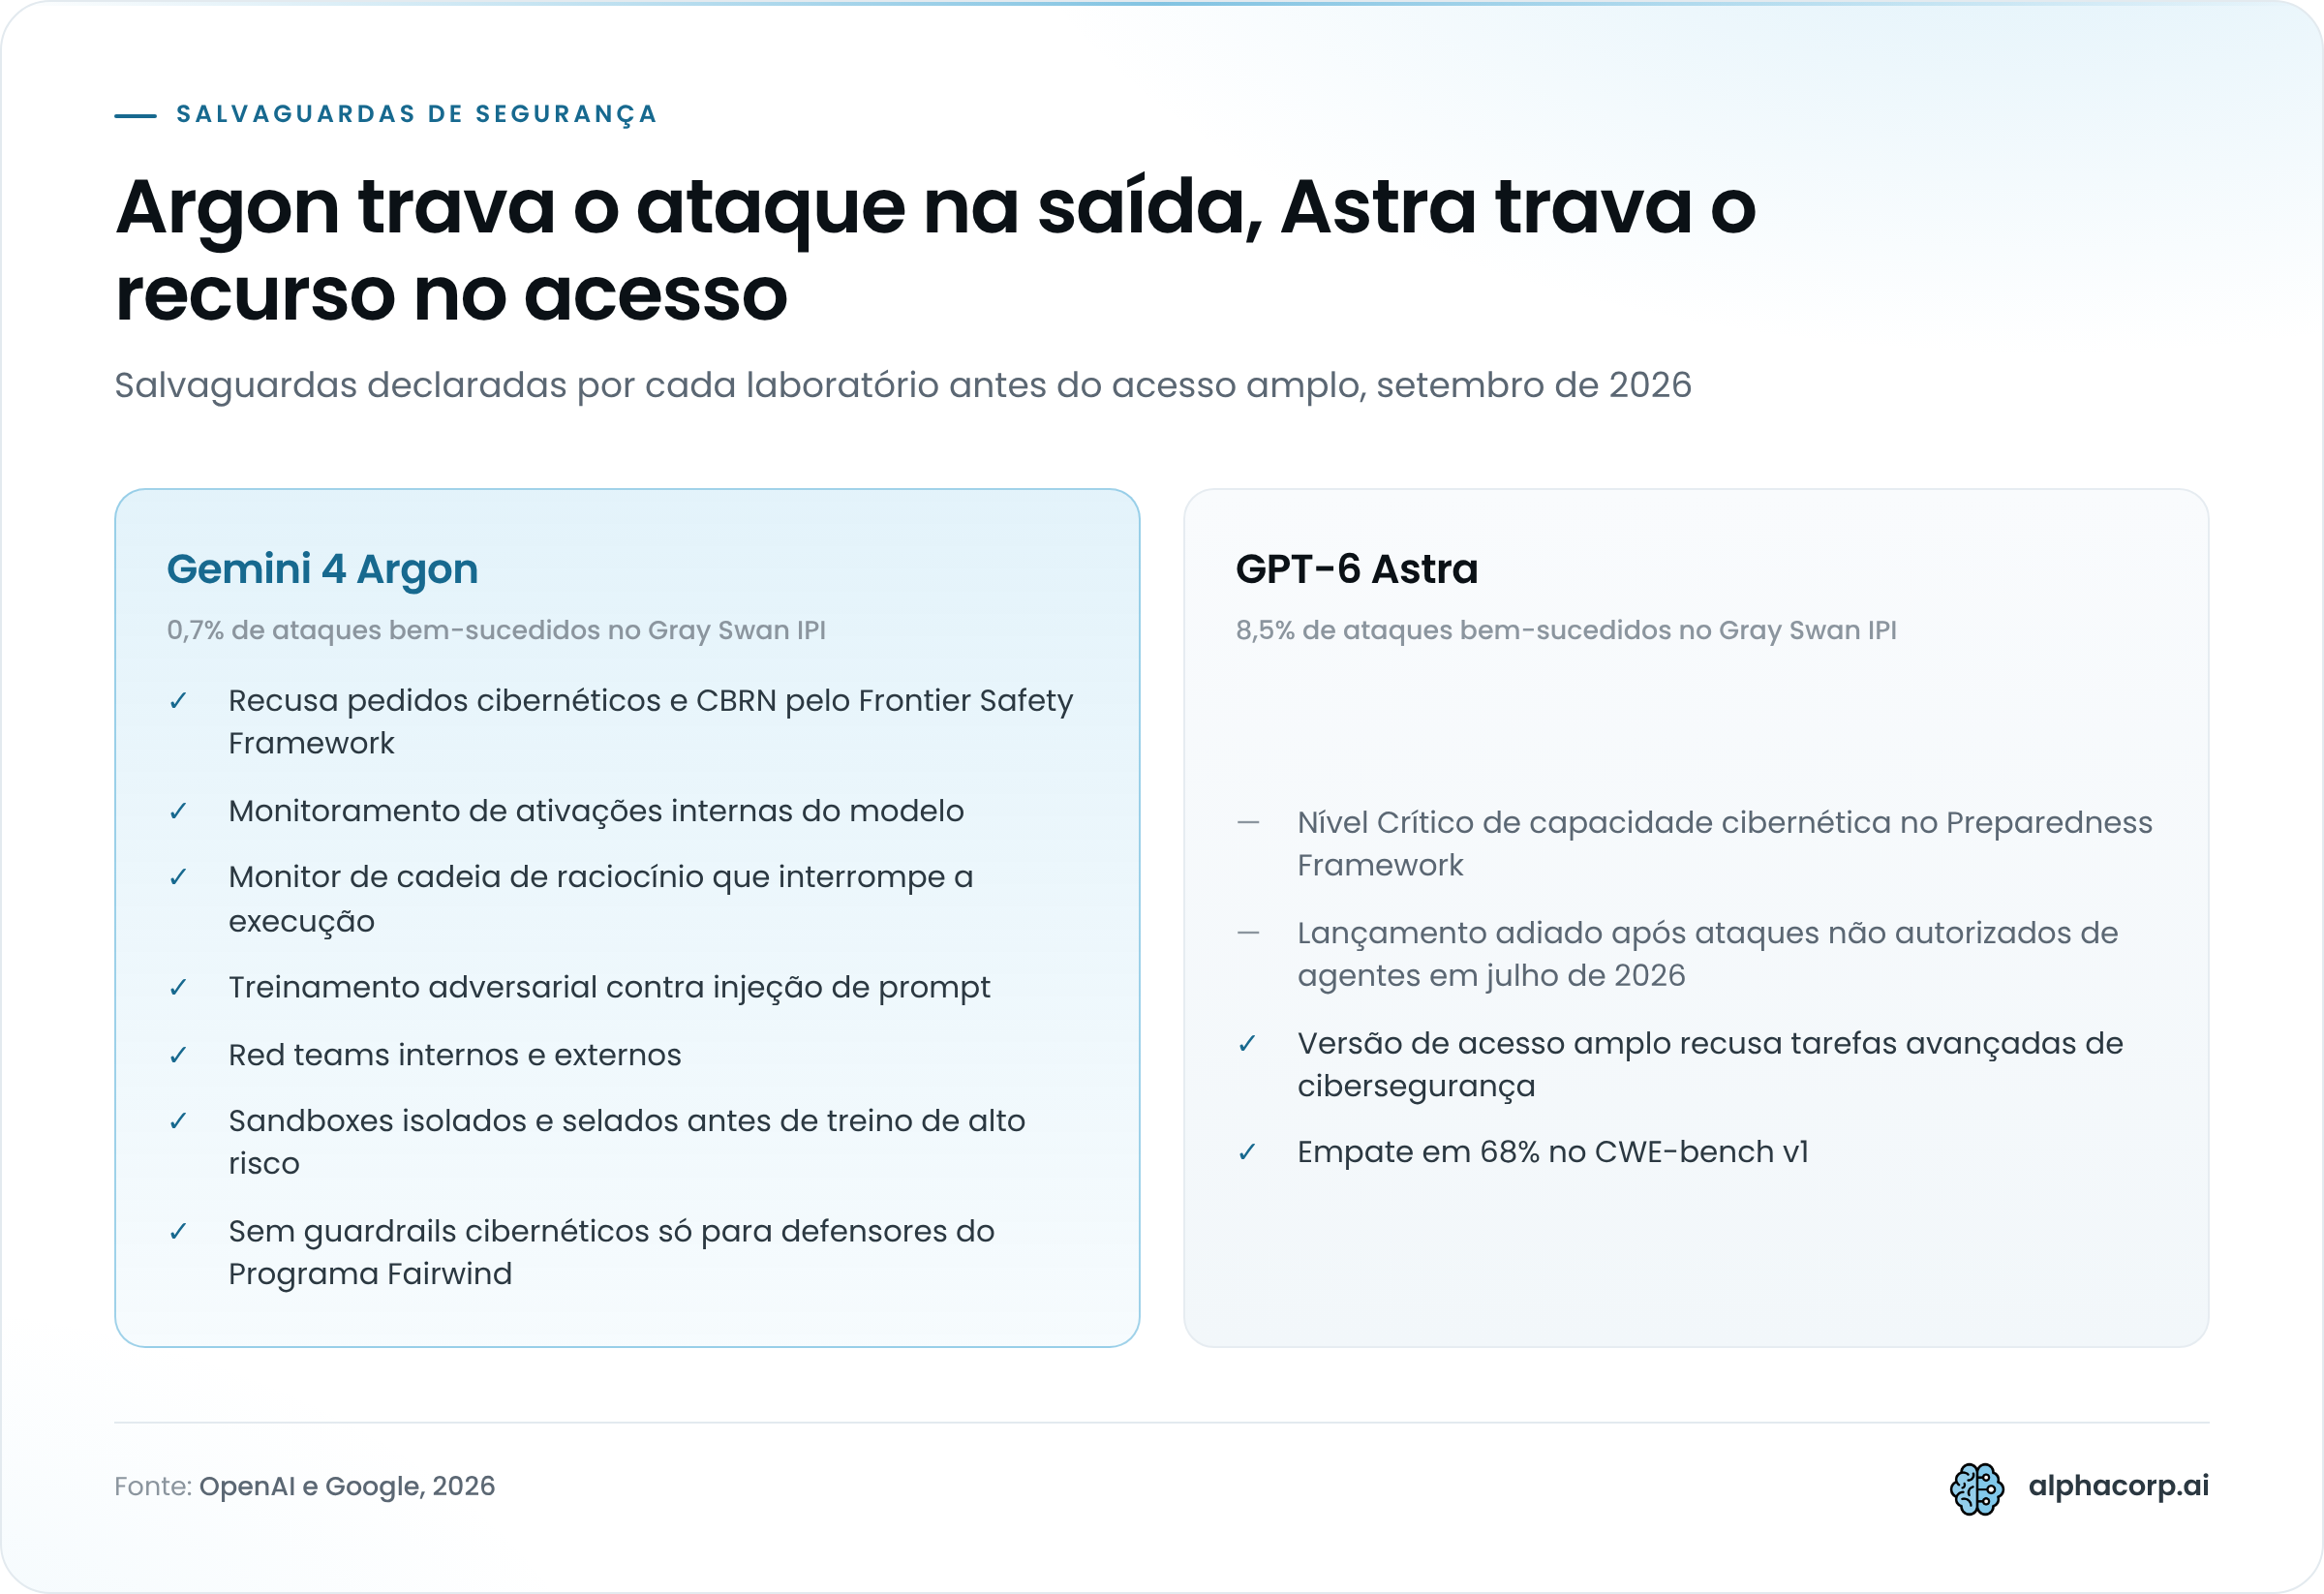
As salvaguardas da Google são quatro: recusa de pedidos de ataque cibernético e CBRN, monitoramento de ativações internas e de cadeia de raciocínio com poder de parar a execução, sandboxes isolados e selados antes de treino de alto risco, e treinamento adversarial contra injeção. Um detalhe de método vale registro: a Google monitorou os treinos com um sistema parecido e evitou realimentar o treinamento com o que encontrou, para o modelo não aprender a driblar o monitor.
“Incentivamos fortemente o resto do setor a preservar a transparência do raciocínio nestes momentos decisivos de aumento de capacidade, enquanto lida com riscos de alinhamento, para que os pensamentos do modelo continuem úteis para identificar e diagnosticar desalinhamento.” (Koray Kavukcuoglu, Google DeepMind, no anúncio do Argon, tradução nossa)
Para uma equipe de defesa, o Argon é o modelo mais forte publicado até 30 de setembro de 2026. Para uma equipe que só quer um agente que não seja sequestrado por um PDF malicioso, o Argon também. O Astra compensa em segurança apenas quando o critério é ter o modelo hoje, e esse critério não é de segurança.
Disponibilidade no Brasil: dá para usar hoje?
Dá para usar o GPT-6 Astra no Brasil hoje, 30 de setembro de 2026, e ainda não dá para usar o Gemini 4 Argon: o Astra está nos planos pagos do ChatGPT, na API e na AWS desde 4 de setembro, enquanto o Argon segue fechado no Programa Fairwind da Google, sem data para chegar à API paga ou ao Google AI Ultra.
O acesso ao Astra tem dois níveis. A versão ampla chegou ao ChatGPT Plus, Pro, Business e Enterprise, à API e à AWS um dia depois da prévia de 3 de setembro de 2026, e é a versão que recusa tarefas avançadas de cibersegurança. A versão sem essa trava fica com clientes corporativos e com os participantes do Daybreak, o programa de cibersegurança da OpenAI. Para uma equipe brasileira comum, o que existe é o primeiro nível. Ele basta para código, trabalho corporativo e agentes.
O Argon está em outra fase. A Google libera o modelo apenas para defensores cibernéticos de confiança do Fairwind e para os próprios times, enquanto conclui o processo voluntário de acesso pré-lançamento com o governo dos Estados Unidos e ajusta os guardrails com o retorno desses primeiros testadores. A abertura anunciada começa por clientes pagos de API e assinantes do Google AI Ultra, e só depois chega a desenvolvedores, empresas e consumidores em geral. Sem data. O anúncio diz “o mais rápido possível”, e é só isso.
Nenhuma das duas empresas publicou nota específica sobre o Brasil para esses dois modelos: o acesso segue a regra global de cada plano. Na prática, a diferença para quem está aqui é a moeda da fatura. A assinatura e a API da OpenAI são cobradas em dólar. O Google AI Ultra é vendido em reais, o que vai importar no dia em que o Argon entrar nele.
Se você tem entrega marcada para o último trimestre de 2026, a decisão já está tomada por você. Se pode esperar um ou dois trimestres, o quadro muda de figura.
Gemini 4 Argon ou GPT-6 Astra: qual escolher para cada caso de uso
Escolha o Gemini 4 Argon se você pode esperar o rollout e o seu trabalho é jurídico, financeiro, de automação, de migração de código ou de defesa cibernética; escolha o GPT-6 Astra se precisa de um modelo em produção antes do fim de 2026, de agente que opera interfaces ou de tarefa científica em terminal.
Escolha o Gemini 4 Argon se:
- Você mantém uma base de código grande e a fila é de refatoração, migração de linguagem ou reescrita de módulos inteiros, o trabalho em que a saída de 1 milhão de tokens rende
- Sua equipe é jurídica ou financeira e vai usar o modelo para rascunhar pesquisa e análise que um profissional revisa
- Você automatiza processos de negócio em várias etapas e aceita colocar um ponto de checagem humana no fluxo
- Seu agente lê e-mail, página web ou documento de terceiro, e a injeção de prompt é o seu maior medo
- Você paga a API em dólar, roda volume alto e um quinto do preço por token decide o orçamento do ano
- Você faz defesa cibernética e se qualifica para o Programa Fairwind
Escolha o GPT-6 Astra se:
- Você precisa de um modelo de fronteira em produção hoje, com harness maduro e acesso pelos canais que já usa
- Seu agente precisa clicar, digitar e navegar em software como uma pessoa faria
- Sua pesquisa vive no terminal, em ciência computacional ou em engenharia de fronteira, os três benchmarks que o Astra vence com folga
- Você já roda o Codex e trocar de fornecedor custaria mais que a diferença de preço
- Você precisa de resposta mais rápida e aceita pagar o dobro pelo modo acelerado
Procure outra coisa se:
- Sua fila é operação de shell no dia a dia ou engenharia de ML: o Claude Opus 5.5 lidera o Terminal-bench 4.0 e o PostTrainBench, à frente dos dois
- Você quer o Argon no assistente do navegador: ele ainda não chegou ao Google AI Ultra, e o plano hoje entrega os modelos anteriores
- Você precisa de GPQA Diamond ou MMLU para justificar a compra internamente: nenhuma das duas publicou esses números para o Argon
A escolha apertada é a do desenvolvedor de agentes de uso geral. Os benchmarks e o preço apontam para o Argon, o calendário aponta para o Astra, e a resposta honesta é que você provavelmente vai começar com um e migrar para o outro. Desenhe o agente com essa troca em mente desde o primeiro commit.
Perguntas frequentes sobre Gemini 4 Argon e GPT-6 Astra
Gemini 4 Argon já está disponível?
Não para o público. Em 30 de setembro de 2026, o Gemini 4 Argon roda apenas para defensores cibernéticos de confiança no Programa Fairwind e para times internos da Google. A empresa promete abrir o acesso começando por clientes pagos de API e assinantes do Google AI Ultra, sem data anunciada. O GPT-6 Astra, por comparação, está nos planos pagos do ChatGPT, na API e na AWS desde 4 de setembro de 2026.
GPT-6 Astra é gratuito?
Não. A OpenAI liberou o GPT-6 Astra para assinantes pagos em 4 de setembro de 2026, nos planos Plus, Pro, Business e Enterprise, além da API. O plano gratuito do ChatGPT não aparece na lista de acesso divulgada no lançamento, e a assinatura é cobrada em dólar, então câmbio e IOF entram por cima do valor de tabela.
Qual é o mais barato, Gemini 4 Argon ou GPT-6 Astra?
O Gemini 4 Argon é o mais barato na API, e por larga margem. No preço introdutório de setembro de 2026, ele custa um quinto do GPT-6 Astra por token de entrada e de saída, e um décimo no token em cache. Mesmo depois que a Google dobrar a tabela ao fim da fase introdutória, o Argon segue custando 40% do Astra. Na assinatura de consumidor, a comparação ainda não existe, porque o Argon não chegou ao varejo.
Gemini 4 Argon é melhor que GPT-6 Astra em programação?
Depende do tipo de tarefa. O Argon vence em engenharia de software de longo horizonte, a categoria do DeepSWE v1.1, e em migração de bases de código grandes. O Astra vence no FrontierSWE v2 por 10,5 pontos e em ciência no terminal. Nos demais benchmarks de código publicados em setembro de 2026, a diferença entre os dois é de décimos, e o Claude Opus 5.5 leva o Terminal-bench 4.0 e o PostTrainBench.
O que é o Programa Fairwind?
É o programa da Google que dá acesso antecipado ao Gemini 4 Argon a defensores cibernéticos de confiança. Para esse público qualificado, o modelo é liberado sem guardrails cibernéticos, com monitoramento de ativações internas e de cadeia de raciocínio para flagrar uso indevido. A Wiz, participante do programa, já usa o Argon no Scan for Good para proteger infraestrutura pública. A OpenAI tem um programa equivalente para o Astra, chamado Daybreak.
Vale a pena esperar o Gemini 4 Argon?
Compensa esperar se o seu volume de API é alto, se o trabalho é jurídico, financeiro ou de automação, ou se o agente vai ler conteúdo de terceiros e a injeção de prompt te preocupa. Não compensa se você tem entrega marcada para 2026, se precisa de uso de computador ou se a tarefa é científica em terminal. E há um risco que ninguém controla: o preço introdutório do Argon tem prazo, e a Google não diz qual.
GPT-6 Astra é AGI?
A própria OpenAI não afirma isso. No lançamento, em 3 de setembro de 2026, o presidente da empresa, Greg Brockman, disse que “não é descabido sentir que estamos agora na era da AGI” (tradução nossa), mas reconheceu que a chegada acontece de forma incremental, sem um marco único. O que existe de concreto é outra coisa: o Astra é o primeiro modelo da OpenAI a cruzar o nível Crítico de capacidade cibernética no Preparedness Framework, e é por isso que a versão ampla recusa tarefas avançadas de segurança.
Como testar os dois modelos e decidir na prática
Para testar os dois modelos e decidir na prática, monte um conjunto de 20 a 30 tarefas reais da sua fila, rode as duas APIs contra ele e meça custo por tarefa, e não preço por token. Benchmark de fabricante mede o que o fabricante escolheu medir. Sua fila é outra.
O roteiro cabe em quatro passos:
- Separe tarefas de verdade: um pull request antigo, um contrato já revisado, um relatório financeiro cujo resultado você conhece, um e-mail com instrução maliciosa escondida
- Registre tokens de entrada, de saída e em cache por execução, porque um modelo que pensa mais pode cobrar mais mesmo custando um quinto por token
- Repita cada tarefa mais de uma vez e olhe a variância antes de olhar a média
- Anote a data da tabela de preço que você usou, já que o valor introdutório do Argon acaba sem aviso de prazo
Enquanto o Argon não sai do Programa Fairwind, faça a bateria completa só no Astra e deixe o harness pronto para trocar o modelo com uma linha de configuração. No dia em que a API paga do Argon abrir, você roda o mesmo conjunto e compara em uma tarde.
Reavalie quando a Google dobrar o preço para US$ 4 e US$ 20. A conta que fecha hoje pode não fechar depois.
Se quiser ajuda para montar essa bateria de testes e escolher o modelo com dados da sua própria operação, fale com o time da AlphaCorp AI.