Neste artigo(16)
- Claude Opus 5.5 vs GPT-6 Sol: o que cada modelo é e por que a comparação não é direta
- Quanto custa cada modelo por milhão de tokens
- Preço em reais e o que muda para quem paga do Brasil
- Benchmarks do Claude Opus 5.5: os números que a Anthropic divulgou
- O que a OpenAI divulgou sobre o GPT-6 Sol e o GPT-6 Luna
- Custo por tarefa: o argumento da Anthropic contra a OpenAI
- Segurança, disponibilidade e onde usar cada modelo
- Qual é melhor: Claude Opus 5.5 ou GPT-6 Sol?
- Perguntas frequentes sobre Claude Opus 5.5 e GPT-6 Sol
- O GPT-6 Sol é o modelo mais forte da OpenAI?
- O Claude Opus 5.5 é melhor que o Fable 5.1?
- Quanto custa usar o Claude Opus 5.5 em reais?
- O GPT-6 Sol está no ChatGPT gratuito?
- Quando saem o Claude Sonnet 5.5 e o Haiku 5.5?
- Onde ver benchmarks independentes dos dois modelos?
- Como testar os dois modelos antes de escolher
O GPT-6 Sol custa a metade do Claude Opus 5.5 por token, e o Opus 5.5 é o único dos dois com uma tabela de benchmarks publicada. Esse é o resumo de Claude Opus 5.5 vs GPT-6 Sol: benchmarks, preços e qual é melhor, com os dois modelos lançados em 22 de setembro de 2026, a 90 minutos um do outro. Se você roda agentes de código longos, comece pelo Opus 5.5. Se paga por volume, comece pelo Sol. Nenhum teste independente coloca os dois na mesma tarefa ainda, então este artigo separa o que cada fabricante mediu, quanto cada um cobra em dólar e em real, e como medir o custo por tarefa na sua própria carga antes de assinar.
- US$ 2 de entrada e US$ 10 de saída por milhão de tokens no GPT-6 Sol, metade do GPT-5.6 Sol, na tabela de API da OpenAI de 22/09/2026
- US$ 4 de entrada e US$ 20 de saída no Claude Opus 5.5, 20% abaixo do Opus 5, na tabela de API da Anthropic de 22/09/2026
- 66,4% no Terminal-Bench 4.0 para o Opus 5.5, contra 55,8% do Fable 5.1, nos benchmarks divulgados pela Anthropic em 2026
- Cerca de metade dos erros do antecessor para o GPT-6 Sol, na avaliação interna de factualidade da OpenAI citada pelo TechCrunch em 2026
- Custo total 40% menor que o Opus 5 em cargas típicas, alegação da Anthropic reportada pela BNN Bloomberg em 2026
Claude Opus 5.5 vs GPT-6 Sol: o que cada modelo é e por que a comparação não é direta
O Claude Opus 5.5 e o GPT-6 Sol chegaram ao mercado no mesmo dia, 22 de setembro de 2026, e a comparação entre eles não é direta por dois motivos: nenhum dos dois é o modelo mais forte da própria empresa, e todo número público até agora saiu de avaliação interna de cada fabricante. Se você só quer a resposta curta: o GPT-6 Sol custa metade do preço por token, e o Opus 5.5 é o único dos dois com uma tabela de benchmarks publicada. Qual vence depende de você pagar a conta por token ou por tarefa concluída.
A Anthropic anunciou primeiro. Cerca de 90 minutos depois, a OpenAI colocou no ar o GPT-6 Sol e o GPT-6 Luna.
A página oficial do Claude Opus 5.5 compara o modelo ao Fable 5.1, o topo de linha da Anthropic, e afirma que ele iguala esse desempenho a um custo bem menor. Do outro lado, o anúncio do GPT-6 Sol e do GPT-6 Luna posiciona o Sol como a camada intermediária da família GPT-6. Acima dele fica o GPT-6 Astra, lançado em 3 de setembro de 2026. Abaixo fica o Luna, feito para tarefas administrativas de alto volume e sensíveis a custo. O Sol em si é vendido para codificação complexa e fluxos de trabalho com agentes.
Ou seja, esta é uma disputa entre o segundo modelo de cada casa. Colocar o Opus 5.5 contra o Astra contaria outra história, e o mesmo vale para Sol contra um Sonnet.
| Critério | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|
| Fabricante | Anthropic | OpenAI |
| Lançamento | 22/09/2026 | 22/09/2026 |
| Posição na família | abaixo do Fable 5.1 | entre o GPT-6 Astra e o GPT-6 Luna |
| Foco declarado | codificação, agentes e uso de computador | codificação complexa e fluxos com agentes |
| Entrada por milhão de tokens | US$ 4 | US$ 2 |
| Saída por milhão de tokens | US$ 20 | US$ 10 |
| Leitura de cache | US$ 0,20 | desconto de até 90% |
| Tabela de benchmarks publicada | Sim | Não |
| Avaliação externa antes do lançamento | METR e Frontier Design | não informado |
| Onde usar | API da Anthropic, AWS, Google Cloud e Azure | API da OpenAI, ChatGPT Work e Codex |
Aí vem a ressalva que sustenta o artigo inteiro. Até 22 de setembro de 2026, nenhuma organização independente publicou um teste que coloque os dois modelos no mesmo benchmark com a mesma metodologia. A Anthropic mede em Terminal-Bench, FrontierCode, GDPval-AA e OSWorld. A OpenAI cita uma avaliação interna de factualidade. São réguas diferentes, lidas por quem tem interesse no resultado. Trate cada número como alegação do fabricante até segunda ordem, e desconfie de qualquer site que já tenha um ranking fechado poucas horas depois do lançamento.
Quanto custa cada modelo por milhão de tokens
Em preço por token, o GPT-6 Sol ganha do Claude Opus 5.5 com folga: US$ 2 de entrada e US$ 10 de saída por milhão de tokens, contra US$ 4 e US$ 20 do Opus 5.5, nas tabelas de API publicadas em 22 de setembro de 2026. É exatamente a metade, nas duas pontas.
Os dois fabricantes cortaram preço em relação ao antecessor, mas em proporções bem diferentes:
- Claude Opus 5.5: US$ 4 de entrada e US$ 20 de saída, 20% abaixo dos US$ 5 e US$ 25 do Opus 5
- GPT-6 Sol: US$ 2 de entrada e US$ 10 de saída, metade dos US$ 4 e US$ 20 do GPT-5.6 Sol
- GPT-6 Luna: US$ 0,10 de entrada e US$ 0,50 de saída, o piso da família GPT-6
- Cache do Opus 5.5: leitura a US$ 0,20 (60% mais barata que no Opus 5) e escrita a US$ 5
- Cache da OpenAI: desconto de até 90% em leituras de tokens reaproveitados por agentes
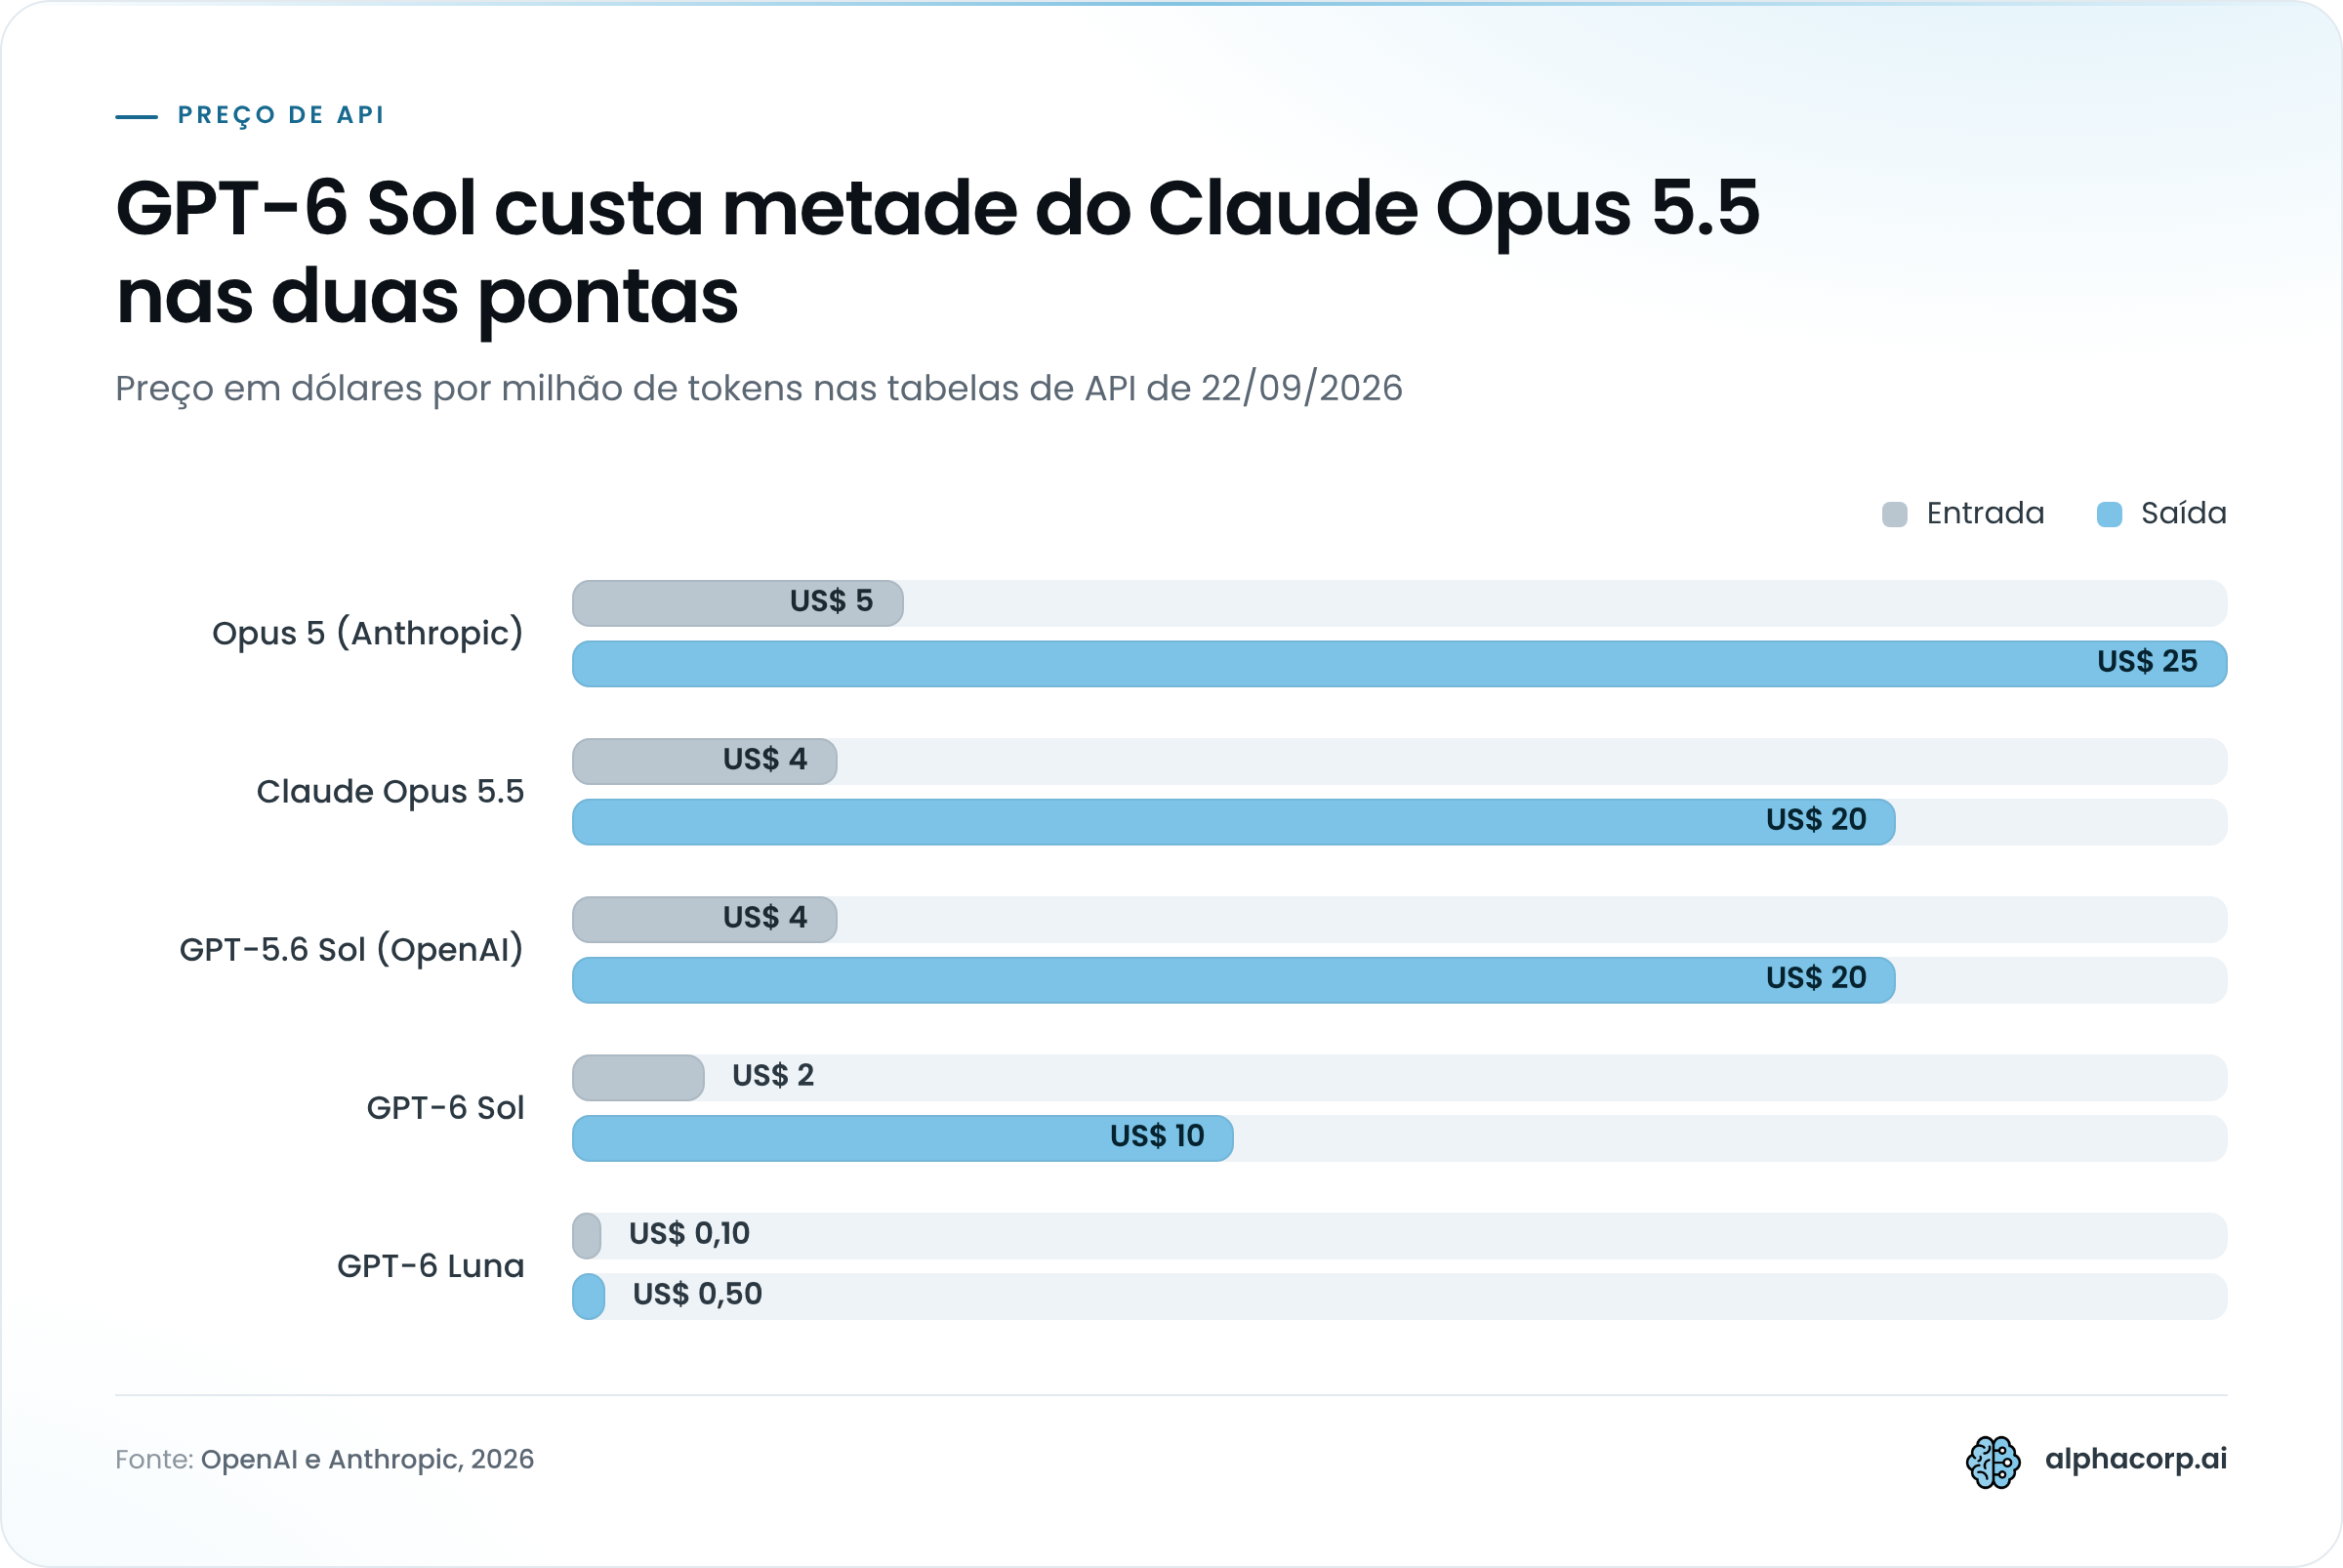
O que me chamou atenção foi a coincidência de números. O Opus 5.5 custa hoje, centavo por centavo, o que o GPT-5.6 Sol custava até ontem. A Anthropic desceu um degrau e a OpenAI desceu dois.
O cache muda a conta mais do que parece. Escrever no cache do Opus 5.5 custa US$ 5 por milhão de tokens, ou seja, mais caro que a entrada normal de US$ 4. Isso só compensa se o mesmo prefixo for relido várias vezes, e é exatamente o que acontece em agentes de IA que rodam em produção: o prompt de sistema e as definições de ferramenta voltam ao modelo a cada passo do loop, então a leitura a US$ 0,20 pesa mais na fatura do mês que o preço de entrada de tabela. Pela nossa experiência com agentes de dezenas de passos, quem ignora o cache paga a diferença sem perceber.
No lado da OpenAI, o desconto máximo de 90% leva os US$ 2 de entrada do Sol para US$ 0,20 na leitura em cache, o mesmo valor que a Anthropic cobra pela leitura no Opus 5.5. A palavra que importa nessa frase é "até": a OpenAI descreve o desconto como um teto, e a página oficial não detalha em que condições o agente recebe o valor cheio.
Duas ressalvas para fechar a conta. A Anthropic afirma que o custo total em cargas de trabalho típicas cai 40% em relação ao Opus 5, e esse número vai além do corte de 20% na tabela porque inclui o cache mais barato e a saída mais rápida. Já a OpenAI não publicou um número equivalente de custo total para o Sol.
Preço em reais e o que muda para quem paga do Brasil
Em reais, o GPT-6 Sol sai por cerca de R$ 10,22 de entrada e R$ 51,10 de saída por milhão de tokens, contra cerca de R$ 20,44 e R$ 102,20 do Claude Opus 5.5, pela cotação do dólar comercial do Banco Central em 22/09/2026, que fechou entre R$ 5,11 e R$ 5,13. Esses valores são referência para orçamento e nada mais. Nenhuma das duas empresas lista preço em real na página de API.
Na prática, funciona assim: a cobrança acontece em dólar, no cartão de crédito internacional ou na fatura da conta de API. O valor só vira real quando o banco converte, pela cotação do dia da conversão, e sobre essa operação em moeda estrangeira entram o IOF e, em muitos cartões, uma taxa de conversão própria. O número que chega na sua fatura vai ser maior que o da tabela. Quanto maior, depende do seu banco.
O câmbio também mexe no orçamento sem que o modelo mude de preço. Um projeto orçado hoje a R$ 5,12 por dólar pode custar mais em dezembro só porque o real andou, e o inverso também vale.
Três hábitos evitam surpresa:
- Orçar em dólar e acompanhar o consumo em dólar, convertendo só na hora de reportar
- Registrar a cotação usada em cada relatório, para o custo de setembro ser comparável ao de novembro
- Perguntar ao financeiro qual é a taxa total do cartão da empresa antes de fechar a estimativa
A conversão não altera a proporção entre os dois. Em real ou em dólar, o GPT-6 Sol continua custando a metade do Opus 5.5 por token, e a diferença em real cresce junto com o câmbio.
Benchmarks do Claude Opus 5.5: os números que a Anthropic divulgou
Nos quatro benchmarks que a Anthropic publicou em 22 de setembro de 2026, o Claude Opus 5.5 passa o Opus 5 e o Fable 5.1 em todos, e a maior distância aparece no Terminal-Bench 4.0: 66,4% contra 55,8% do Fable 5.1 e 52,3% do Opus 5. Os outros três testes apontam na mesma direção, com margens bem menores.
| Benchmark | Claude Opus 5.5 | Fable 5.1 | Opus 5 |
|---|---|---|---|
| Terminal-Bench 4.0 | 66,4% | 55,8% | 52,3% |
| FrontierCode v1.1 | 54,4% | 50,3% | 48,0% |
| GDPval-AA v2.1 | 1.846 Elo | 1.735 Elo | 1.708 Elo |
| OSWorld 2.0 | 81,8% | 80,7% | 74,0% |
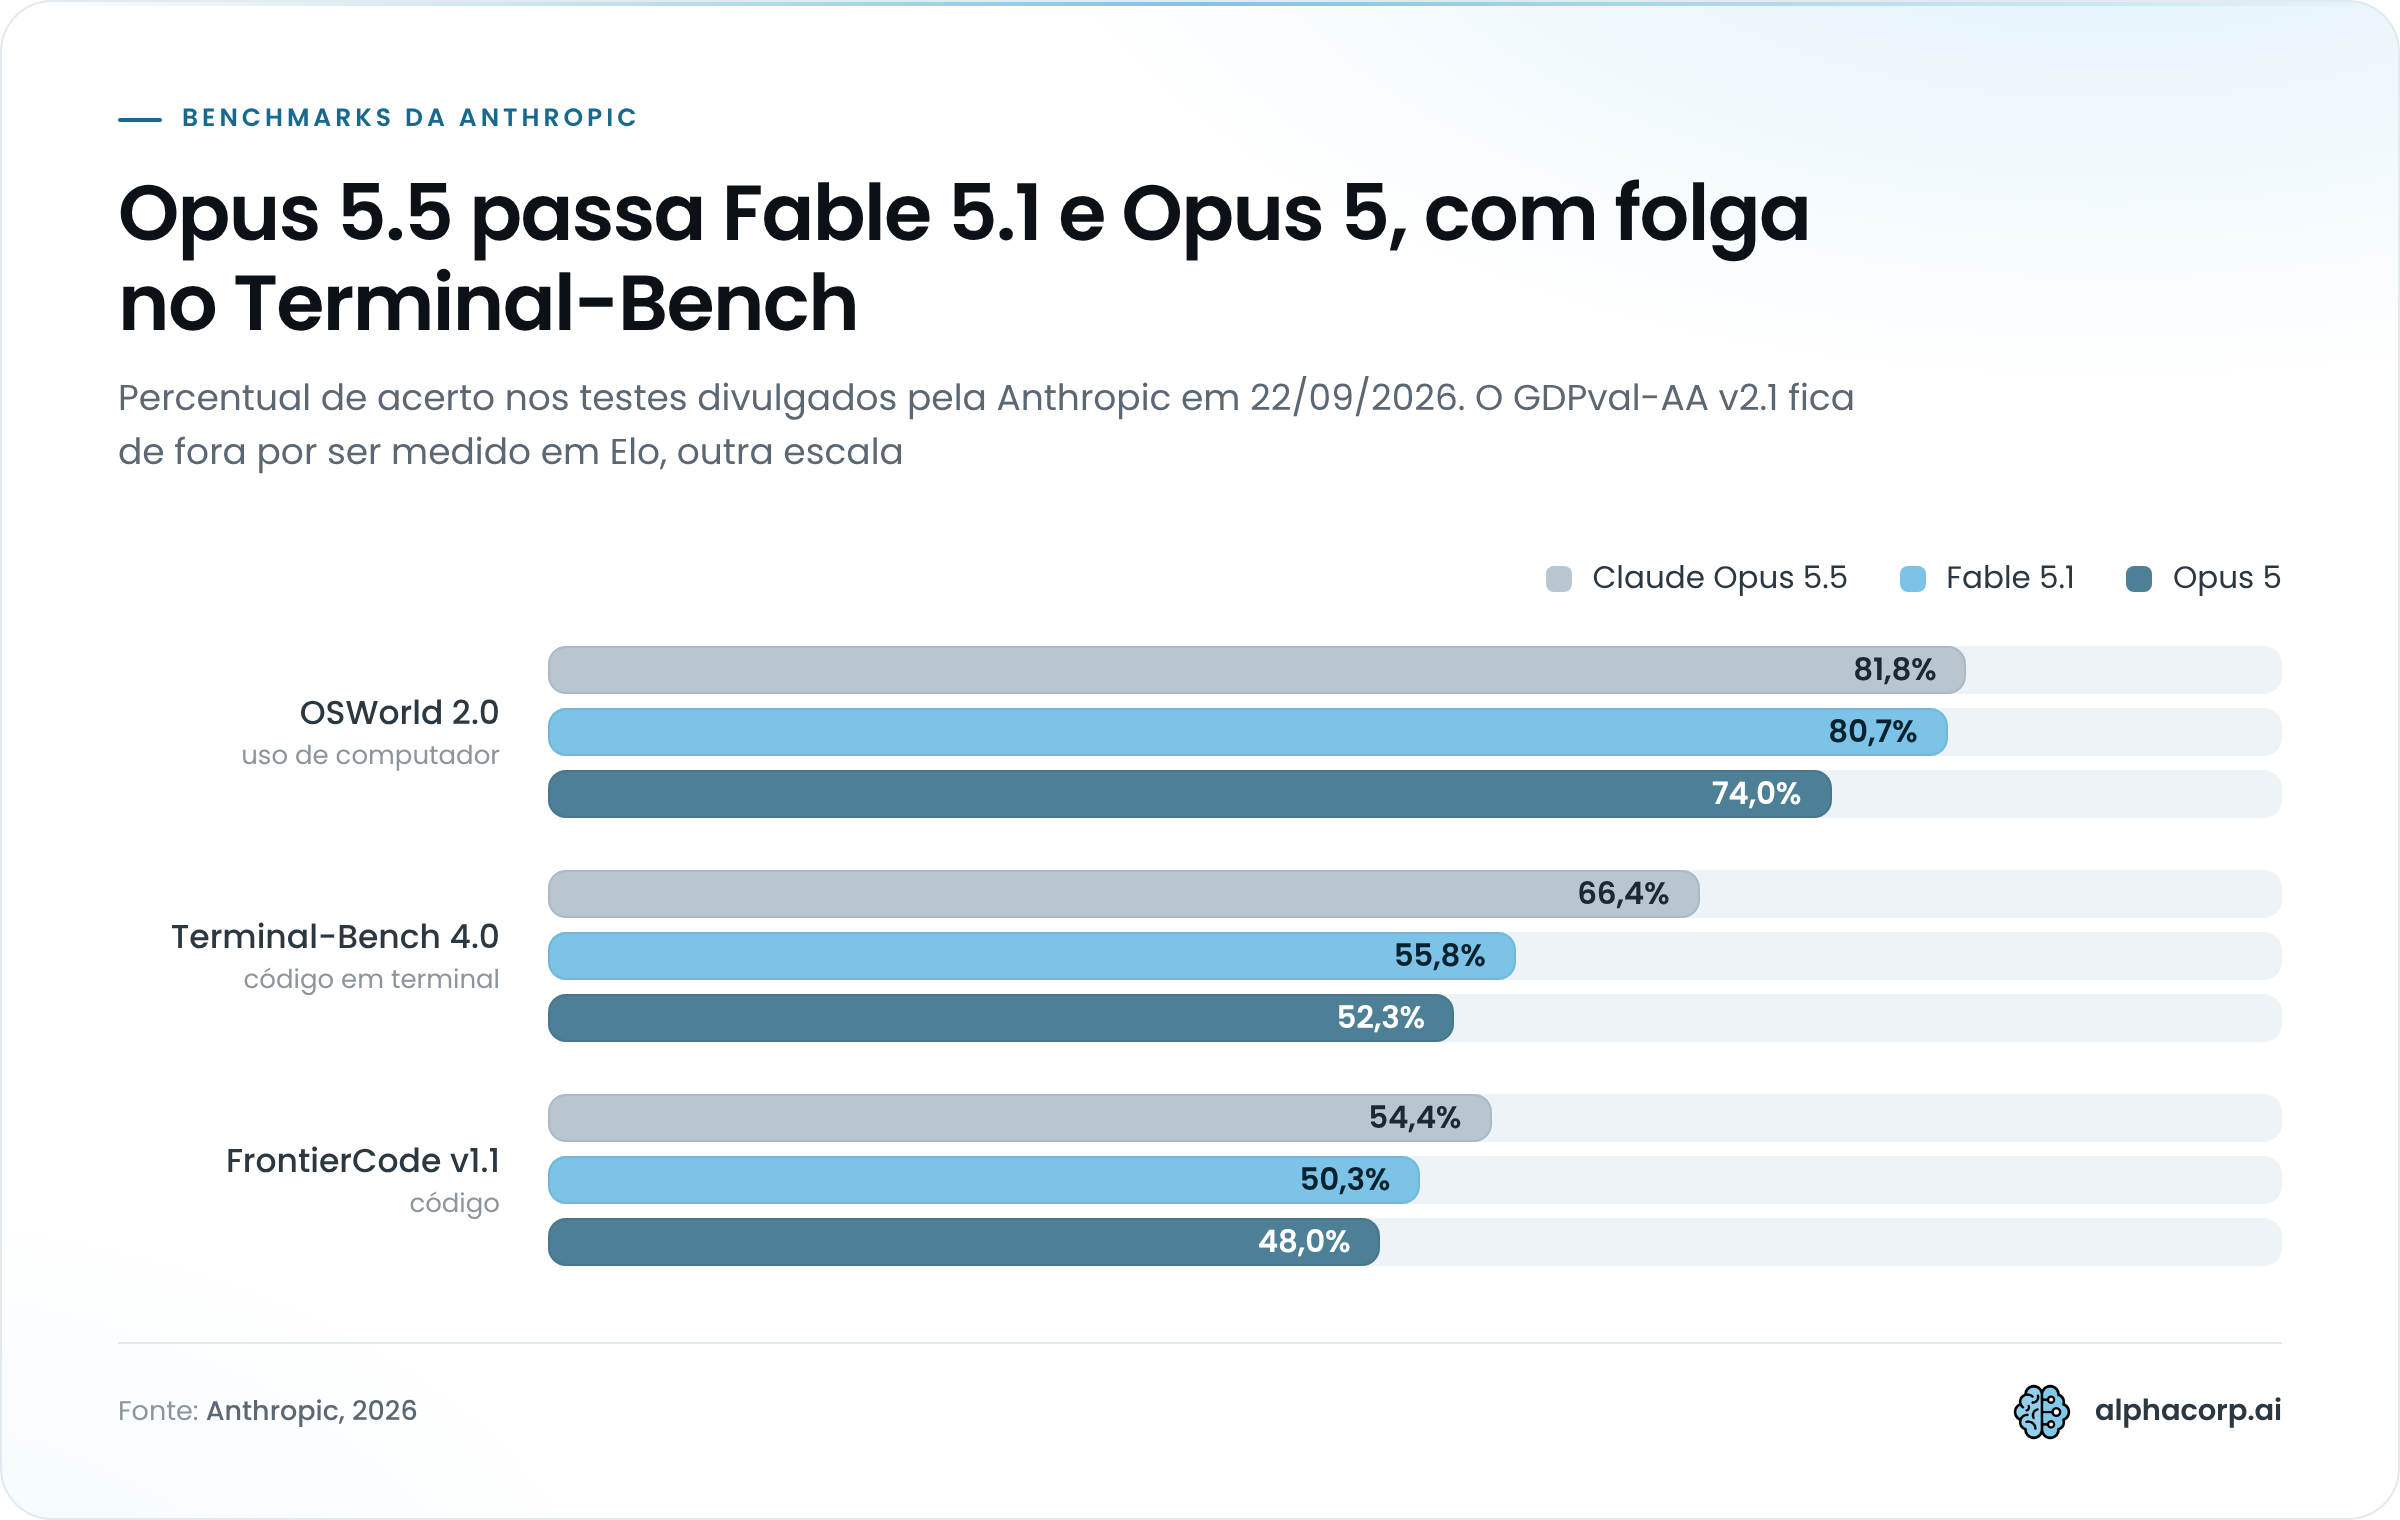
Repare na distribuição das vantagens. No Terminal-Bench, o salto sobre o Fable 5.1 é de 10,6 pontos. No OSWorld, o teste de uso de computador, a diferença cai para 1,1 ponto, e o ganho grande ali é sobre o Opus 5, que ficou em 74,0%. Na minha leitura, a Anthropic foi até modesta ao dizer que o Opus 5.5 "iguala" o topo de linha da casa: pela tabela, ele passa o Fable 5.1 nos quatro testes, e a empresa diz que faz isso por um custo bem menor.
Dois desses testes, Terminal-Bench e FrontierCode, cobrem código. O OSWorld cobre operação de computador. O GDPval-AA sai em Elo, uma pontuação relativa que sobe quando o modelo vence comparações com outros, então 111 pontos acima do Fable 5.1 significa uma taxa de vitória maior, sem dizer em quais tarefas.
A Anthropic completa a tabela com três casos de trabalho real, todos reportados pelo 9to5Mac no dia do lançamento:
- Migração de 680 mil linhas de código concluída em menos de um dia
- Auditoria de uma base de 200 mil linhas em 3 horas, contra mais de 20 horas com o Opus 5
- Tradução do HAProxy de C para Rust em 9,5 horas, contra 12 horas do Fable 5.1, com custo 51% menor
O caso do HAProxy é o mais útil dos três, porque compara tempo e dinheiro na mesma tarefa. Os outros dois medem só o relógio.
Aqui vai o momento de desconforto. Uma migração de 680 mil linhas fechada em menos de um dia é um número que eu não repetiria numa reunião de orçamento sem saber quantas dessas linhas passaram na suíte de testes depois, e a página da Anthropic não diz quem revisou o resultado nem quantos erros sobraram. O mesmo vale para a auditoria de 200 mil linhas: 3 horas em vez de 20 é um ganho real de tempo de máquina, e não diz nada sobre quantos problemas o modelo achou ou deixou passar. Os exemplos foram escolhidos por quem vende o modelo. São bons indícios e péssimas garantias.
O que a OpenAI divulgou sobre o GPT-6 Sol e o GPT-6 Luna
Sobre o GPT-6 Sol, a OpenAI publicou uma única medida de qualidade até 22 de setembro de 2026: na avaliação interna de factualidade da empresa, o modelo comete cerca de metade dos erros do GPT-5.6 Sol e chega ao nível de confiabilidade do GPT-6 Astra por um custo bem menor. Tabela com porcentagem por benchmark, como a da Anthropic, não existe na página oficial.
A frase completa, na declaração da OpenAI reproduzida pelo TechCrunch, é esta:
"GPT-6 Sol makes about half as many mistakes as its predecessor, reaching Astra-level reliability at much lower cost."
Em tradução livre: o GPT-6 Sol comete cerca de metade dos erros do antecessor e atinge confiabilidade de nível Astra a um custo muito menor.
O ponto é este: "metade dos erros" é uma medida relativa. Se você não sabe quantos erros o GPT-5.6 Sol cometia nessa avaliação, não sabe quantos o GPT-6 Sol comete. A OpenAI não publicou a base, o tamanho da amostra nem os domínios cobertos pelo teste. E o Sol foi anunciado para codificação complexa e fluxos com agentes, o mesmo terreno do Opus 5.5, mas a empresa escolheu destacar erros factuais em vez de resultado em código.
Sobre a família GPT-6 circulam pontuações de GPQA Diamond, FrontierMath e ARC-AGI, quase sempre atribuídas ao Astra, em sites agregadores de benchmark sem metodologia publicada. Elas não entram nesta comparação. Mesmo que fossem confiáveis, descreveriam o modelo de cima, e o Astra tem preço e posição diferentes do Sol.
O que a OpenAI detalhou melhor foi a infraestrutura em volta do modelo. O cache de prompts ganhou desconto de até 90% na leitura de tokens reaproveitados por agentes, e o anúncio oficial do GPT-6 Sol e do GPT-6 Luna trata esse cache como parte do argumento de custo, e o "até" continua sendo um teto sem condições publicadas.
O Luna cumpre outro papel. Ele é o modelo de entrada da família, feito para tarefas administrativas repetitivas em que o volume pesa mais que a inteligência por chamada: triagem, classificação, preenchimento, resumo em lote. Para quem compara Sol e Opus 5.5, o Luna serve como piso de referência e como candidato a absorver a parte barata de um fluxo, deixando o modelo caro só para o passo que exige raciocínio.
Custo por tarefa: o argumento da Anthropic contra a OpenAI
Em custo por tarefa, a Anthropic afirma que o Claude Opus 5.5 supera o GPT-6 Astra no Terminal-Bench 4.0 gastando entre 20% e 40% do custo por tarefa, e supera o GPT-5.6 Sol em benchmarks de desenvolvimento de software a cerca de um terço do custo de execução, segundo números da própria Anthropic publicados pela BNN Bloomberg em 22 de setembro de 2026. Nenhuma avaliação de terceiros confirma ou refuta a magnitude dessa vantagem.
Preço por token e custo por tarefa são contas diferentes. Explico: a fatura de um agente é o preço por token multiplicado pelos tokens consumidos até a tarefa terminar, e esse segundo fator varia muito entre modelos. Um modelo que resolve em 12 passos gasta menos que um que precisa de 30, mesmo cobrando o dobro por token. Cada tentativa errada que o agente refaz entra na conta. Cada releitura do prompt de sistema entra também, e é aí que o cache a US$ 0,20 muda o resultado.
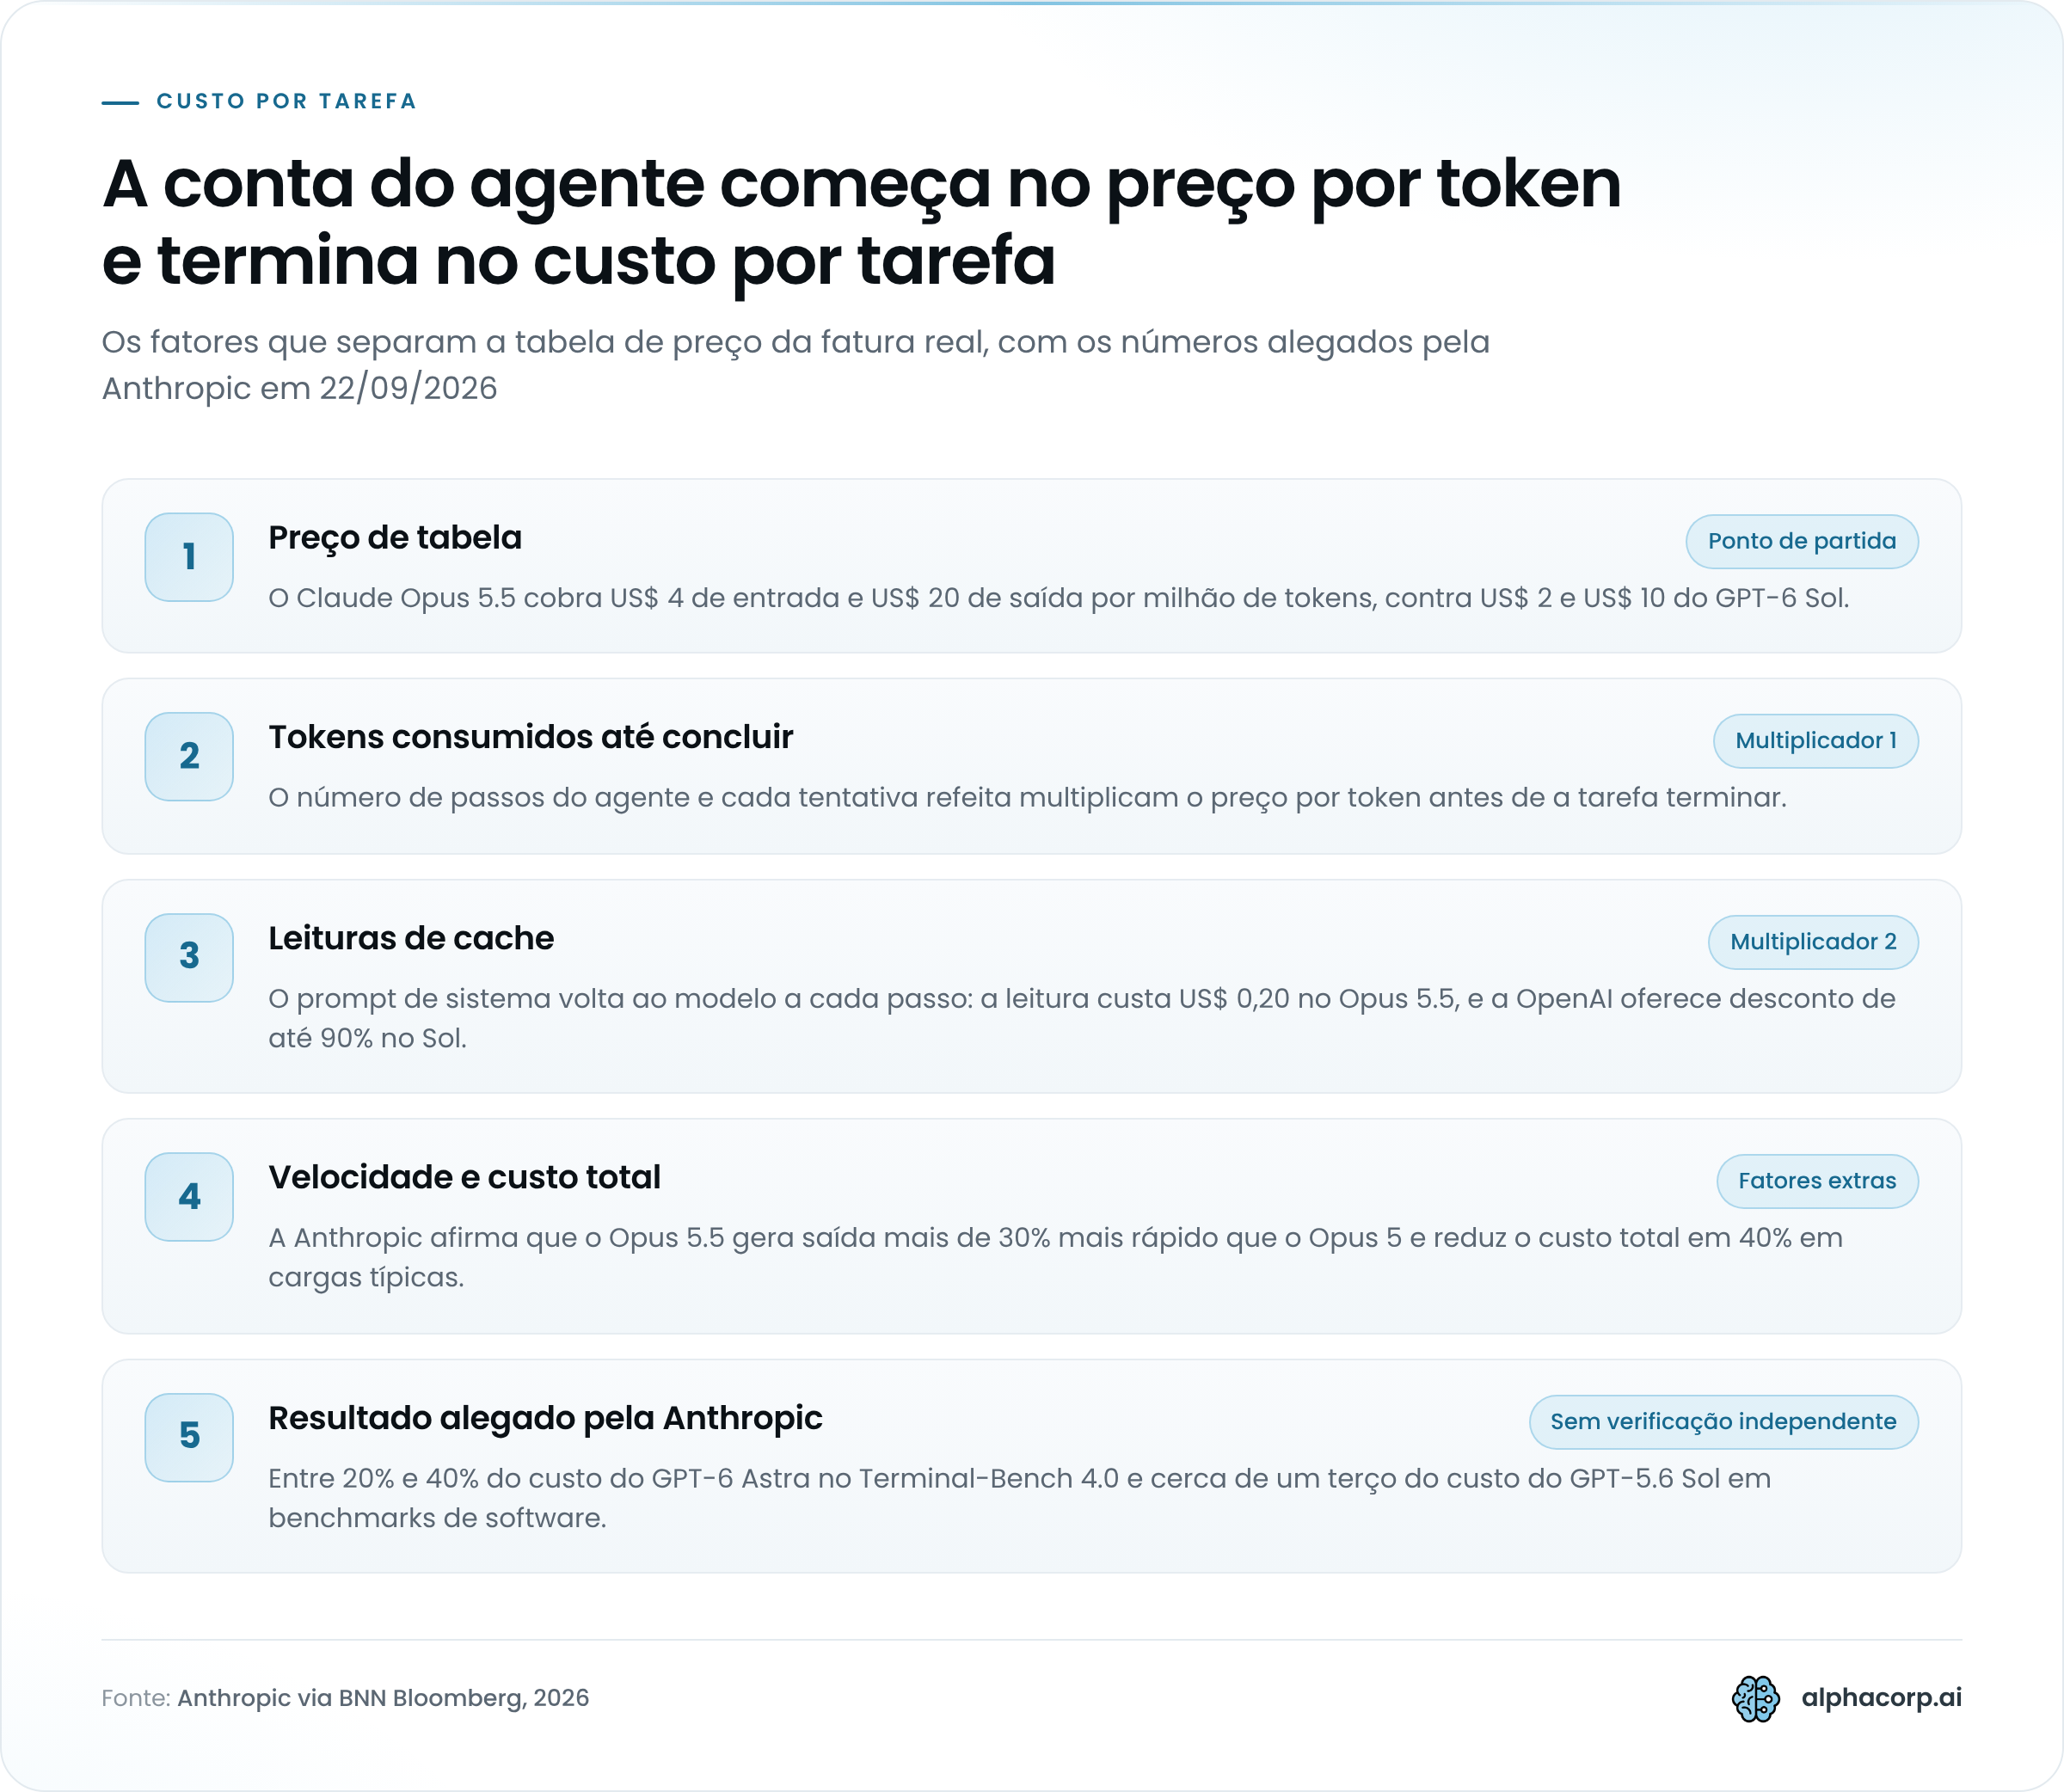
A velocidade entra por outro caminho. A Anthropic diz que o Opus 5.5 gera saída mais de 30% mais rápido que o Opus 5, e num agente que roda passos em sequência isso vira mais tarefas por hora com a mesma infraestrutura em volta. A queda de 40% no custo total em cargas típicas, também alegada pela empresa, soma cache mais barato, tabela 20% menor e esse ganho de tempo. É o número que a Anthropic quer que você leve para a reunião.
Só que a comparação tem um alvo deslocado. A Anthropic mediu contra o GPT-6 Astra e contra o GPT-5.6 Sol. O GPT-6 Sol, lançado 90 minutos depois, não aparece em nenhuma dessas contas, e ele custa exatamente a metade do GPT-5.6 Sol por token. Uma conta de padeiro, e nada mais que isso: se o GPT-6 Sol consumisse os mesmos tokens por tarefa que o antecessor, o corte de preço sozinho encolheria a vantagem da Anthropic de "um terço do custo" para algo perto de dois terços. Se a OpenAI estiver certa sobre metade dos erros, o consumo por tarefa também cai, e a distância fecha mais. Ninguém mediu isso ainda.
Vale lembrar também que o Terminal-Bench é a régua escolhida pela Anthropic, aplicada por ela mesma. Custo por tarefa é a métrica certa, e é a que medimos em toda avaliação de prontidão para IA antes de indicar um modelo, mas só vale quando alguém sem interesse no resultado roda os dois modelos na mesma tarefa, com o mesmo prompt e a mesma definição de "concluído". Até 22 de setembro de 2026, esse alguém não apareceu.
Segurança, disponibilidade e onde usar cada modelo
Em segurança, o Claude Opus 5.5 é o único dos dois com avaliação externa antes do lançamento: a METR e a Frontier Design testaram o modelo, e a Anthropic afirma que ele tem probabilidade cerca de 85% menor que o Opus 5 de tentar contornar limites de contenção, segundo a cobertura da CNN Brasil de 22 de setembro de 2026. Para o GPT-6 Sol, a OpenAI não publicou avaliação equivalente nem nome de auditor externo.
O número de 85% vem de teste interno. A Anthropic também diz que o Opus 5.5 teve o melhor resultado entre todos os Claude já lançados na auditoria comportamental da própria empresa, que roda quase 2.000 cenários simulados. Auditoria da casa mede o que a casa decidiu medir. A presença da METR e da Frontier Design pesa mais que o percentual, porque são organizações sem receita atrelada ao lançamento, e o que elas concluíram a Anthropic não detalhou na página do modelo.
O contexto deixa esse ponto menos neutro. Poucas semanas antes do lançamento, o CEO Dario Amodei publicou um ensaio pedindo que o setor desacelerasse o ritmo de novos modelos, com apoio público de executivos de outras empresas. Aí a própria Anthropic lançou um modelo mais capaz. Dá para ler a ênfase em segurança como resposta a essa contradição, e dá para ler como prática que já existia. As duas leituras cabem.
Na disponibilidade, os caminhos divergem:
- Claude Opus 5.5: API da Anthropic, Amazon Web Services, Google Cloud e Microsoft Azure desde 22/09/2026
- GPT-6 Sol: API da OpenAI, ChatGPT Work e Codex para contas Plus, Pro, Business, Enterprise e Edu
- GPT-6 Luna: os mesmos canais do Sol, mais o aplicativo de desktop para os planos gratuito e Go
Para uma empresa, a diferença que importa é a das nuvens. Se o contrato de infraestrutura já está na AWS, no Google Cloud ou no Azure, o Opus 5.5 entra pela conta que já existe, com faturamento e controle de acesso que o time de infraestrutura conhece. O GPT-6 Sol sai pela API da OpenAI e pelos produtos da própria empresa. Para quem usa o modelo pela interface, o Sol leva vantagem: chegou ao ChatGPT Work e ao Codex no dia do lançamento, enquanto o Opus 5.5 aparece nas páginas oficiais como modelo de API e de nuvem.
Qual é melhor: Claude Opus 5.5 ou GPT-6 Sol?
O Claude Opus 5.5 é melhor para agentes de código longos e uso de computador, segundo os benchmarks do próprio fabricante, e o GPT-6 Sol é melhor para quem paga por token e roda alto volume, porque custa a metade. Até 22 de setembro de 2026, nenhum teste independente coloca os dois na mesma tarefa.
Critério a critério, o placar fica assim:
- Preço por token: GPT-6 Sol, com folga e sem discussão
- Desempenho em código e agentes: Opus 5.5, pela única tabela de benchmarks publicada, medida pela Anthropic
- Factualidade: o Sol reivindica metade dos erros do antecessor, em avaliação interna sem base divulgada
- Custo por tarefa: alegação da Anthropic contra outros modelos da OpenAI, sem medição contra o Sol
- Segurança: Opus 5.5, por ter auditores externos nomeados
- Distribuição em nuvem: Opus 5.5, presente em AWS, Google Cloud e Azure
Escolha o Claude Opus 5.5 se: seu caso de uso é um agente que roda dezenas de passos sobre uma base de código, com prompt de sistema longo relido a cada passo. Também se a empresa já compra nuvem de AWS, Google Cloud ou Azure e quer o modelo na mesma fatura. E se o comitê de risco pede nome de auditor externo antes de aprovar qualquer modelo em produção.
Escolha o GPT-6 Sol se: o orçamento de API é o limite e o volume é alto, como triagem de tickets, geração de resumos ou classificação em lote com milhões de tokens por dia. Também se a equipe já vive no ChatGPT Work ou no Codex e quer o modelo novo sem trocar de ferramenta. E se erros factuais doem mais no seu produto que uma tarefa de código a menos por hora.
Procure outra coisa se: a tarefa é administrativa e repetitiva. O GPT-6 Luna custa uma fração do Sol e foi feito para isso. Se você pode esperar algumas semanas, o Claude Sonnet 5.5 e o Haiku 5.5 devem ocupar a mesma faixa do lado da Anthropic.
Se fosse meu orçamento e meu agente de código, eu começaria pelo Opus 5.5 e rodaria o Sol em paralelo por duas semanas, medindo o custo de cada tarefa concluída. A tabela de preço decide pouco. O consumo por tarefa decide quase tudo, e esse número só existe quando você mede na sua carga.
Perguntas frequentes sobre Claude Opus 5.5 e GPT-6 Sol
O GPT-6 Sol é o modelo mais forte da OpenAI?
Não. O topo de linha da OpenAI é o GPT-6 Astra, lançado em 3 de setembro de 2026. O Sol é a camada intermediária da família, voltada a codificação complexa e fluxos com agentes, e o Luna é a camada de baixo custo. A OpenAI diz que o Sol chega à confiabilidade do Astra em avaliação interna de factualidade, por um custo bem menor.
O Claude Opus 5.5 é melhor que o Fable 5.1?
Nos quatro benchmarks que a Anthropic publicou em 22 de setembro de 2026, sim, com margens pequenas em três deles e uma diferença de 10,6 pontos no Terminal-Bench 4.0. A própria empresa prefere dizer que o Opus 5.5 iguala o Fable 5.1 a um custo menor, e continua tratando o Fable 5.1 como seu modelo mais avançado.
Quanto custa usar o Claude Opus 5.5 em reais?
Cerca de R$ 20,44 por milhão de tokens de entrada e R$ 102,20 por milhão de tokens de saída, pela cotação do dólar comercial do Banco Central em 22/09/2026, entre R$ 5,11 e R$ 5,13. A cobrança é em dólar, e IOF, câmbio do dia e taxa do cartão entram por cima. A Anthropic não publica preço em real.
O GPT-6 Sol está no ChatGPT gratuito?
Não. O Sol está disponível para contas Plus, Pro, Business, Enterprise e Edu no ChatGPT Work e no Codex, além da API. Quem usa o plano gratuito ou o Go recebe o GPT-6 Luna no aplicativo de desktop.
Quando saem o Claude Sonnet 5.5 e o Haiku 5.5?
Nas próximas semanas, contadas a partir de 22 de setembro de 2026, segundo a Anthropic. A empresa não divulgou data nem preço para nenhum dos dois. Se o seu caso de uso é de alto volume, vale segurar a decisão até eles chegarem, porque a comparação justa com o Sol e com o Luna vai ser contra esses modelos, e não contra o Opus.
Onde ver benchmarks independentes dos dois modelos?
Em lugar nenhum ainda. Até 22 de setembro de 2026, os únicos números públicos são os de cada fabricante, e as avaliações externas da METR e da Frontier Design no Opus 5.5 cobrem segurança, e não desempenho contra concorrentes. Rankings que apareceram poucas horas após o lançamento em sites agregadores não publicam metodologia. Quando um teste sério sair, ele vai trazer o prompt usado, a definição de tarefa concluída e o custo por tarefa dos dois modelos lado a lado. Sem esses três itens, é ranking de marketing.
Como testar os dois modelos antes de escolher
Para testar o Claude Opus 5.5 e o GPT-6 Sol antes de escolher, rode as mesmas cinco ou dez tarefas reais nos dois, com o mesmo prompt, e some o custo de cada tarefa concluída em vez de olhar o preço por token. É o único teste que existe hoje sem interesse no resultado, porque quem roda é você.
Quatro passos bastam:
- Separe tarefas da sua carga, com uma definição escrita de "concluído" que o time aceite antes de começar
- Ative o cache nos dois desde o primeiro dia, porque sem ele a fatura do Opus 5.5 e a do Sol não representam o uso em produção
- Registre tokens de entrada, saída e cache por tarefa, e converta para dólar só no fim
- Anote também tempo até concluir e quantas tentativas o agente refez, porque isso decide a conta mais que a tabela
Guarde os resultados. Nas próximas semanas devem chegar o Sonnet 5.5, o Haiku 5.5 e, com sorte, o primeiro teste independente com os dois modelos na mesma tarefa. Sua medição vai servir para conferir cada um deles contra a sua carga, e não contra a de alguém.
Se preferir montar essa bancada com quem já mede custo por tarefa em produção, fale com o time da AlphaCorp AI.