Neste artigo(18)
- Gemini 4 Argon vs Claude Fable 5.1: resumo do confronto em 2026
- Quanto custa o Gemini 4 Argon e o Claude Fable 5.1 na API?
- Preços das assinaturas no Brasil: Google AI Pro, Ultra e planos do Claude
- Benchmarks de Claude vs Gemini: a tabela comparativa do Google
- O que a Anthropic divulgou sobre o Claude Fable 5.1
- Por que a comparação de benchmarks é incompleta
- Codificação, cibersegurança e trabalho corporativo: onde cada modelo se destaca
- Janela de saída, contexto e segurança: diferenças técnicas que importam
- Disponibilidade: quem consegue usar cada modelo hoje
- Perguntas frequentes sobre Gemini 4 Argon e Claude Fable 5.1
- O Gemini 4 Argon já está disponível no Brasil?
- Qual é mais barato, Claude ou Gemini?
- Gemini 4 Argon é melhor que Claude para programar?
- O Google AI Ultra dá acesso ao Argon?
- O Claude Fable 5.1 está no Google Cloud?
- Quando o preço do Argon vai subir?
- Vale a pena esperar o Argon em vez de usar o Fable 5.1 agora?
- Como escolher entre os dois modelos agora
O Gemini 4 Argon lidera os benchmarks e custa cinco vezes menos por token, mas em 30 de setembro de 2026 só o Claude Fable 5.1 está disponível para contratar. Se você precisa de um modelo em produção agora, a resposta do confronto Gemini 4 Argon vs Claude Fable 5.1 é o Fable 5.1. Se o seu trabalho é cibersegurança ou automação corporativa e a fila do Google pode andar sem prejuízo para o seu prazo, o Argon compensa a espera. Abaixo você encontra os preços de API e de assinatura no Brasil, as duas tabelas de benchmark lado a lado e o motivo de o placar ser menos limpo do que parece.
Os números que decidem a comparação, todos de setembro de 2026:
- US$ 2 e US$ 10 por milhão de tokens de entrada e saída no Argon, em preço introdutório do Google, contra US$ 10 e US$ 50 no Fable 5.1, na tabela da Anthropic
- 13 de 19 benchmarks liderados pelo Argon na tabela comparativa publicada pelo Google, com o Fable 5.1 sem nenhuma liderança
- 51,3% contra 31,4% no AutomationBench, o único teste em que Google e Anthropic publicaram número para os próprios modelos
- 1 milhão de tokens de saída em uma resposta do Argon, contra 64 mil no limite anterior do Gemini, segundo o Google
- Cinco canais para o Fable 5.1 desde 1º de setembro de 2026, enquanto o Argon segue restrito ao Fairwind Program do Google
Gemini 4 Argon vs Claude Fable 5.1: resumo do confronto em 2026
Em 30 de setembro de 2026, o Claude Fable 5.1 é o modelo que você consegue usar hoje, e o Gemini 4 Argon é o modelo que vence a maior parte dos benchmarks publicados, mas que quase ninguém consegue acessar. Esse é o resumo honesto do confronto Gemini 4 Argon vs Claude Fable 5.1, e a decisão inteira gira em torno de uma pergunta só: você precisa do modelo esta semana ou pode esperar?
Os dois lançamentos aconteceram com um mês de diferença. A Anthropic anunciou o Claude Fable 5.1 em 1º de setembro de 2026, ao lado do Claude Mythos 5.1, como sucessor do Fable 5, com posicionamento em trabalho agêntico de longa duração, pesquisa científica e código. O Google respondeu em 30 de setembro com o Gemini 4 Argon, apresentado como seu modelo de fronteira mais capaz até então, com foco declarado em engenharia de software, trabalho corporativo em jurídico e finanças e defesa cibernética.
Veredito por critério, em uma linha cada:
| Critério | Quem leva | Motivo em uma linha |
|---|---|---|
| Preço na API | Gemini 4 Argon | Cobra uma fração do Fable 5.1 por token, ainda que em preço introdutório |
| Disponibilidade | Claude Fable 5.1 | Está em cinco canais; o Argon segue em programa fechado |
| Benchmarks | Gemini 4 Argon | Lidera a maior parte da tabela que o próprio Google publicou |
| Especialização | Depende do perfil | Argon em cibersegurança e automação; Fable 5.1 em pesquisa científica agêntica |
O ponto é este: só uma das duas empresas publicou números do concorrente. O Google mediu o Fable 5.1 na tabela dele. A Anthropic não mediu o Argon na dela, e nem poderia, porque o Argon não existia quando o Fable 5.1 saiu. Leia qualquer placar com esse desconto.
Na prática, o que vemos em times de engenharia e de segurança com orçamento de API para gastar em outubro de 2026 é uma escolha sem drama: comece com o Fable 5.1 e coloque o nome na fila do Argon. Quem faz automação corporativa ou remediação de vulnerabilidade tem motivo real para esperar. Quem precisa entregar agora não tem.
Quanto custa o Gemini 4 Argon e o Claude Fable 5.1 na API?
Na API, o Gemini 4 Argon custa US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída no preço introdutório de setembro de 2026, contra US$ 10 e US$ 50 do Claude Fable 5.1: o Argon sai cinco vezes mais barato, e ainda vai custar 2,5 vezes menos quando a promoção acabar.
| Item (por milhão de tokens) | Gemini 4 Argon (introdutório) | Gemini 4 Argon (após promoção) | Claude Fable 5.1 |
|---|---|---|---|
| Entrada | US$ 2 | US$ 4 | US$ 10 |
| Saída | US$ 10 | US$ 20 | US$ 50 |
| Leitura de cache | US$ 0,10 | não informado | US$ 0,25 |
| Escrita de cache | não informado | não informado | US$ 12,50 |
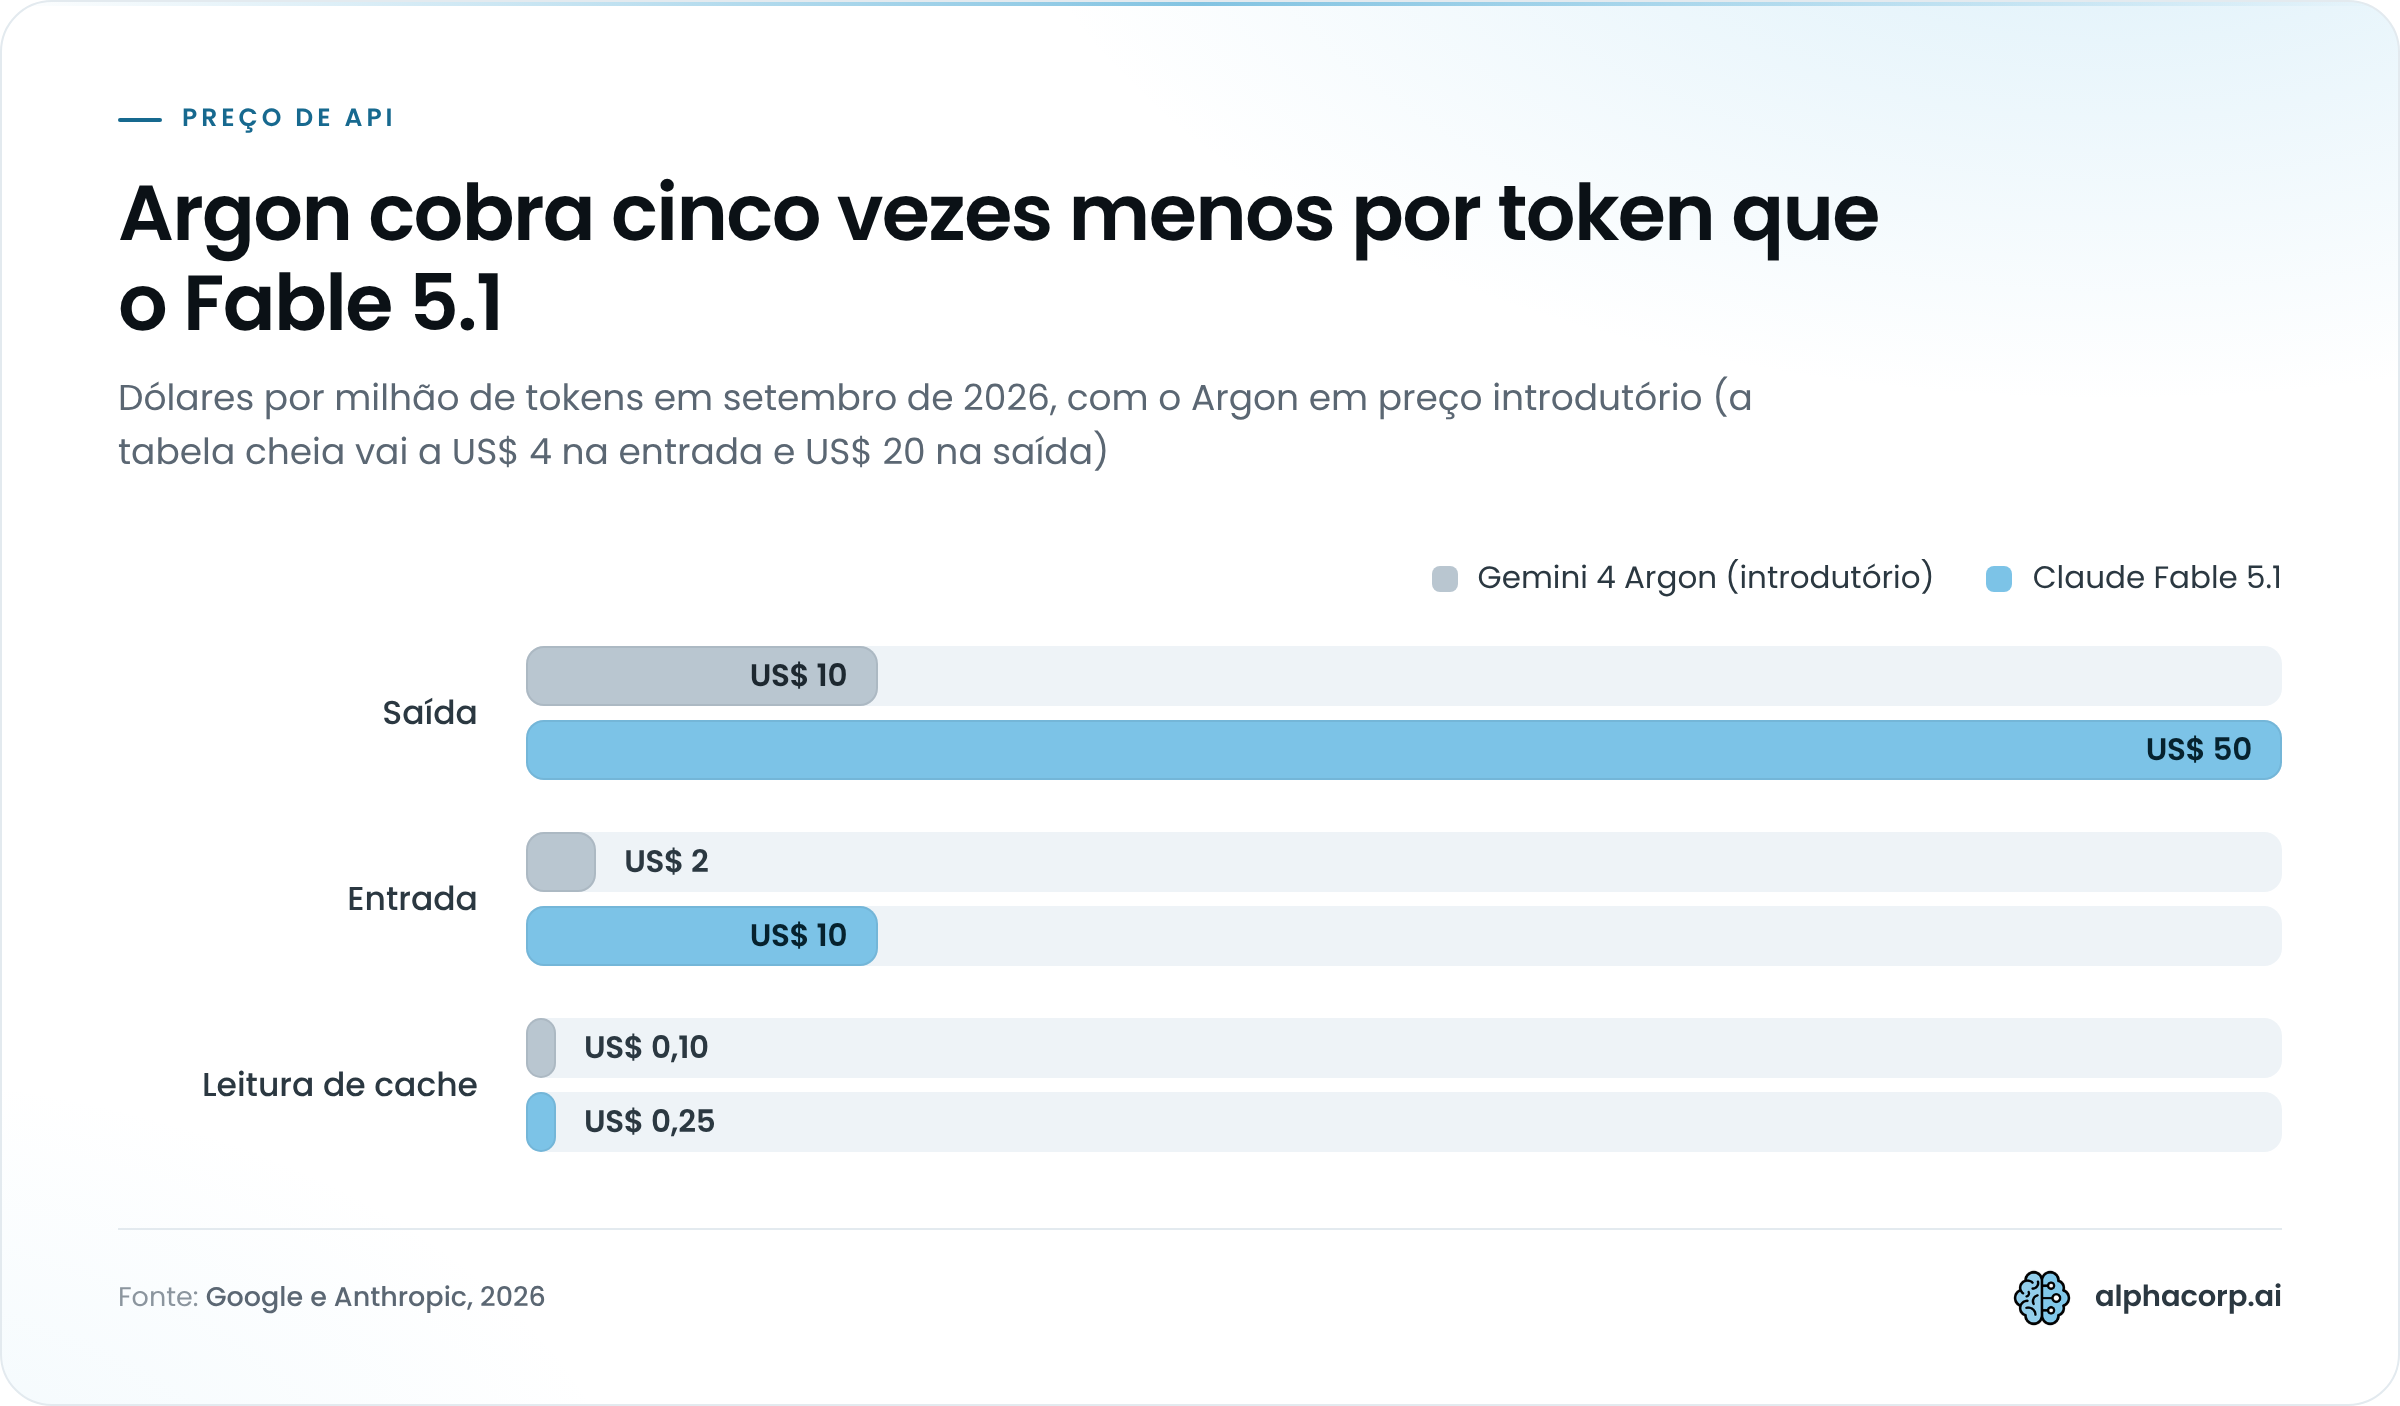
O Google diz que o preço introdutório do Argon é de US$ 2 na entrada e US$ 10 na saída, com 95% de desconto para entrada em cache, o que dá US$ 0,10 por milhão de tokens lidos do cache. Quando o período promocional terminar, a tabela sobe para US$ 4 e US$ 20. Não há data publicada para essa virada, e o preço do cache pós-promoção também não foi divulgado.
Do lado da Anthropic, a tabela oficial do Claude Fable 5.1 lista US$ 10 por milhão de tokens de entrada, US$ 50 de saída, US$ 0,25 na leitura de cache e US$ 12,50 na escrita. A leitura de cache caiu 75% em relação ao Fable 5, que cobrava US$ 1, e a Anthropic estima que essa queda reduz a conta em cerca de 25% em cargas típicas e em até 45% em tarefas agênticas intensivas. Inferência restrita a servidores nos EUA tem multiplicador de 1,1x por cima.
A diferença bruta é gritante. Só que ela encolhe conforme sua carga fica mais repetitiva. Explico: em um agente que relê o mesmo repositório ou o mesmo contrato a cada passo, a maior parte dos tokens é entrada repetida, e o que decide a fatura é a fração que vem do cache, e não o preço de lista. No cache, a distância entre os dois cai de 5x para 2,5x (US$ 0,10 contra US$ 0,25).
Na saída, porém, não há cache que salve: US$ 10 contra US$ 50 é a conta que você paga em toda geração longa. Para quem monta agentes que geram muito texto ou muito código em produção, esse é o número que mais pesa no fim do mês.
Dito isso, preço introdutório é promessa com prazo. Se você fizer a planilha com US$ 2 e US$ 10, refaça com US$ 4 e US$ 20 antes de assinar qualquer contrato de volume.
Preços das assinaturas no Brasil: Google AI Pro, Ultra e planos do Claude
No Brasil, em 30 de setembro de 2026, o Google cobra R$ 96,99 por mês pelo Google AI Pro e de R$ 779,90 a R$ 999,90 por mês pelo Google AI Ultra, enquanto o Claude Pro custa US$ 20 por mês e o Claude Max começa em US$ 100 por mês, cobrados em dólar. Nenhum desses planos dá acesso ao Gemini 4 Argon hoje.
A página brasileira de assinaturas do Google lista o AI Pro a R$ 96,99 mensais, com acesso ao Gemini 3.1 Pro, e o AI Ultra a partir de R$ 779,90, chegando a R$ 999,90 no nível superior, com acesso máximo ao Gemini 3 Pro. O nome Argon não aparece em lugar nenhum dessa página. O Google sinalizou no anúncio do modelo que assinantes do Ultra estarão entre os primeiros a receber o acesso, mas sinalizar e liberar são coisas diferentes, e até esta data só a segunda conta.
Os planos do Claude, em dólar:
- Gratuito: US$ 0
- Pro: US$ 20 por mês, ou US$ 200 por ano (equivalente a US$ 17 mensais)
- Max: a partir de US$ 100 por mês, com opções de 5x ou 20x mais uso que o Pro
A Anthropic não publica tabela em reais. O valor que cai na sua fatura depende do canal (site direto ou loja de aplicativos) e da cotação do dólar no dia da cobrança, então câmbio e impostos entram por cima de qualquer número acima. Irrita um pouco, porque o assinante brasileiro não consegue prever a mensalidade com precisão.
Para o leitor que só quer conversar com o modelo, a comparação hoje é desigual: o Claude Pro entrega o Fable 5.1 por US$ 20, e o plano mais caro do Google, a R$ 999,90, entrega um Gemini de geração anterior. Se o Argon chegar ao Ultra, esse quadro muda. Enquanto não chega, a assinatura do Google compra outra coisa.
Benchmarks de Claude vs Gemini: a tabela comparativa do Google
Na tabela de 19 benchmarks que o Google publicou em 30 de setembro de 2026, o Gemini 4 Argon lidera 13 linhas, empata em uma, e o Claude Fable 5.1 não lidera nenhuma. É o placar mais amplo de Claude vs Gemini que existe hoje. Também é o mais parcial, porque um dos dois lados mediu, escolheu os testes e publicou.
A tabela coloca quatro modelos lado a lado: Argon, GPT-6 Astra, Fable 5.1 e Claude Opus 5.5, este último lançado pela Anthropic em 22 de setembro de 2026. Os números abaixo são os do Google, transcritos sem ajuste.
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Vals Index | 68,9% | 63,1% | 65,8% | 67,0% |
| AutomationBench | 51,3% | 41,4% | 31,4% | 42,5% |
| Vals Finance Agent v2 | 65,4% | 53,5% | 58,9% | 58,6% |
| Harvey’s Legal Agent Benchmark | 19,6% | 5,4% | 6,7% | 3,8% |
| DeepSWE v1.1 | 77,9% | 74,1% | 67,4% | 74,2% |
| FrontierSWE v2 | 55,0% | 65,5% | 56,3% | 62,3% |
| Vibe Code Bench | 91,9% | 89,6% | 90,3% | 90,3% |
| Terminal-bench 4.0 | 57,4% | 58,2% | 57,9% | 66,4% |
| PostTrainBench | 45,3% | 44,3% | 40,2% | 49,3% |
| Terminal-Bench Science 0.1 | 57,6% | 68,1% | 52,6% | 63,3% |
| LABBench 2 | 88,8% | 85,4% | 68,6% | 73,1% |
| RiemannBench | 76,0% | 72,0% | 65,6% | 69,6% |
| GraphWalks até 128 mil tokens (F1) | 99,7% | 98,7% | 91,4% | 90,6% |
| GraphWalks de 256 mil a 1 milhão de tokens (F1) | 84,2% | 71,8% | 65,0% | 66,8% |
| Agent’s Last Exam | 39,5% | 34,2% | não informado | 38,2% |
| OSWorld-2.0 (subconjunto offline, parcial) | 69,2% | 72,6% | não informado | não informado |
| Chartography | 71,6% | 71,0% | 46,2% | 66,3% |
| LVBench | 91,7% | 87,5% | 79,7% | 83,7% |
| CWE-bench v1 | 68,0% | 68,0% | 58,0% | 67,0% |
Três coisas saltam dessa tabela.
A distância maior está em trabalho corporativo. No AutomationBench, o teste da Zapier que mede execução ponta a ponta de tarefas de negócio, o Argon marca 51,3% contra 31,4% do Fable 5.1, quase 20 pontos. No Harvey’s Legal Agent Benchmark, de pesquisa e redação jurídica, são 19,6% contra 6,7%, com os quatro modelos abaixo de 20%: nenhum deles resolve bem esse tipo de tarefa ainda, o Argon só erra menos. Chartography (71,6% contra 46,2%), LVBench (91,7% contra 79,7%) e o GraphWalks de 256 mil a 1 milhão de tokens (84,2% contra 65,0%) repetem o padrão em leitura de gráfico, vídeo longo e contexto longo.
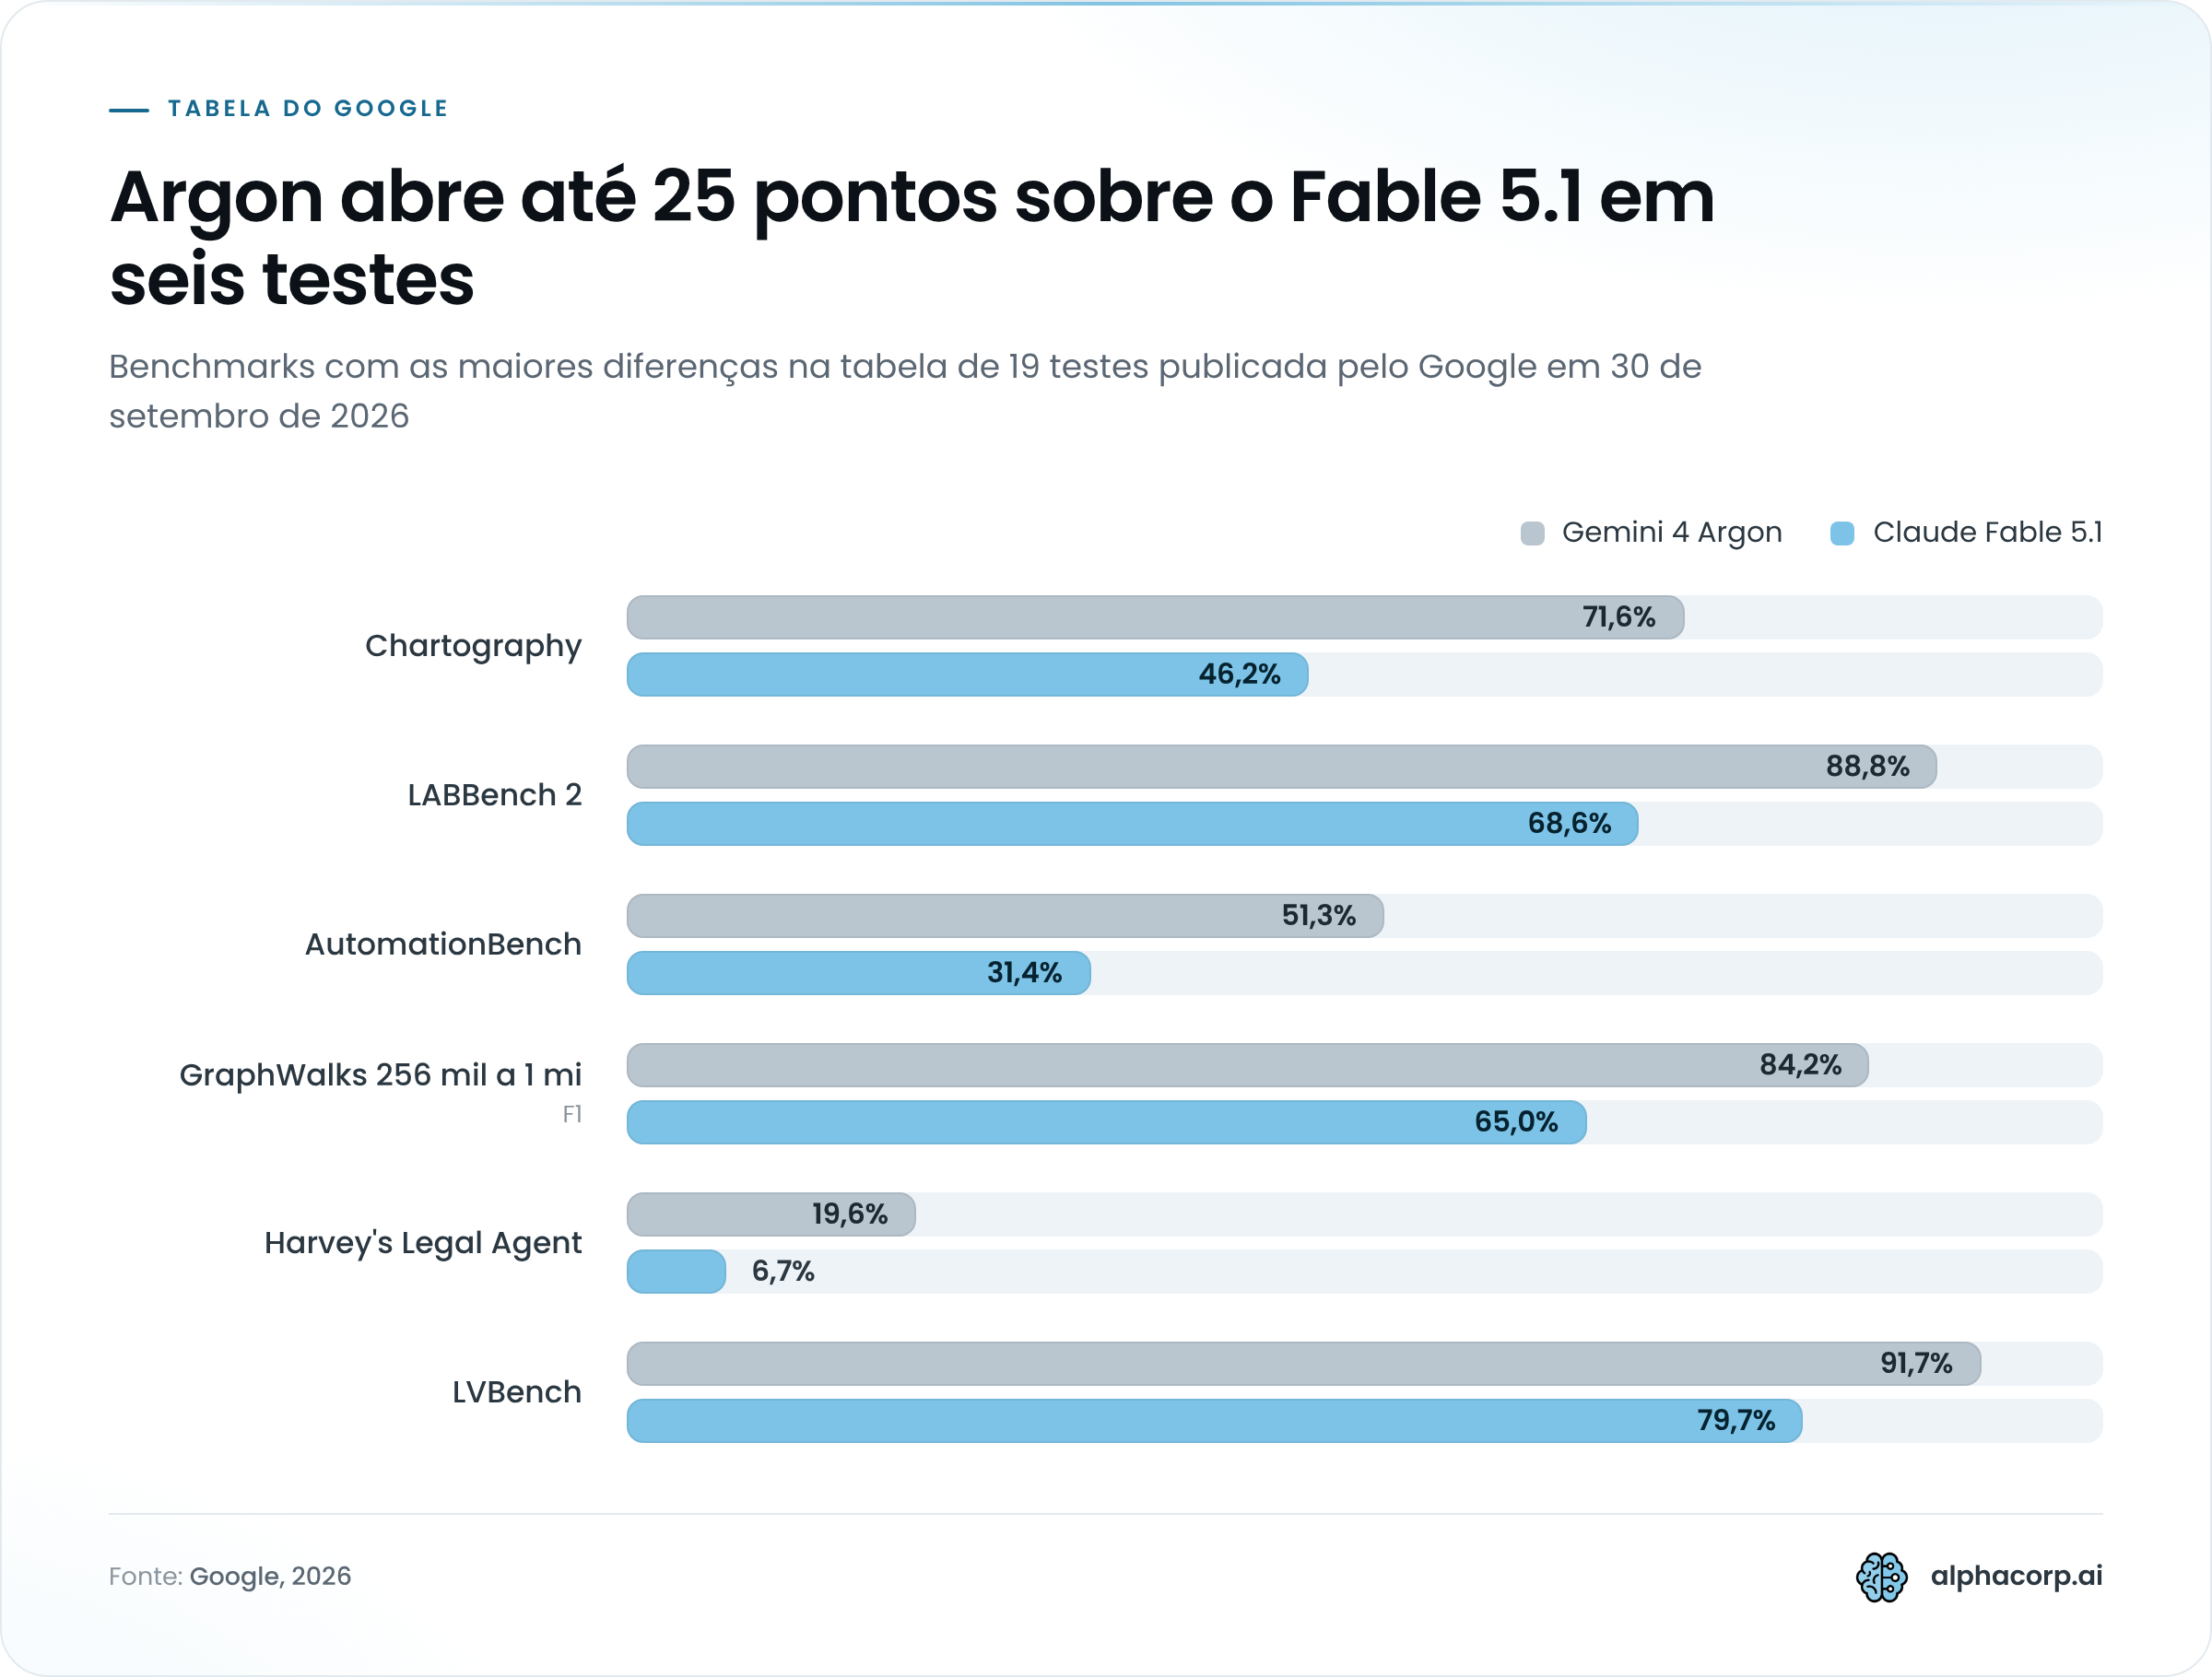
Em código, o quadro é apertado. No Terminal-bench 4.0 o Fable 5.1 fica em 57,9% contra 57,4% do Argon, meio ponto acima, e quem lidera a linha é o Opus 5.5 com 66,4%. No Vibe Code Bench são 90,3% contra 91,9%. No FrontierSWE v2 o Fable 5.1 marca 56,3% e o Argon 55,0%, com o GPT-6 Astra na frente dos dois, em 65,5%. A vantagem larga do Argon em código está em um teste só, o DeepSWE v1.1 (77,9% contra 67,4%), que mede tarefas longas de engenharia em repositórios reais.
Terceiro, e este ponto o Google não destaca: o Fable 5.1 perde do próprio irmão. Das 17 linhas em que os dois modelos da Anthropic têm número, o Opus 5.5 supera o Fable 5.1 em 13, empata em uma e perde em três (Vals Finance Agent v2, Harvey e GraphWalks até 128 mil tokens). Se você é cliente da Anthropic e quer o modelo que chega mais perto do Argon nessa tabela, esse modelo é o Opus 5.5.
O que a Anthropic divulgou sobre o Claude Fable 5.1
A Anthropic publicou, em 1º de setembro de 2026, nove resultados do Claude Fable 5.1 comparados ao Fable 5, ao Claude Opus 5 e ao GPT-5.6 Sol, e o Fable 5.1 vence os nove. O salto que mais chama atenção é em pesquisa científica agêntica: 52,6% no Terminal-Bench-Science 0.1, mais que o dobro dos 24,7% do Fable 5.
Os números da página de lançamento do Claude Fable 5.1 e do Claude Mythos 5.1:
| Benchmark | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52,6% | 24,7% | 29,0% | 22,4% |
| Terminal-Bench 4.0 | 55,8% | 42,0% | 52,3% | 37,3% |
| GDPval-AA v2 (Elo) | 1.853 | 1.723 | 1.824 | 1.711 |
| OSWorld 2.0 (parcial) | 77,9% | 72,9% | 75,4% | não informado |
| OSWorld 2.0 (rígido) | 41,7% | 36,1% | 39,6% | não informado |
| Humanity’s Last Exam (sem ferramentas) | 60,9% | 57,8% | 56,6% | não informado |
| Humanity’s Last Exam (com ferramentas) | 65,0% | 63,8% | 63,6% | não informado |
| AutomationBench | 31,4% | 17,1% | 26,9% | 19,6% |
| CursorBench 3.2.0 | 73,4% | 70,5% | 70,0% | 67,2% |
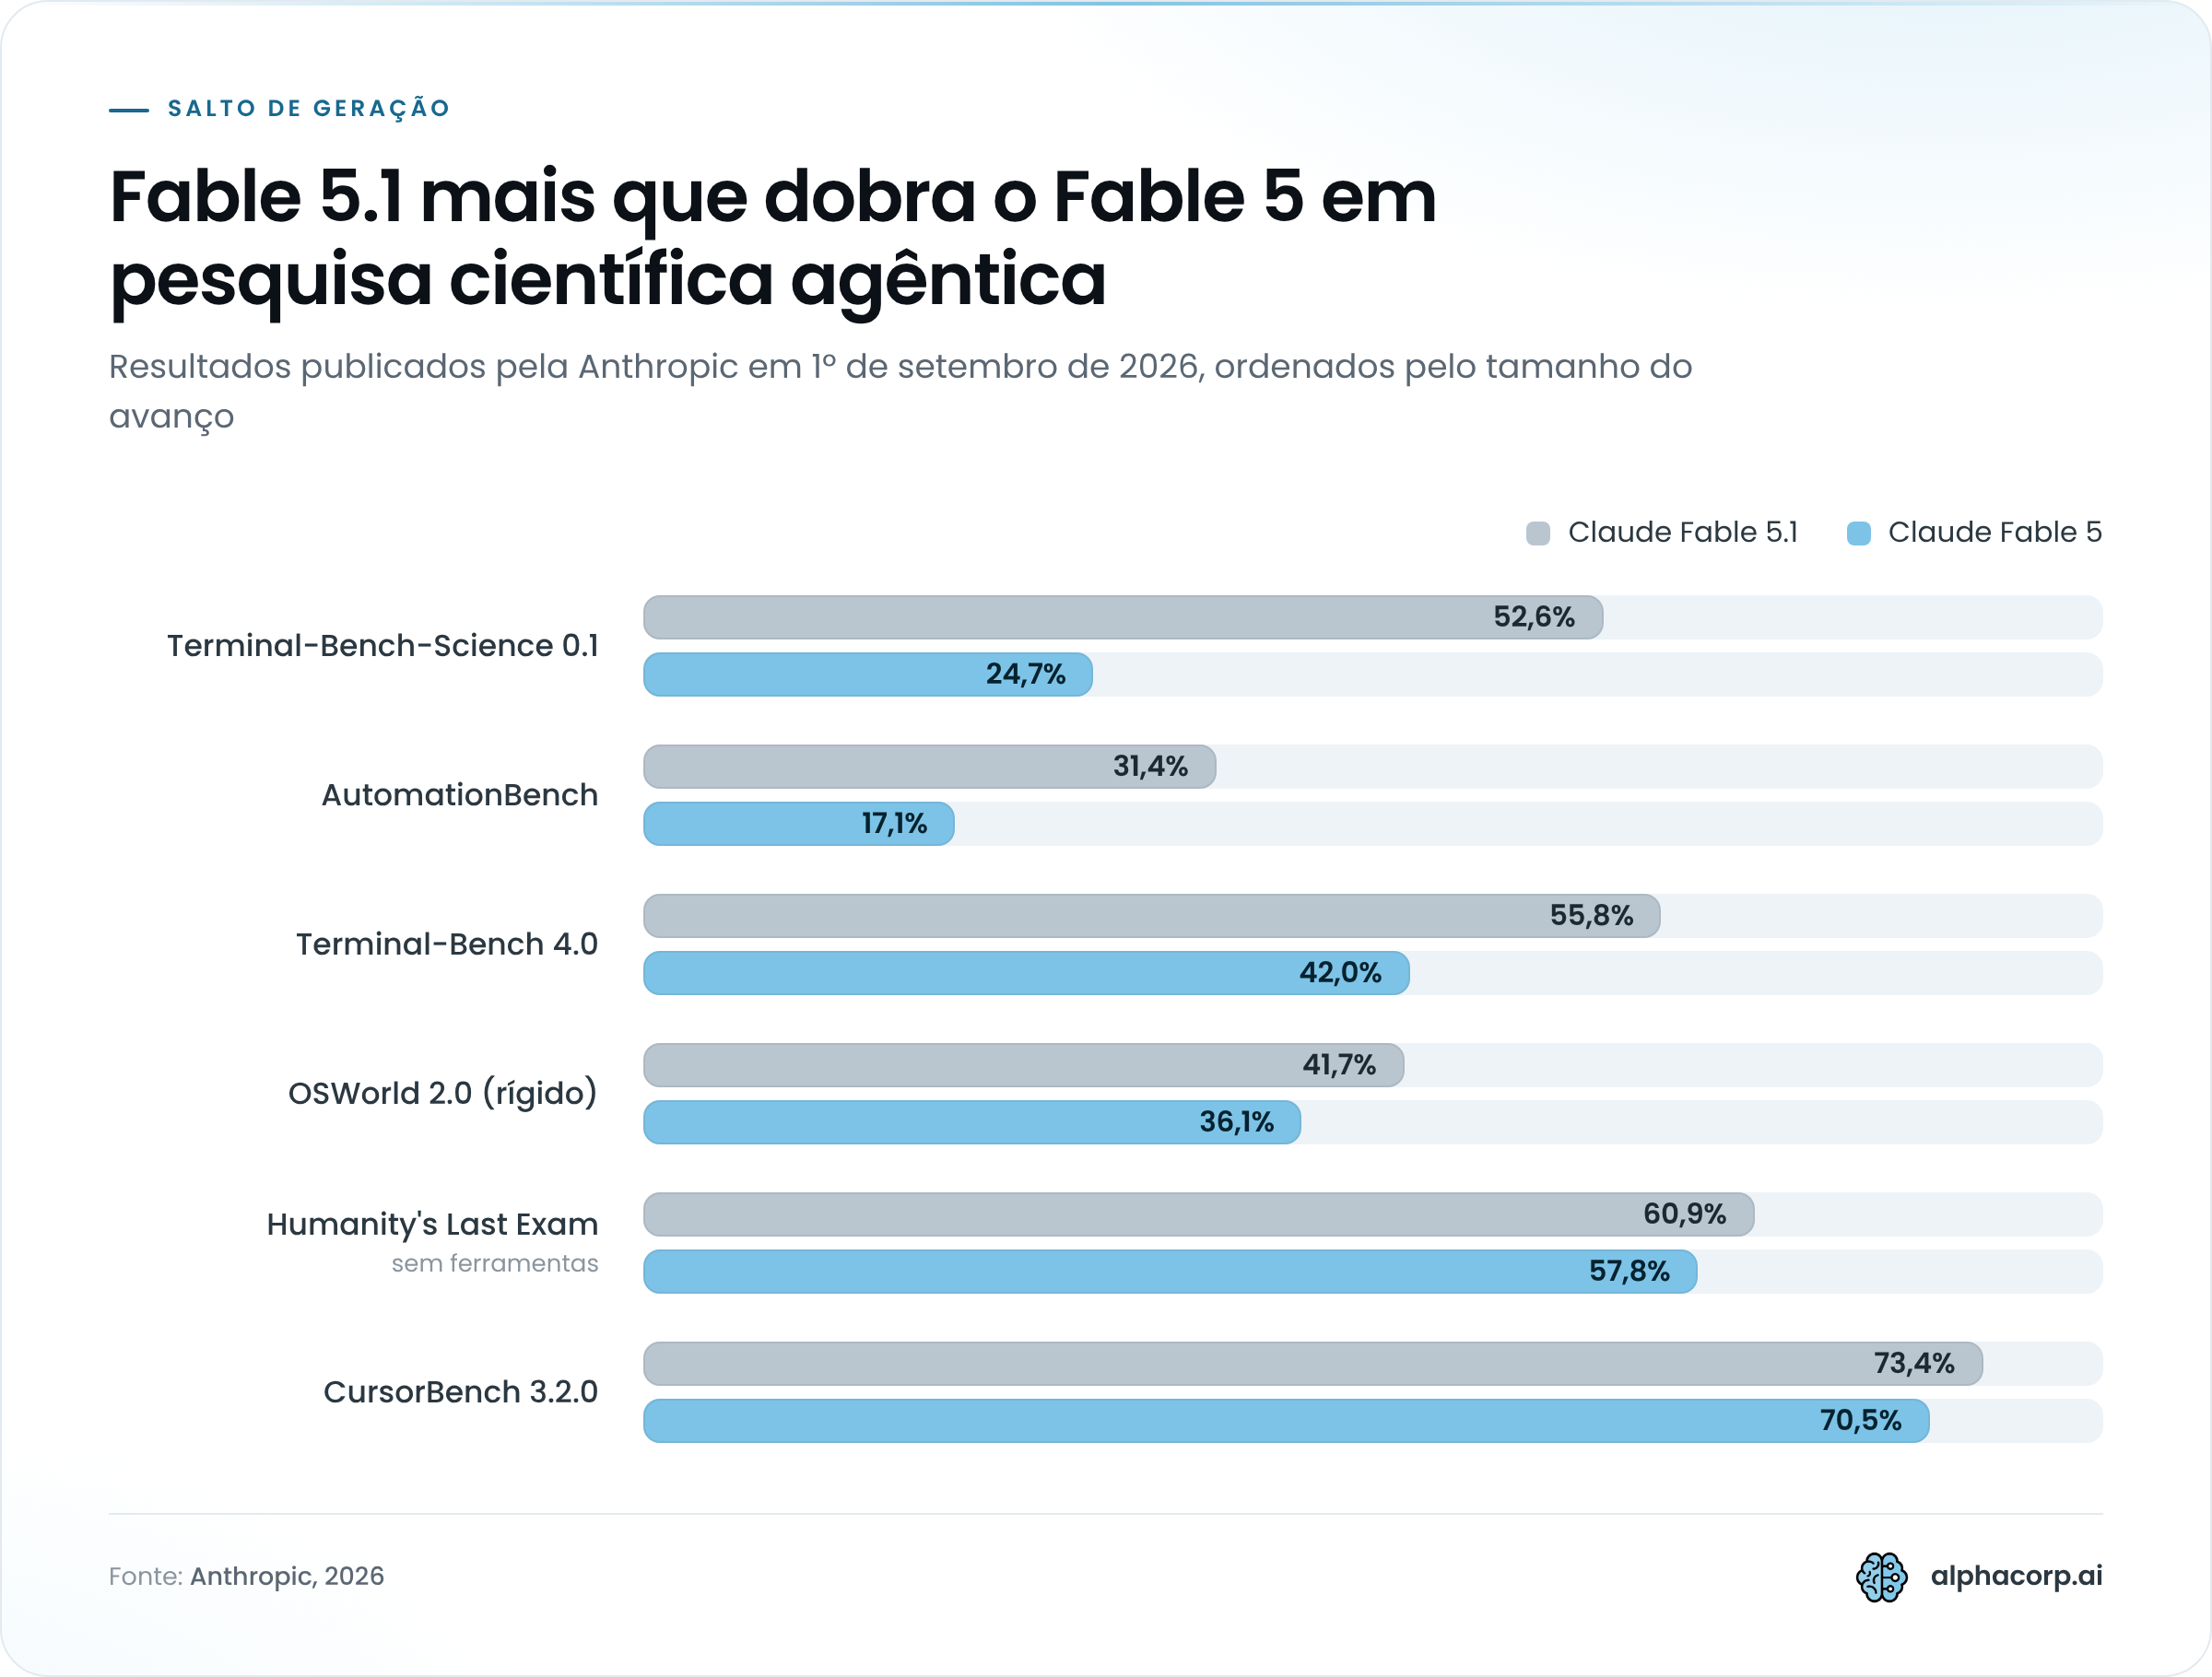
O que essa tabela conta é uma história de geração, e ela é boa. No Terminal-Bench 4.0, o Fable 5.1 sobe de 42,0% para 55,8% e passa o Opus 5, que estava em 52,3%: o modelo intermediário da linha ultrapassou o modelo topo da geração anterior em codificação agêntica. No AutomationBench, o salto é de 17,1% para 31,4%, quase o dobro. No GDPval-AA v2, escala Elo para trabalho de conhecimento, são 1.853 pontos contra 1.723 do Fable 5 e 1.824 do Opus 5.
Nos testes de conhecimento puro, o avanço é menor. No Humanity’s Last Exam, o Fable 5.1 marca 60,9% sem ferramentas e 65,0% com ferramentas, 3,1 e 1,2 pontos acima do Fable 5. O ganho grande está em agir, com terminal, sistema operacional ou editor de código, e menos em saber.
Repare nos pontos de referência. A Anthropic compara com o Opus 5 e com o GPT-5.6 Sol, a geração anterior de cada casa. O Google compara com o Opus 5.5 e com o GPT-6 Astra, a geração atual. Isso muda tudo na leitura: o Fable 5.1 vence os nove testes contra rivais mais velhos e não vence nenhum contra rivais da mesma safra.
Um alerta sobre o SWE-bench. O lançamento do Fable 5.1 não traz pontuação de SWE-bench Verified em destaque, algo que lançamentos anteriores da Anthropic sempre trouxeram. Números de SWE-bench atribuídos ao Fable 5.1 em agregadores de benchmark não constam de nenhuma página oficial da empresa e, ao que tudo indica, vieram da pontuação do Fable 5, de junho de 2026. Se alguém te mostrar um SWE-bench do Fable 5.1, pergunte de onde saiu.
Por que a comparação de benchmarks é incompleta
A comparação de benchmarks entre Gemini 4 Argon e Claude Fable 5.1 é incompleta porque todo número do Argon vem do Google, e os conjuntos de testes das duas empresas se cruzam em só quatro benchmarks. Vencedor, aqui, é sempre um recorte por tarefa.
Os quatro pontos de cruzamento e o que acontece em cada um:
- AutomationBench: 31,4% para o Fable 5.1 nas duas fontes. Os números coincidem
- Terminal-Bench Science 0.1: 52,6% para o Fable 5.1 nas duas fontes. Coincidem de novo
- Terminal-bench 4.0: 55,8% na página da Anthropic, 57,9% na tabela do Google. Divergem 2,1 pontos, a favor do Fable 5.1 no material do concorrente
- OSWorld 2.0: a Anthropic publica 77,9% na variante parcial e 41,7% na rígida. O Google mede um subconjunto offline e deixa a célula do Fable 5.1 sem número
Duas coincidências exatas dão alguma confiança de que o Google não maquiou o Fable 5.1 para baixo. A divergência no Terminal-bench 4.0 e o OSWorld sem célula mostram o outro lado: versão do teste, harness do agente e data da rodada mudam o resultado, e nenhuma das duas empresas roda o modelo da outra nas mesmas condições. O CWE-bench v1 deixa isso explícito ao listar o harness de cada modelo, com o Argon no Antigravity e o Fable 5.1 no Claude Code. A metodologia de avaliação que o Google publicou para o Argon detalha as condições do lado dele. Do lado da Anthropic, o Argon simplesmente não existia em 1º de setembro.
Há ainda um buraco de cobertura. Quinze dos 19 testes do Google não aparecem na página da Anthropic, e cinco dos nove testes da Anthropic (GDPval-AA v2, Humanity’s Last Exam, CursorBench e as duas variantes do OSWorld que ela usa) não aparecem na tabela do Google. Cada empresa publica onde brilha.
Na prática, o que vemos é que placar de fabricante serve para escolher o que testar, e o teste que decide é o seu. Antes de migrar uma carga de produção de um modelo para o outro, rode as duas APIs contra os seus próprios prompts e a sua própria fatura, com cache ligado nos dois lados. Um agente que lê contrato não se comporta como o Harvey’s Legal Agent Benchmark diz. Ele se comporta como o seu contrato exige.
Codificação, cibersegurança e trabalho corporativo: onde cada modelo se destaca
Em código de longo horizonte, cibersegurança e trabalho jurídico e financeiro, o Gemini 4 Argon se destaca com folga nos dados publicados em setembro de 2026. O Claude Fable 5.1 fica com um território menor e menos comparável: pesquisa científica agêntica, uso de computador e edição de código dentro do editor, testes em que o Google deixa a célula do Fable 5.1 vazia ou nem roda.
Comece pelo código, porque é onde a maior parte dos leitores vai gastar tokens. A vantagem do Argon aparece nas tarefas longas: 77,9% no DeepSWE v1.1 contra 67,4% do Fable 5.1, em um teste que mede engenharia em repositórios reais ao longo de muitos passos. O Google conta o que faz com isso dentro de casa. Agentes do Argon migram bases de C e C++ para Rust, de bibliotecas como re2 e libgav1 até as mais de 800 mil linhas do kernel Zircon, do Fuchsia OS. No libgav1, o decodificador de vídeo de código aberto do Google, os agentes trocaram 32 mil linhas de SIMD por Rust seguro que o compilador vetoriza sozinho, e o resultado roda 2,7 vezes mais rápido que o port anterior em Rust, com saída de vídeo idêntica. São relatos do próprio fabricante, e o Google avisa que essas reescritas ainda passam por auditoria manual e testes de emulação antes de entrar em produção.
Em tarefas curtas de código, a distância some. Terminal-bench 4.0, Vibe Code Bench e FrontierSWE v2 ficam a dois pontos ou menos de diferença entre os dois. Se o seu uso é completar função e corrigir teste, o benchmark não separa os dois modelos. O preço separa.
Cibersegurança é o critério em que o Argon foi treinado para vencer, e venceu. No CWE-bench v1, que mede remediação de vulnerabilidades, a classificação divulgada pelo Google em 30 de setembro de 2026 é esta:
| Modelo (harness do agente) | CWE-bench v1, Pass@1 |
|---|---|
| Grok 4.7 (opencode) | 68% |
| Gemini 4 Argon (Antigravity) | 68% |
| GPT-6 Astra (Codex) | 68% |
| Claude Opus 5.5 (Claude Code) | 67% |
| Claude Fable 5.1 (Claude Code) | 58% |
| Grok 4.6 (opencode) | 57% |
| DeepSeek-V4.1-Flash (opencode) | 55% |
| Muse Spark 1.3 (opencode) | 55% |
| Hy4 Preview (opencode) | 53% |
| GPT-6 Sol (Codex) | 52% |
| Inkling (opencode) | 37% |
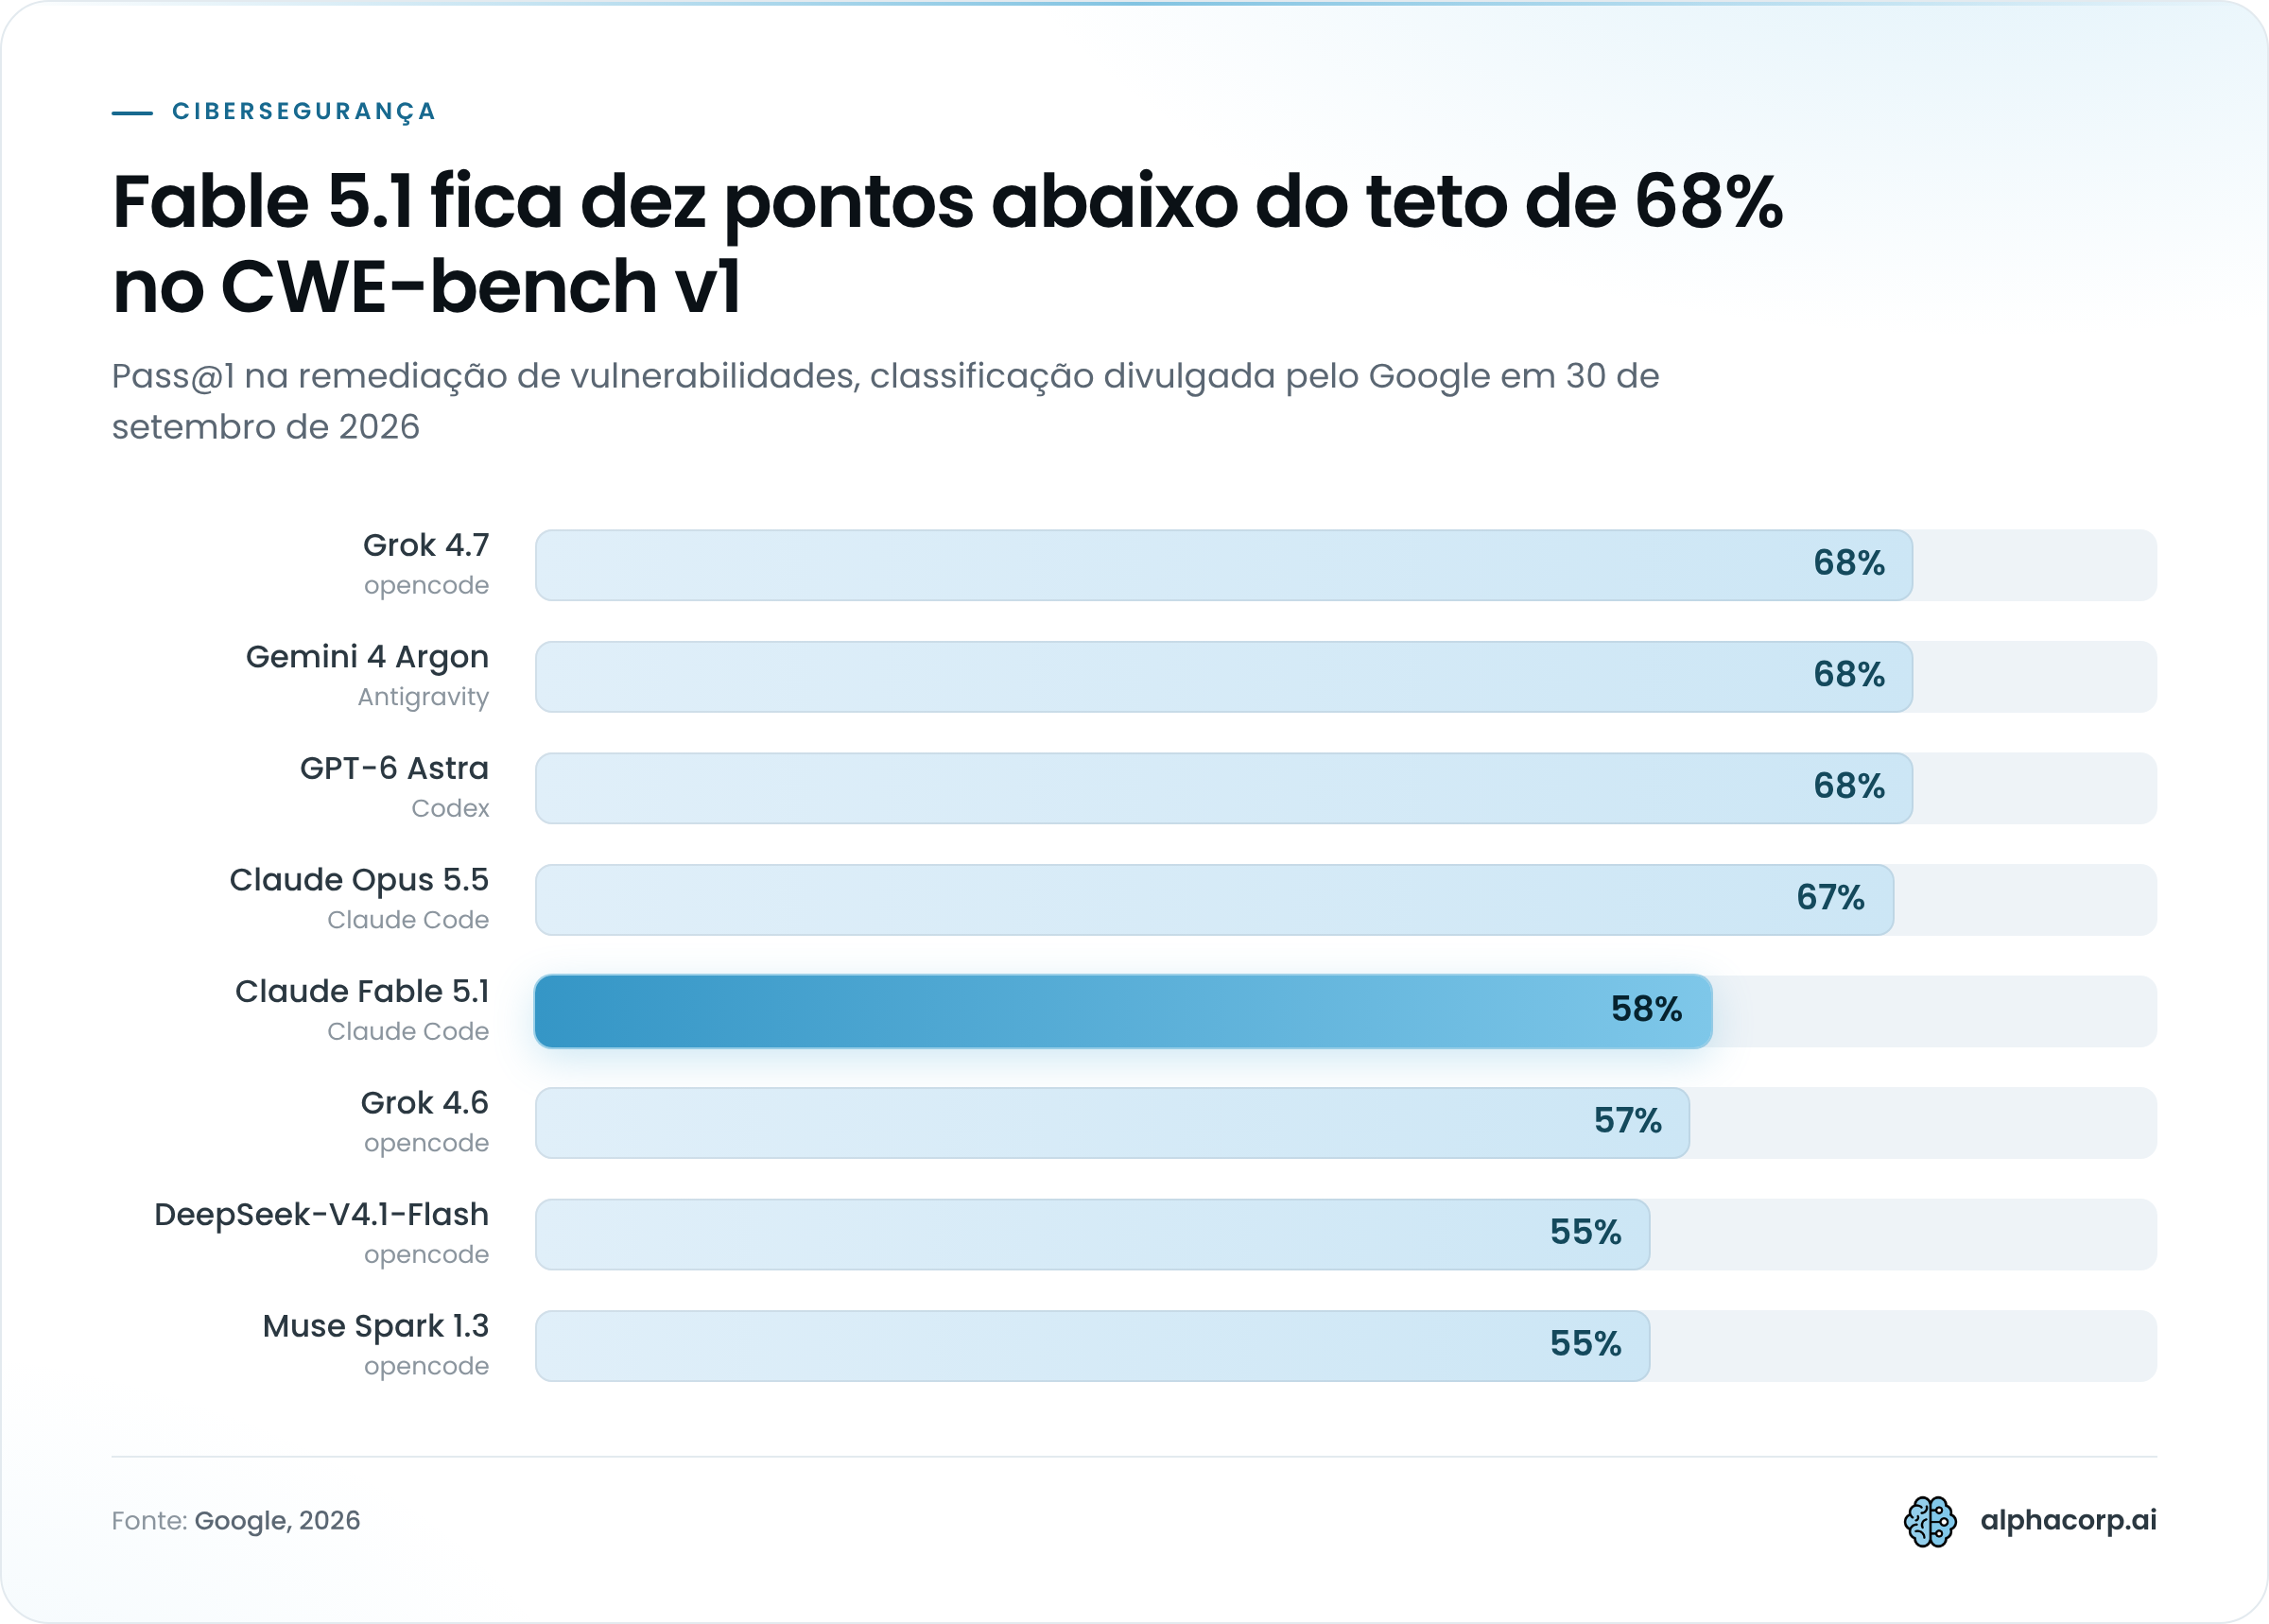
O empate triplo no topo diz tanto quanto a posição do Fable 5.1. Em corrigir falha conhecida, três modelos de três empresas bateram no mesmo teto de 68%, e o Fable 5.1 fica dez pontos abaixo, atrás até do Opus 5.5. Em descobrir falha, o Google só compara o Argon com o próprio Gemini 3.8 Flash Cyber: 85,8% contra 71,0% ao varrer código-fonte em 20 linguagens, e 70,9% contra 58,2% no teste de invasão da Wiz, que analisa sistemas web ao vivo sem acesso ao código. A Wiz, que usa o Argon na iniciativa Scan for Good, relata que o modelo achou uma vulnerabilidade crítica expondo dados pessoais em software hospitalar usado no mundo inteiro, uma falha que modelos de fronteira anteriores tinham deixado passar. Nenhum desses dois testes de descoberta traz número do Fable 5.1.
No trabalho corporativo, o Argon lidera as quatro linhas de conhecimento da tabela do Google, do Vals Index à pesquisa financeira em vários passos, e o Google descreve leitura de gráfico, detalhe em vídeo longo e ação sobre uma sequência de documentos como o pacote que sustenta isso.
E o Fable 5.1? O que a Anthropic mostra de mais forte é agir em ambiente científico e em sistema operacional: 52,6% no Terminal-Bench-Science 0.1, o dobro do Fable 5, e 77,9% no OSWorld 2.0 parcial. No CursorBench 3.2.0, que mede edição de código no Cursor, são 73,4%, e o Google não roda esse teste. Só que, no mesmo Terminal-Bench Science, o Google coloca o Argon em 57,6% e o GPT-6 Astra em 68,1%. O ponto forte do Fable 5.1 é forte contra a geração anterior da Anthropic. Contra o Argon, é desvantagem de cinco pontos.
Janela de saída, contexto e segurança: diferenças técnicas que importam
Na ficha técnica, a diferença que mais pesa é o limite de saída: o Gemini 4 Argon gera até 1 milhão de tokens em uma única resposta, contra 64 mil tokens do limite anterior do Gemini, e em resistência a injeção de prompt os dois modelos quase empatam, com 0,7% de ataques bem-sucedidos para o Argon e 1,0% para o Claude Fable 5.1.
O salto de saída é de cerca de 15,6 vezes, e o Google explica para que serve: um agente que precisa raciocinar e escrever centenas de milhares de tokens em uma trajetória só deixa de ser quebrado em várias chamadas. Para uma migração de código ou um relatório longo, isso muda o desenho do agente. Muda a fatura também, porque cada um desses tokens sai a US$ 10 por milhão no preço introdutório.
Já a janela de entrada do Argon o Google não publicou. Nem o anúncio nem a página de metodologia trazem o número, e o único indício é o GraphWalks de 256 mil a 1 milhão de tokens, faixa em que o modelo foi avaliado. Para o Fable 5.1, a Anthropic também não detalha contexto e limite de saída na página de preços. A referência para esses números é a ficha técnica do Claude Fable 5.1 no Amazon Bedrock.
Em segurança, os dois chegam perto do mesmo resultado por caminhos diferentes. No benchmark de injeção indireta de prompt da Gray Swan, com 15 tentativas de ataque por caso, a taxa de sucesso do atacante em setembro de 2026 é:
- Gemini 4 Argon: 0,7%
- Claude Opus 5.5: 1,0%
- Claude Fable 5.1: 1,0%
- Claude Opus 5: 4,6%
- GPT-6 Astra: 8,5%
- GPT-5.6 Sol: 27,0%
- Kimi K3: 52,7%
Três décimos de ponto não aparecem em produção. O que aparece é a postura de cada empresa. O Google monitora a cadeia de raciocínio e as ações do Argon e interrompe a execução quando o modelo sai do escopo pedido, usou um sistema parecido para vigiar os próprios treinos com uma equipe de resposta a incidentes, e diz ter evitado realimentar o treinamento com esses achados para o modelo não aprender a driblar o monitor. Também sela os sandboxes antes de avaliações de alto risco e submeteu as salvaguardas a red teams internos e externos. Para os defensores cibernéticos do Fairwind Program, o modelo sai sem guardrails de cibersegurança.
A Anthropic atacou outro problema: o falso positivo. O Fable 5.1 reduz em 60% os falsos positivos das salvaguardas de cibersegurança e em 85% as ativações desnecessárias das salvaguardas de biologia, e roteia consultas sensíveis nessas duas áreas para o Claude Opus sem cobrar o preço do Opus. Quem já manteve um agente em produção sabe o que esses dois números valem: uma salvaguarda que dispara em pedido legítimo é uma requisição que falha no meio do pipeline, com retry, log e usuário esperando. Nesse ponto, o dado da Anthropic é mais útil para o operador do que qualquer linha da tabela de benchmarks.
Disponibilidade: quem consegue usar cada modelo hoje
Em 30 de setembro de 2026, qualquer pessoa com cartão de crédito usa o Claude Fable 5.1, e ninguém fora do Fairwind Program do Google e dos times internos da empresa usa o Gemini 4 Argon. Essa é a diferença que decide a compra nos próximos meses.
O Fable 5.1 está em cinco canais desde 1º de setembro de 2026:
- Claude.ai, nos planos Pro, Max, Team e Enterprise
- API da Claude Platform
- Amazon Bedrock, com disponibilidade confirmada pela própria AWS
- Google Cloud
- Microsoft Foundry
Repare na ironia: o Google Cloud vende o modelo da Anthropic enquanto o modelo do próprio Google segue trancado. Se você já tem contrato com qualquer uma das três nuvens, o Fable 5.1 entra na fatura que você já paga, sem cadastro novo.
O Argon é outra história. O acesso hoje se limita a defensores cibernéticos de confiança selecionados pelo Fairwind Program, que recebem o modelo sem guardrails de cibersegurança, e a equipes internas do Google. A empresa diz participar do processo voluntário do governo dos EUA para acesso a modelos antes do lançamento e que vai ajustar as salvaguardas com o retorno desses primeiros testadores. Depois disso, a fila declarada é: clientes pagantes da API e assinantes do Google AI Ultra primeiro, desenvolvedores, empresas e consumidores em seguida. Não há data para nenhuma etapa.
O motivo é o próprio posicionamento do modelo. Um sistema treinado para achar, validar e corrigir vulnerabilidade sozinho serve ao defensor e ao atacante, e o Google escolheu abrir devagar. Faz sentido. Só que, para quem precisa de um modelo em outubro de 2026, faz sentido do lado de lá do balcão.
Se o seu time faz defesa cibernética de infraestrutura crítica, vale pedir entrada no Fairwind Program. Todo o resto espera.
Perguntas frequentes sobre Gemini 4 Argon e Claude Fable 5.1
As dúvidas mais buscadas sobre Gemini 4 Argon vs Claude Fable 5.1 têm resposta curta: o Argon é mais barato e lidera mais benchmarks, o Fable 5.1 é o único que você consegue usar no Brasil em 30 de setembro de 2026, e nenhuma assinatura, do Google ou da Anthropic, entrega o Argon hoje.
O Gemini 4 Argon já está disponível no Brasil?
Não. Em 30 de setembro de 2026, o Gemini 4 Argon só chega a defensores cibernéticos selecionados pelo Fairwind Program do Google e a equipes internas da empresa, em qualquer país. Não há API aberta, não há plano de assinatura e não há data para a liberação seguinte, que o Google promete começar por clientes pagantes da API e assinantes do Google AI Ultra. Se o seu time faz defesa de infraestrutura crítica, o caminho é pedir entrada no programa. Fora isso, é esperar.
Qual é mais barato, Claude ou Gemini?
O Gemini 4 Argon, por larga margem. No preço introdutório, ele cobra US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída, contra US$ 10 e US$ 50 do Claude Fable 5.1, o que dá cinco vezes menos. Quando a promoção terminar, o Argon sobe para US$ 4 e US$ 20 e a distância cai para 2,5 vezes. No cache de leitura, a diferença é menor: US$ 0,10 contra US$ 0,25. A ressalva óbvia é que preço de um modelo que você não consegue contratar ainda é preço de vitrine.
Gemini 4 Argon é melhor que Claude para programar?
Depende do tamanho da tarefa. Em engenharia de longo horizonte, o Argon marca 77,9% no DeepSWE v1.1 contra 67,4% do Fable 5.1, na tabela que o Google publicou em setembro de 2026. Em tarefas curtas, os dois ficam a menos de dois pontos um do outro no Terminal-bench 4.0, no Vibe Code Bench e no FrontierSWE v2, e no Terminal-bench 4.0 o Fable 5.1 chega a ficar meio ponto na frente. Para completar função e corrigir teste, o benchmark não decide. Para migrar uma base inteira de C++ para Rust, o Argon tem os números e os relatos internos do Google a seu favor.
O Google AI Ultra dá acesso ao Argon?
Hoje, não. A página brasileira de assinaturas do Google, em 30 de setembro de 2026, lista o AI Ultra de R$ 779,90 a R$ 999,90 por mês com acesso ao Gemini 3 Pro, e o nome Argon não aparece nela. O Google diz que assinantes do Ultra estarão no primeiro grupo a receber o modelo quando a liberação ampla começar, sem data. Quem assina o Ultra agora compra o Gemini da geração anterior e uma promessa.
O Claude Fable 5.1 está no Google Cloud?
Sim. Desde 1º de setembro de 2026, o Claude Fable 5.1 está disponível no Google Cloud, no Amazon Bedrock e no Microsoft Foundry, além da API da Claude Platform e do Claude.ai. Para uma empresa que já tem contrato com o Google Cloud, o modelo da Anthropic entra na mesma fatura, enquanto o modelo do próprio Google segue restrito ao Fairwind Program.
Quando o preço do Argon vai subir?
O Google não publicou data. O anúncio de 30 de setembro de 2026 chama US$ 2 e US$ 10 de preço introdutório e diz que a tabela vai a US$ 4 e US$ 20 depois, sem dizer quando nem quanto vai custar o cache de leitura após a virada. Qualquer planilha de custo feita com o valor promocional precisa de uma segunda coluna com o valor cheio.
Vale a pena esperar o Argon em vez de usar o Fable 5.1 agora?
Só se a sua carga é cibersegurança ou automação corporativa e você não tem prazo em outubro de 2026. Nesses dois casos a vantagem do Argon é larga: 68% contra 58% no CWE-bench v1 e 51,3% contra 31,4% no AutomationBench. Em código curto, pesquisa científica e uso de computador, o Fable 5.1 entrega hoje algo que o Argon não entrega para ninguém fora do programa fechado, e a espera não tem data de fim.
Como escolher entre os dois modelos agora
Quem precisa de um modelo em produção em outubro de 2026 escolhe o Claude Fable 5.1, e quem faz cibersegurança ou automação corporativa e pode esperar se inscreve para o Gemini 4 Argon e testa no preço introdutório assim que o acesso abrir. Esse é o critério de corte, e ele não muda com mais uma linha de benchmark.
O que fazer nesta semana:
- Fable 5.1 em produção: ligue o cache de prompt desde o primeiro dia. A leitura a US$ 0,25 por milhão é o que aproxima a fatura da Anthropic da fatura do Google
- Nome na fila do Argon: peça acesso ao Fairwind Program se o seu time faz defesa cibernética, ou fique atento à liberação para clientes pagantes da API
- Planilha com dois preços: modele o Argon a US$ 4 e US$ 20, e trate US$ 2 e US$ 10 como bônus temporário
- Teste com a sua carga: rode os mesmos prompts nos dois modelos, com cache ligado, e compare custo e acerto no seu caso, sem se apoiar no placar de nenhum fabricante
A consideração que quase ninguém faz: o modelo que chega mais perto do Argon na tabela do Google é o Claude Opus 5.5, e ele está disponível. Se a diferença que te incomoda é a do Fable 5.1, o próximo passo talvez seja subir de modelo na mesma casa, sem trocar de fornecedor.
Se você quer descobrir qual dos dois aguenta a sua carga real antes de assinar contrato de volume, a AlphaCorp AI monta e mede esse teste com você: fale com o time.