Neste artigo(25)
- Claude Sonnet 5.5 vs GPT-6 Sol: qual é melhor em cada tipo de tarefa
- Benchmarks lado a lado: onde os dois modelos têm nota publicada
- FrontierCode 1.1: a vantagem depende do nível de esforço
- GDPval-AA, AA-Briefcase e Chartography: margem larga, com duas ressalvas
- O que o Claude Sonnet 5.5 mostra nos testes sem nota do GPT-6 Sol
- O que a OpenAI divulgou sobre o GPT-6 Sol
- Quanto custa cada modelo: preço por token empatado, custo por tarefa não
- Como o nível de esforço muda a conta
- E o preço em reais
- Ficha técnica: contexto, saída máxima, velocidade e níveis de esforço
- Padrões de esforço diferentes distorcem o primeiro teste
- Velocidade: o dado independente ainda é da geração anterior
- Até onde dá para confiar nesses números
- Cada empresa escolhe a configuração que a favorece
- Segurança, salvaguardas e onde cada modelo está disponível
- Onde cada modelo roda
- Perguntas frequentes sobre Claude Sonnet 5.5 e GPT-6 Sol
- Qual é melhor para programar, Claude Sonnet 5.5 ou GPT-6 Sol?
- Qual é mais barato, Claude Sonnet 5.5 ou GPT-6 Sol?
- Quanto custa o Claude Sonnet 5.5 e o GPT-6 Sol em reais?
- O Claude Sonnet 5.5 é melhor que o Claude Opus 5.5?
- Qual a diferença entre GPT-6 Sol e GPT-6 Luna?
- Dá para usar Claude Sonnet 5.5 e GPT-6 Sol no Brasil?
- Quando sai o Claude Haiku 5.5?
- Como escolher e testar os dois modelos no seu caso de uso
Os dois modelos cobram exatamente o mesmo por token, então a disputa Claude Sonnet 5.5 vs GPT-6 Sol se resolve no desempenho em cada tarefa. Até 28 de setembro de 2026, o Claude Sonnet 5.5 é a melhor escolha para a maioria dos times, porque vence os quatro benchmarks em que ambos têm nota publicada. O GPT-6 Sol compensa se você já trabalha no ChatGPT, no Codex ou no GitHub Copilot.
Neste comparativo, o time da AlphaCorp AI separa as notas comparáveis das que cada fabricante mediu sozinho e mostra como testar os dois com as suas tarefas.
Os números que sustentam a recomendação:
- Preço em 2026: US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída nos dois modelos, segundo as tabelas da Anthropic e da OpenAI
- GDPval-AA v2.1 em 2026: 1.844 pontos para o Sonnet 5.5 e 1.487 para o GPT-6 Sol, em medição da Artificial Analysis
- FrontierCode 1.1 em 2026: 52,1% para o Sonnet 5.5 em esforço Xhigh e 49,3% para o GPT-6 Sol, na tabela de lançamento da Anthropic
- AutomationBench 1.0.6 em 2026: 33,2% para o GPT-6 Sol a US$ 0,27 por tarefa, em dado divulgado pela OpenAI
- Velocidade em 2026: 82,9 tokens por segundo no GPT-6 Sol e 65,9 no Claude Sonnet 5, a geração anterior, no painel da Artificial Analysis
Claude Sonnet 5.5 vs GPT-6 Sol: qual é melhor em cada tipo de tarefa
Em 28 de setembro de 2026, o Claude Sonnet 5.5 é a escolha mais segura para a maioria dos times que avaliam Claude Sonnet 5.5 vs GPT-6 Sol. Ele lidera os quatro benchmarks em que os dois modelos têm nota publicada, segundo a tabela de resultados que a Anthropic divulgou no lançamento, e cobra o mesmo preço por token. O GPT-6 Sol se defende em automação de escritório e engenharia de software ponta a ponta, áreas cobertas pelos números de lançamento da própria OpenAI.
O preço não desempata nada. Os dois cobram US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída nas tabelas de setembro de 2026, então a decisão passa pelo tipo de tarefa que você roda.
Por perfil de uso, a leitura fica assim:
- Programação com código que precisa entrar no merge sem retoque: Sonnet 5.5, à frente no FrontierCode 1.1 quando roda em esforço Xhigh
- Relatórios, planilhas e apresentações: Sonnet 5.5, com mais de 300 pontos de vantagem no GDPval-AA v2.1 e no AA-Briefcase v1.1
- Leitura de gráficos e imagens: Sonnet 5.5, 8 pontos percentuais acima do Sol no Chartography
- Automação de tarefas de escritório: GPT-6 Sol tem o único resultado publicado, 33,2% no AutomationBench 1.0.6, e o Sonnet 5.5 não tem nota nesse teste
- Times que já trabalham dentro do ChatGPT, do Codex ou do GitHub Copilot: GPT-6 Sol, disponível nessas ferramentas desde 22 de setembro de 2026
Uma ressalva pesa sobre tudo isso. Quase todos os números saíram dos materiais de lançamento das duas empresas, e nenhum laboratório independente testou os dois modelos lado a lado nas mesmas condições até 28 de setembro de 2026.
Na nossa leitura, a vantagem do Sonnet 5.5 é real nos testes comparáveis, mas ela cobre só quatro benchmarks. Se o seu uso principal é automação de processos internos, você vai decidir com dados de um lado só. Nenhuma das duas empresas resolve essa lacuna para você.
Benchmarks lado a lado: onde os dois modelos têm nota publicada
Nos quatro benchmarks em que Claude Sonnet 5.5 e GPT-6 Sol têm nota publicada até 28 de setembro de 2026, o Sonnet 5.5 lidera todos: FrontierCode 1.1, GDPval-AA v2.1, AA-Briefcase v1.1 e Chartography. A margem é curta em código e larga em trabalho de conhecimento.
| Benchmark | O que mede | Claude Sonnet 5.5 | GPT-6 Sol |
|---|---|---|---|
| FrontierCode 1.1 | Código pronto para merge sem edição humana | 52,1% (Xhigh) e 46,2% (Max) | 49,3% |
| GDPval-AA v2.1 | Tarefas reais de 44 ocupações em nove setores | 1.844 | 1.487 |
| AA-Briefcase v1.1 | Trabalho de conhecimento | 1.811 | 1.483 |
| Chartography | Leitura de gráficos sem ferramentas | 61,6% | 53,6% |
FrontierCode 1.1: a vantagem depende do nível de esforço
O Sonnet 5.5 marca 52,1% em esforço Xhigh e supera os 49,3% do GPT-6 Sol por 2,8 pontos. Só que em esforço Max a nota cai para 46,2%, abaixo do Sol.
O motivo está no desenho do teste. O FrontierCode avalia se uma alteração de código poderia entrar no merge sem edição humana e pune mudanças fora do escopo, mesmo quando elas são boas. Em Max, o Sonnet 5.5 acionou com mais frequência a revisão de código do Claude Code, que divide o trabalho entre vários subagentes, e em dois casos examinados pela Cognition isso terminou em timeout ou em edições além do que a tarefa pedia.
A lição prática vale para qualquer modelo: subir o esforço ao máximo aumenta o custo e pode piorar o resultado em tarefa de escopo fechado.
GDPval-AA, AA-Briefcase e Chartography: margem larga, com duas ressalvas
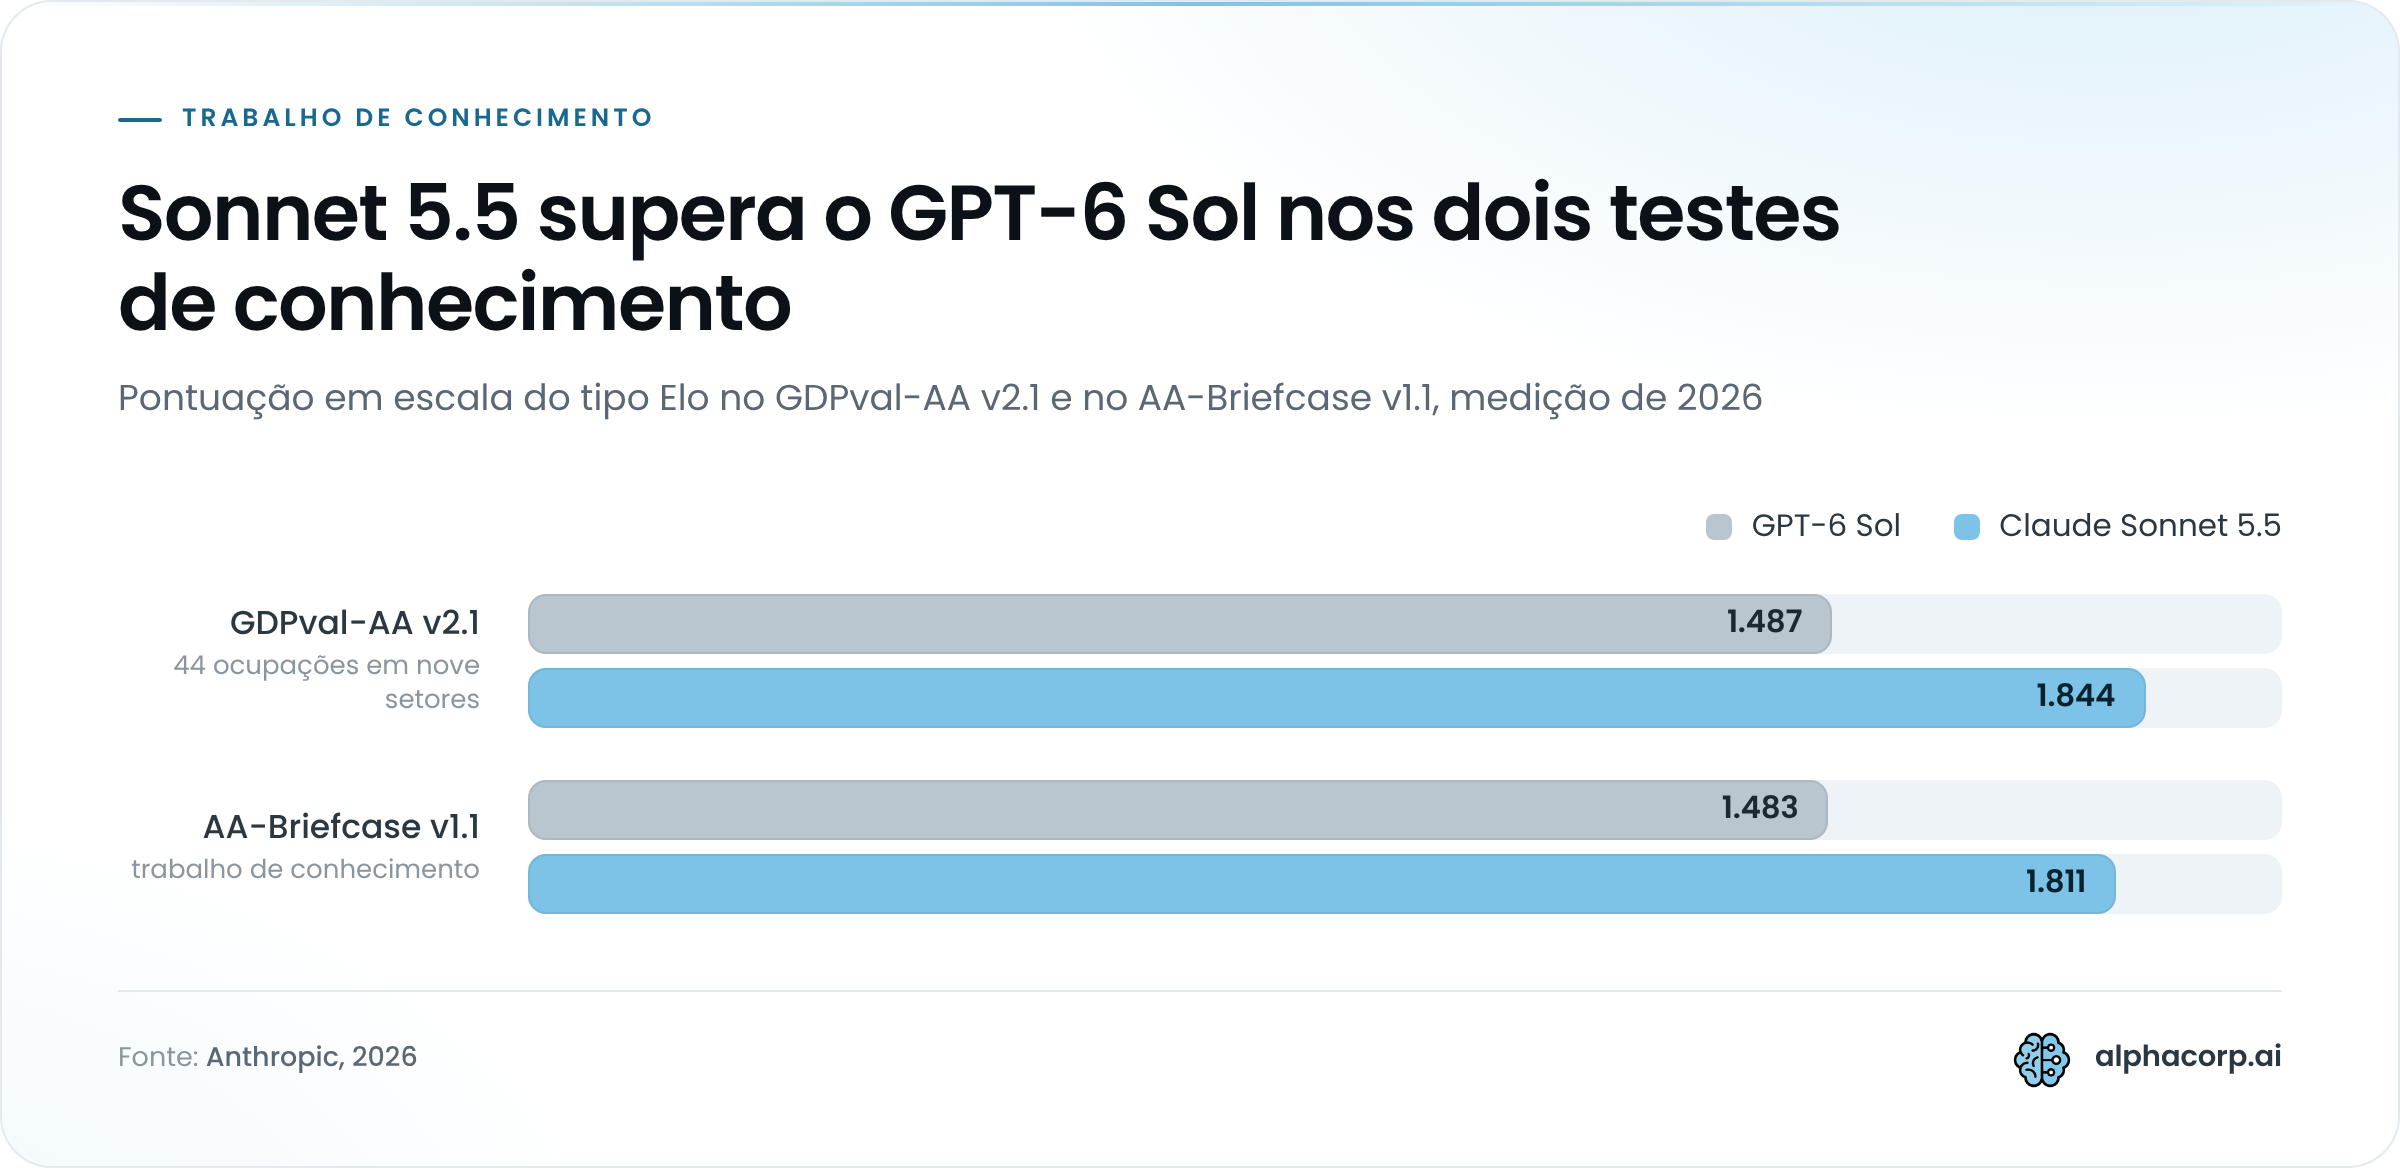
Em trabalho de conhecimento, a distância é de outra ordem. No GDPval-AA v2.1, o Sonnet 5.5 soma 1.844 pontos contra 1.487 do GPT-6 Sol, uma diferença de 357 pontos numa escala do tipo Elo. No AA-Briefcase v1.1, são 1.811 contra 1.483. No Chartography, 61,6% contra 53,6%.
As duas ressalvas envolvem bugs, um de cada lado:
- A Artificial Analysis rodou o GDPval-AA e o AA-Briefcase numa versão de pré-lançamento do Sonnet 5.5 que tinha um bug em respostas com saída estruturada. A Anthropic diz que o efeito, se existir, é pequeno e joga a nota para baixo. O bug já foi corrigido.
- A OpenAI corrigiu um bug que degradava a leitura de imagens do GPT-6 Sol, e as notas oficiais da Artificial Analysis e da Surge AI (responsável pelo Chartography) podem ainda refletir a versão antiga.
- A Artificial Analysis não espera mudança grande nas notas do Sol em GDPval-AA e AA-Briefcase, e testes internos citados pela Anthropic indicam que o Chartography não foi afetado.
Uma diferença de 350 pontos dificilmente some com uma correção de bug. Os 2,8 pontos do FrontierCode são outra história: trate esse resultado como empate técnico com leve vantagem do Sonnet 5.5.
O que o Claude Sonnet 5.5 mostra nos testes sem nota do GPT-6 Sol
Nos testes em que o GPT-6 Sol não tem resultado reportado, o Claude Sonnet 5.5 marca 70,6% no Terminal-Bench 4.0, contra 10,3% do Sonnet 5 e 66,4% do Opus 5.5, segundo os dados da Anthropic de 28 de setembro de 2026. Esses números situam o modelo dentro da própria família Claude. Eles não dizem nada sobre o Sol.
O Terminal-Bench 4.0 mede tarefas profissionais de várias etapas numa interface de linha de comando. O salto de 10,3% para 70,6% entre duas gerações é o maior da tabela, e o Sonnet 5.5 ainda passa o Opus 5.5, que custa o dobro por token. A nota do Opus foi medida em esforço Xhigh, o melhor resultado dele.
Os outros três testes mostram um padrão parecido, com o Sonnet 5.5 sempre perto do Opus 5.5 e longe do Sonnet 5:
- CursorBench 4.0, com tarefas de sessões reais de programação no Cursor: 55,5% para o Sonnet 5.5, 34,1% para o Sonnet 5 e 57,8% para o Opus 5.5
- Humanity’s Last Exam com ferramentas, de raciocínio multidisciplinar: 64,5%, 54,9% e 67,7%, na mesma ordem
- OSWorld 2.1, de uso de computador, em resultado parcial: 80,1%, 57,0% e 81,8%
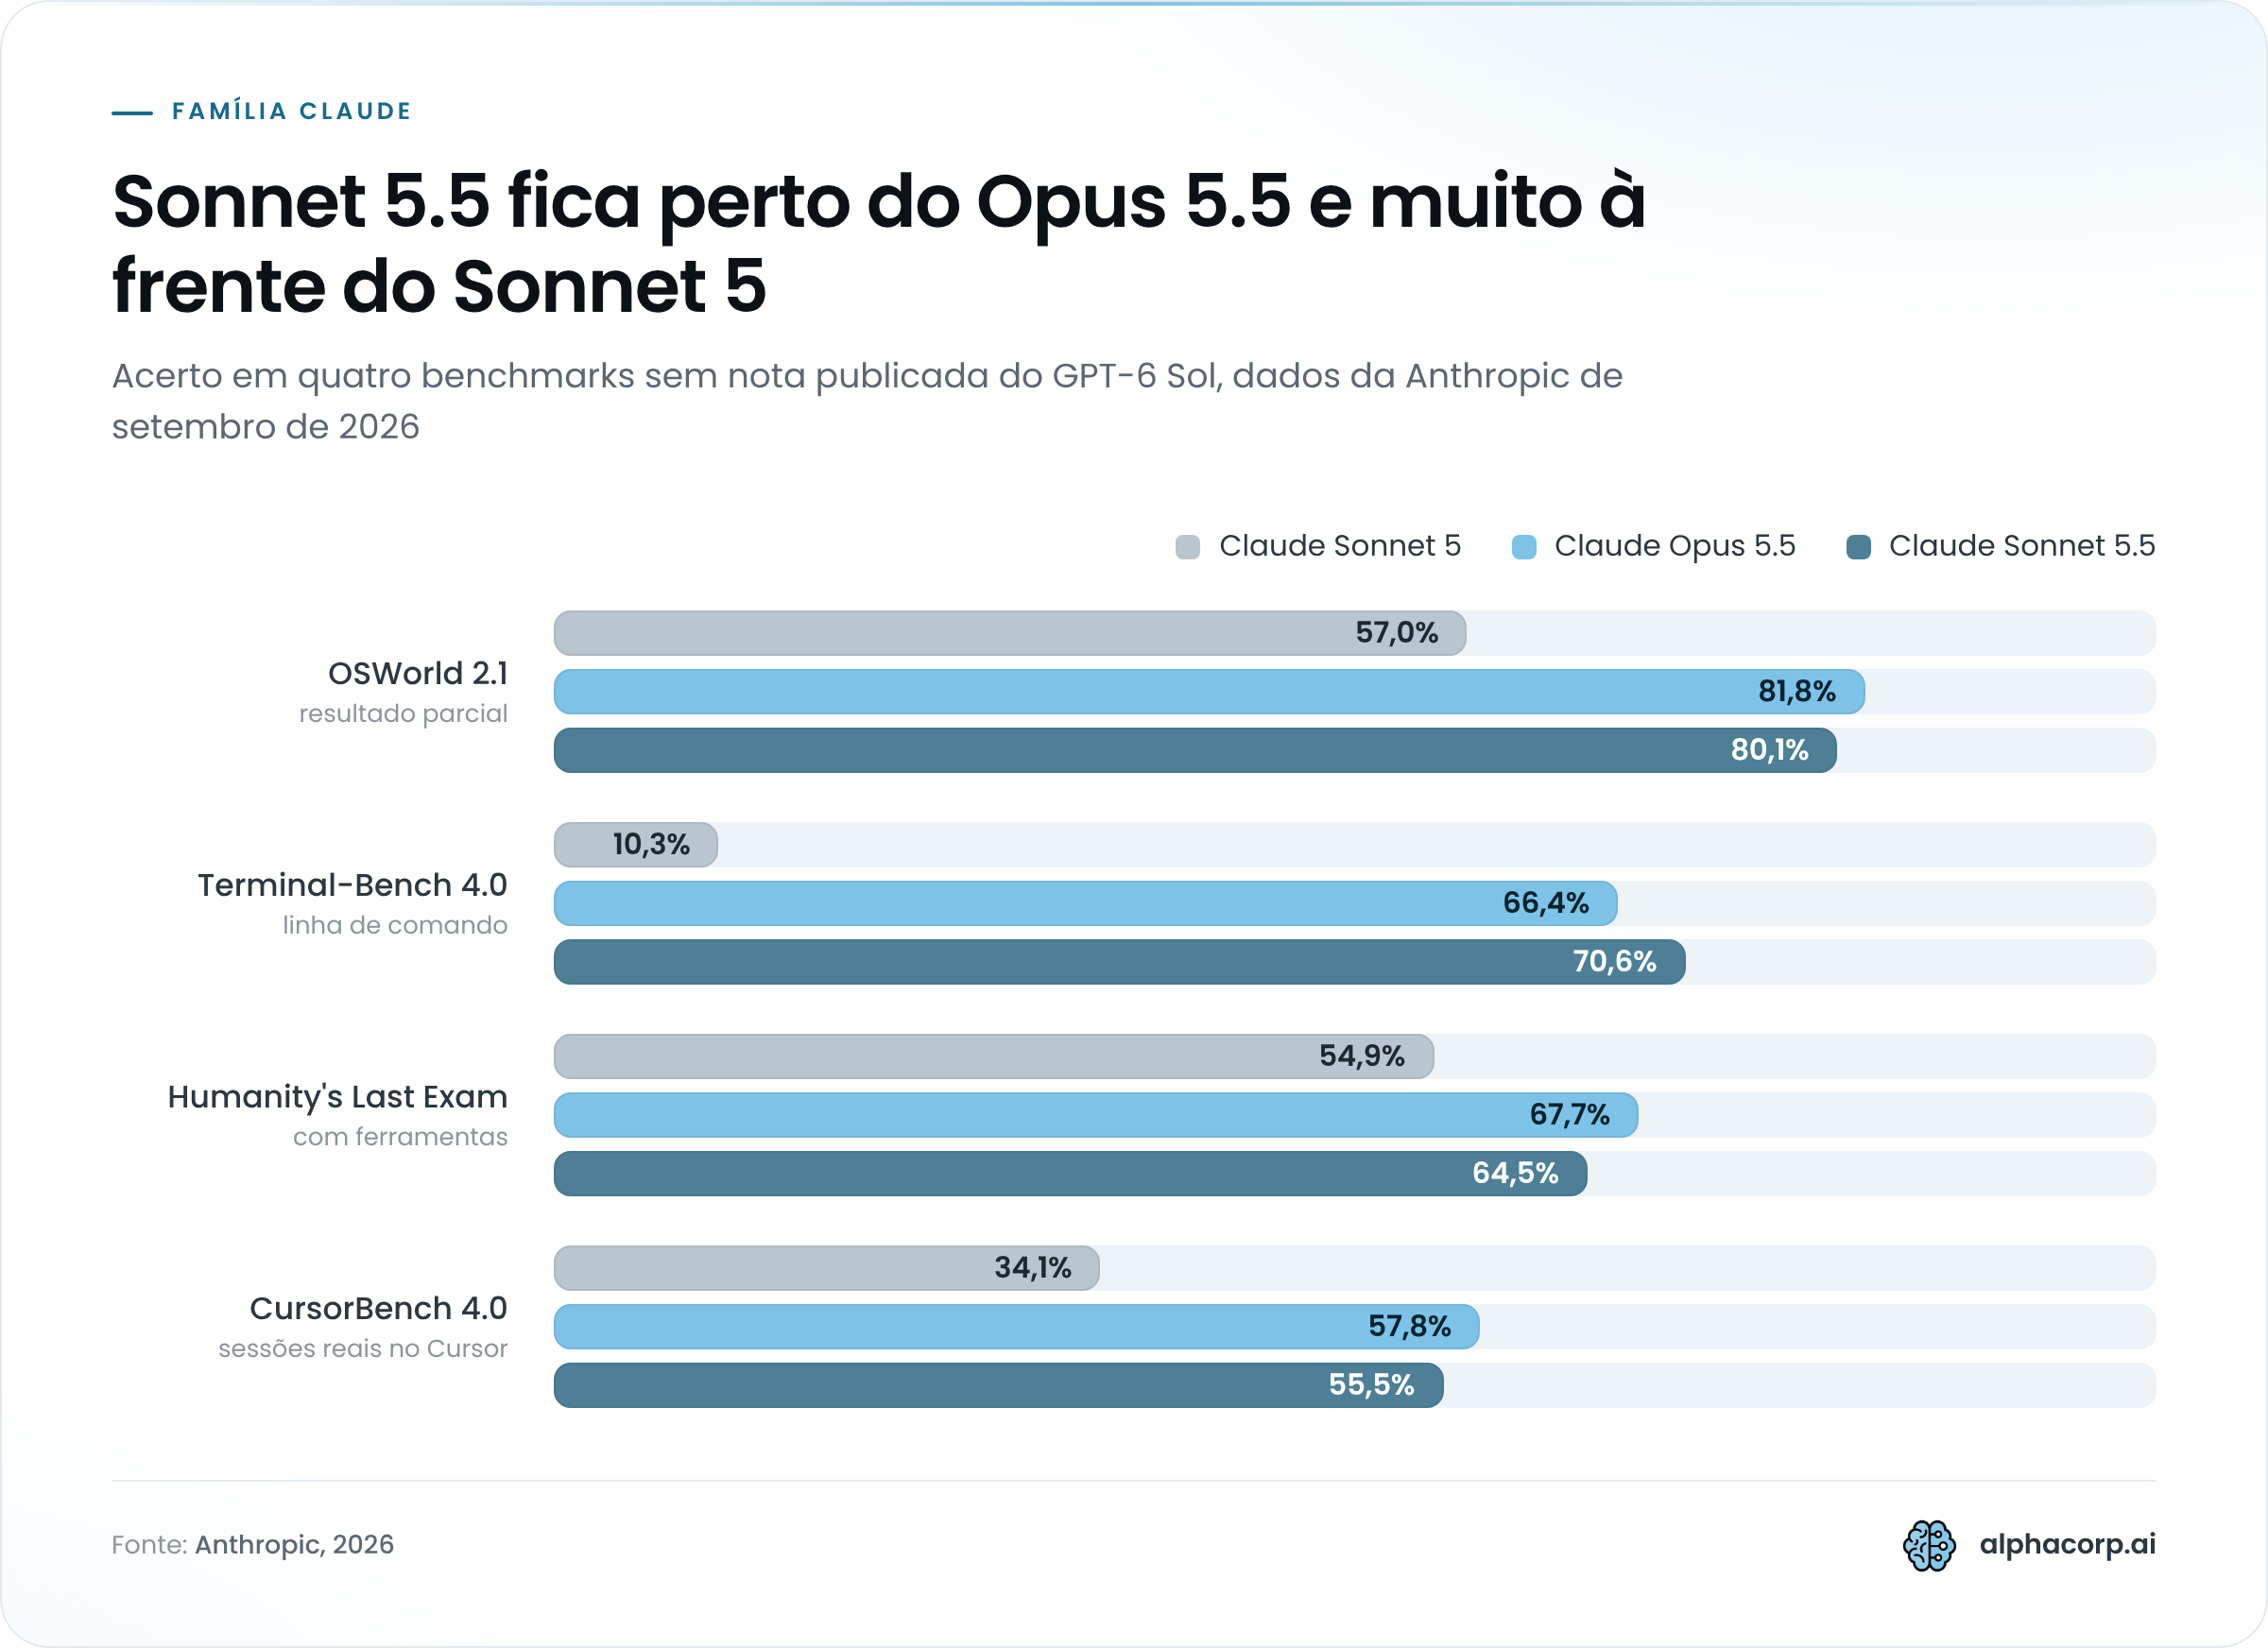
Falta o concorrente nessa conta. A OpenAI não publicou nota do GPT-6 Sol no Terminal-Bench 4.0, e a Anthropic usou o GPT-5.6 Sol, a geração anterior, no gráfico de custo por tarefa desse teste. CursorBench, Humanity’s Last Exam e OSWorld aparecem como “não reportado” para o Sol na tabela da Anthropic.
O que dá para concluir, então? Que o Sonnet 5.5 entrega resultado próximo ao do Opus 5.5 em programação agêntica e uso de computador, com distância de 1,7 a 3,2 pontos nos três testes em que fica atrás. Para quem já usa Claude, isso muda a conta de qual modelo chamar em cada etapa de um agente.
A própria Anthropic põe um freio nessa leitura. A empresa afirma que o Opus 5.5 continua melhor em trabalho complexo e aberto, que exige julgamento sustentado por muito tempo, e que nota de benchmark captura só uma parte do que um modelo faz.
Há ainda um resultado informal. O Sonnet 5.5 é o primeiro modelo da linha Sonnet a terminar o Pokémon Red operando só a partir de capturas de tela, um teste que a Anthropic usa para mostrar agência de longo prazo e compreensão de imagem. Não é benchmark auditado. Serve como indício de que o modelo mantém um objetivo por milhares de passos sem se perder, comportamento que pesa em qualquer agente que trabalha por horas sem supervisão.
O que a OpenAI divulgou sobre o GPT-6 Sol
A OpenAI divulgou três resultados do GPT-6 Sol no lançamento de 22 de setembro de 2026: 33,2% no AutomationBench 1.0.6, 68,8% no DeepSWE v1.1 e cerca de metade dos erros factuais do GPT-5.6 Sol. Nenhum deles tem o Claude Sonnet 5.5 como adversário, porque o modelo da Anthropic só saiu seis dias depois.
Os adversários escolhidos foram outros. A OpenAI mediu o Sol contra o Claude Opus 5 e o Claude Fable 5, modelos mais caros da Anthropic, e o argumento central é quanto custa cada tarefa concluída.
- AutomationBench 1.0.6, de automação de tarefas de escritório, em esforço
xhigh: 33,2% para o GPT-6 Sol a US$ 0,27 por tarefa, contra 26,9% do Claude Opus 5 a um custo 11,1 vezes maior - DeepSWE v1.1, de engenharia de software ponta a ponta, em esforço máximo: 68,8% para o GPT-6 Sol e 69,9% para o Claude Fable 5, com o Sol gastando cerca de 20% do custo por tarefa
- Fatualidade, em teste interno da OpenAI: cerca de metade dos erros do GPT-5.6 Sol
O terceiro item pede explicação. A OpenAI montou o teste com conversas reais que usuários sinalizaram, e afirma que o Sol comete cerca de metade dos erros factuais da geração anterior, perto da confiabilidade do GPT-6 Astra, o modelo mais caro da empresa. O dado é uma proporção entre dois modelos da mesma casa, sem a taxa absoluta de erro de nenhum deles.
No DeepSWE, a leitura é simples. O Sol fica 1,1 ponto atrás do Fable 5 e custa um quinto por tarefa, troca que quase todo time de engenharia aceitaria sem discutir.
O AutomationBench merece mais cuidado. Uma nota de 33,2% quer dizer que o melhor resultado publicado ainda falha em duas de cada três tarefas de escritório, e o Opus 5 falha em quase três de cada quatro. Se você pretende colocar um agente para preencher sistemas internos sem revisão humana, nenhum dos modelos testados chega perto de permitir isso em 2026. O que o Sol prova nesse teste é que errar ficou mais barato, e isso tem valor quando o fluxo já prevê alguém conferindo a saída.
Quanto custa cada modelo: preço por token empatado, custo por tarefa não
Claude Sonnet 5.5 e GPT-6 Sol custam o mesmo por token em setembro de 2026: US$ 2 por milhão de tokens de entrada, US$ 10 por milhão de saída e US$ 0,20 por milhão de leitura em cache. A diferença aparece no custo por tarefa, que depende de quantos tokens cada modelo gasta para resolver o mesmo problema.
| Item, por milhão de tokens | Claude Sonnet 5.5 | GPT-6 Sol |
|---|---|---|
| Entrada | US$ 2,00 | US$ 2,00 |
| Saída | US$ 10,00 | US$ 10,00 |
| Leitura em cache | US$ 0,20 | US$ 0,20 |
| Escrita em cache | US$ 2,50 | não informado |
| Mudança frente à geração anterior | preço mantido | corte de 50% |
Os dois chegaram ao mesmo número por caminhos opostos. A Anthropic manteve a tabela do Sonnet 5 e aposta em eficiência: o Sonnet 5.5 agrupa mais chamadas de ferramenta, dá menos passos e, nos testes da empresa, custa até 30% menos por tarefa que o antecessor. Já a tabela de preços do GPT-6 Sol na documentação da OpenAI é metade da que valia para o GPT-5.6 Sol, e a OpenAI descreve o corte como permanente.
Um cliente da Anthropic mediu o efeito em produção, sem mexer em nenhum prompt:
“Without changing any of our prompts, Claude Sonnet 5.5 did better than Sonnet 5 on almost all of our offline Slackbot evals, in fewer steps and with about 14% fewer output tokens.”
Curtis Allen, Principal Engineer, Slack
Catorze por cento menos tokens de saída pesam mais do que parece. A saída custa cinco vezes a entrada nos dois modelos, e o raciocínio do modelo é cobrado como saída, então é ali que a fatura cresce.
Como o nível de esforço muda a conta
O nível de esforço é o parâmetro que mais altera o gasto. Segundo a Anthropic, o Sonnet 5.5 em esforço Low ou Medium supera a melhor nota do Sonnet 5 em vários benchmarks por cerca de um décimo do custo por tarefa. No FrontierCode em esforço High, ele marca 10 pontos a mais que o Sonnet 5 na mesma configuração, por cerca de um quinze avos do custo.
Do lado da OpenAI, o único custo por tarefa publicado é o de US$ 0,27 no AutomationBench, medido em xhigh. Não existe o mesmo dado para o Sonnet 5.5 nesse teste, então comparar custo por tarefa entre os dois modelos ainda exige rodar suas próprias tarefas.
E o preço em reais
Nenhuma das duas empresas publica tabela em reais. A cobrança é em dólar, e câmbio e impostos entram por cima. Para estimar o orçamento, use a cotação PTAX do Banco Central no dia da conta e refaça o cálculo a cada fechamento, porque a taxa muda todo dia.
Ficha técnica: contexto, saída máxima, velocidade e níveis de esforço
Na ficha técnica de setembro de 2026, Claude Sonnet 5.5 e GPT-6 Sol quase empatam: o Sol tem janela de contexto de 1.050.000 tokens contra 1 milhão do Sonnet 5.5, e o Sonnet 5.5 tem corte de conhecimento mais recente, junho de 2026 contra 20 de abril de 2026. A saída máxima padrão é igual, 128 mil tokens.
| Especificação | Claude Sonnet 5.5 | GPT-6 Sol |
|---|---|---|
| Lançamento | 28 de setembro de 2026 | 22 de setembro de 2026 |
| Janela de contexto | 1 milhão de tokens | 1.050.000 tokens |
| Saída máxima | 128 mil tokens | 128 mil tokens |
| Saída máxima em lote | 300 mil tokens (Batch API, beta) | não informado |
| Corte de conhecimento | junho de 2026 | 20 de abril de 2026 |
| Esforço padrão na API | high | medium |
A janela maior do Sol engana um pouco. Dos 1.050.000 tokens, 922 mil são de entrada e o resto é reserva, então na prática o Sonnet 5.5 aceita mais texto de entrada. Para quem processa contratos longos ou repositórios inteiros, os dois resolvem.
Padrões de esforço diferentes distorcem o primeiro teste
O Sonnet 5.5 usa raciocínio adaptativo e vem em high na Claude Platform, enquanto o Claude Code e os aplicativos da Anthropic usam Medium. O GPT-6 Sol oferece seis níveis, de none a max, e vem em medium.
Isso cria uma armadilha comum em prova de conceito. Quem chama as duas APIs sem definir o esforço compara um modelo em high com outro em medium, e a diferença de qualidade, latência e custo que aparece vem da configuração. Defina o nível nos dois lados antes de medir qualquer coisa.
Velocidade: o dado independente ainda é da geração anterior
A única medição independente de velocidade compara o GPT-6 Sol com o Claude Sonnet 5. No painel comparativo da Artificial Analysis consultado em 28 de setembro de 2026, o Sol gera 82,9 tokens por segundo contra 65,9 do Sonnet 5, mas leva 8,82 s até o primeiro token, contra 4,01 s.
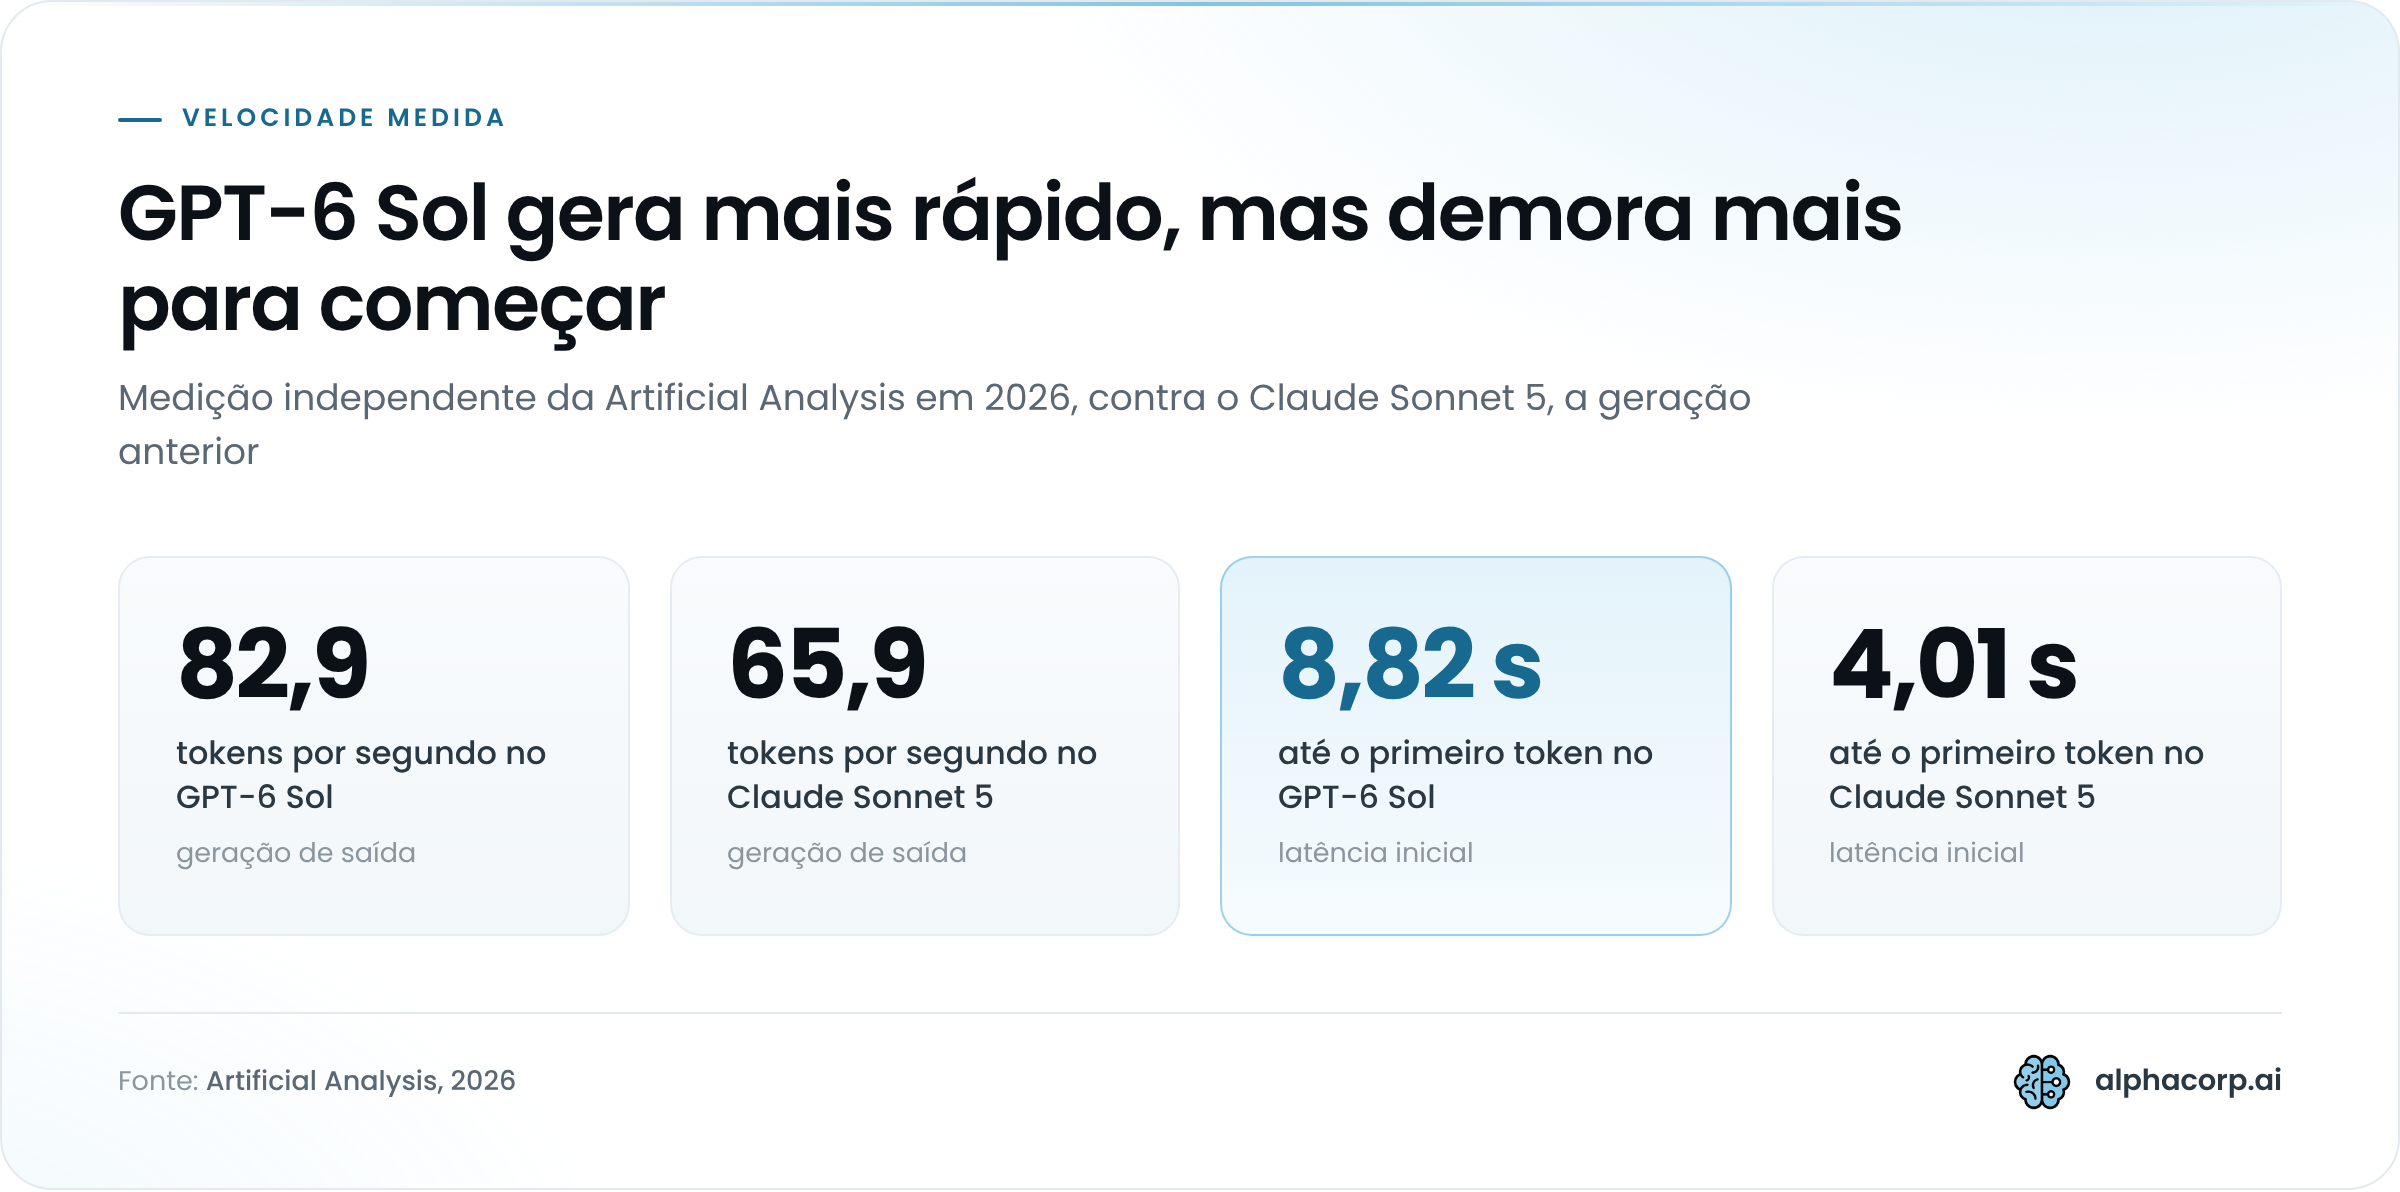
A Anthropic afirma que o Sonnet 5.5 gera saída pelo menos 30% mais rápido que o Sonnet 5, o que o colocaria perto do Sol em tokens por segundo. Até 28 de setembro de 2026, a Artificial Analysis não tinha publicado medição do Sonnet 5.5.
O tipo de aplicação decide qual métrica importa. Em chat com usuário esperando na tela, o tempo até o primeiro token pesa mais, e quase nove segundos de silêncio parecem travamento. Em processamento em lote, só a velocidade de geração conta.
Até onde dá para confiar nesses números
Os números de Claude Sonnet 5.5 e GPT-6 Sol indicam tendência, mas ainda não provam qual modelo é melhor: até 28 de setembro de 2026, nenhum laboratório independente testou os dois lado a lado, nas mesmas condições e com auditoria. Quase tudo saiu de material de lançamento.
Nem todo dado tem o mesmo peso. Separe em quatro grupos:
- Notas rodadas por terceiros e publicadas na tabela da Anthropic: GDPval-AA v2.1 e AA-Briefcase v1.1, da Artificial Analysis, e Chartography, da Surge AI
- Notas divulgadas só pela OpenAI: AutomationBench 1.0.6 e DeepSWE v1.1
- Testes internos sem método aberto: a fatualidade medida pela OpenAI e o Pokémon Red da Anthropic
- Medição independente, mas contra a geração anterior: o Intelligence Index da Artificial Analysis
O quarto grupo é o que mais confunde. O Intelligence Index v4.3.2 combina dez avaliações e dá 43 pontos ao GPT-6 Sol contra 32 do Claude Sonnet 5 em esforço high. Em esforço máximo, o placar é 48 contra 38.
Só que o adversário ali é o Sonnet 5. O Sonnet 5.5 ainda não constava no índice em 28 de setembro de 2026, e ele subiu cerca de 400 pontos sobre o antecessor no GDPval-AA, uma das dez avaliações que entram na conta. Quem cita o 43 a 32 como prova de que o Sol vence o Sonnet 5.5 compara modelos de gerações diferentes.
Cada empresa escolhe a configuração que a favorece
A OpenAI publica custo por tarefa em xhigh e em esforço máximo, sempre contra modelos mais caros da Anthropic, o que faz a economia parecer maior. A Anthropic destaca o ganho sobre o Sonnet 5 e reporta o FrontierCode em Xhigh, o nível em que o Sonnet 5.5 vai melhor.
Nenhuma das duas mente. As duas escolhem o enquadramento.
Na prática, o ranking de um benchmark público raramente se repete igual nos prompts de uma empresa, porque as tarefas, as ferramentas e o critério de acerto são outros. Use os números de lançamento para decidir o que testar primeiro e deixe a escolha final para uma medição feita com as suas tarefas.
Segurança, salvaguardas e onde cada modelo está disponível
O Claude Sonnet 5.5 chegou em 28 de setembro de 2026 com salvaguardas de cibersegurança, biologia e destilação descritas pela Anthropic, e o GPT-6 Sol leva vantagem de distribuição para quem já trabalha no ChatGPT, no Codex ou no GitHub Copilot. Os dois pontos afetam o deploy mais do que parece.
A avaliação de alinhamento é da própria Anthropic. A auditoria comportamental automatizada roda cerca de 1.850 cenários, e nela o Sonnet 5.5 iguala ou supera o Sonnet 5 na maioria das medidas de alinhamento, resistência a mau uso e honestidade. Nos testes de contenção, ele fica perto do Opus 5.5 na frequência com que tenta sair do sandbox. No conjunto da auditoria, o Opus 5.5 ainda vai um pouco melhor, e a empresa admite que nenhuma bateria de testes pega toda falha.
Três salvaguardas mudam o comportamento do modelo em produção:
- Cibersegurança: tarefas de risco alto caem de forma visível para o Sonnet 5, enquanto achar e corrigir bugs no próprio código segue normal
- Biologia: valem as mesmas regras do Sonnet 5, e alguns pedidos de microbiologia e virologia podem ser barrados por engano
- Destilação: classificadores impedem a extração do raciocínio, e o thinking preservado fica preso à conta que o criou
O primeiro item pega times de segurança de surpresa. Se o seu fluxo inclui teste de invasão ou análise de exploit, parte das respostas vai vir da geração anterior, com a qualidade dela. A Anthropic promete acesso por níveis a defensores num programa de verificação ampliado, ainda sem data.
O terceiro afeta quem troca de conta no meio de uma sessão do Claude Code ou move conversas entre contas.
Onde cada modelo roda
A visão geral do Sonnet 5.5 na documentação da Claude Platform lista a API própria, a Amazon Web Services, o Google Cloud e a nuvem da Microsoft, com retenção zero de dados como opção. O identificador na API é claude-sonnet-5-5.
O GPT-6 Sol está na API da OpenAI, no Codex e no ChatGPT, e o registro de mudanças do GitHub confirma o modelo no Copilot desde 22 de setembro de 2026.
Um aviso para quem migra do Sonnet 5. Se você roda o modelo com thinking desligado, troque para a configuração between_tools antes de mudar de versão. Ela mantém desligado o raciocínio inicial.
Perguntas frequentes sobre Claude Sonnet 5.5 e GPT-6 Sol
Qual é melhor para programar, Claude Sonnet 5.5 ou GPT-6 Sol?
O Claude Sonnet 5.5 tem leve vantagem no único teste de código com nota dos dois: 52,1% contra 49,3% no FrontierCode 1.1, em dados de setembro de 2026. A margem de 2,8 pontos é pequena e só vale em esforço Xhigh.
O GPT-6 Sol marca 68,8% no DeepSWE v1.1, teste em que o Sonnet 5.5 não tem nota. Se o seu time vive no Codex ou no Copilot, o Sol já está lá.
Qual é mais barato, Claude Sonnet 5.5 ou GPT-6 Sol?
Nenhum dos dois é mais barato por token em setembro de 2026. Ambos cobram US$ 2 por milhão de tokens de entrada, US$ 10 por milhão de saída e US$ 0,20 por milhão de leitura em cache.
O gasto real depende de quantos tokens cada modelo consome na sua tarefa e do nível de esforço configurado. Esse dado só aparece quando você mede.
Quanto custa o Claude Sonnet 5.5 e o GPT-6 Sol em reais?
Não existe preço oficial em reais para nenhum dos dois modelos. A cobrança é em dólar, com câmbio e impostos por cima.
Para montar o orçamento, consulte a cotação PTAX publicada pelo Banco Central do Brasil no dia da conta. Valor fixado em reais num planejamento anual envelhece em semanas.
O Claude Sonnet 5.5 é melhor que o Claude Opus 5.5?
Não no geral. O Sonnet 5.5 supera o Opus 5.5 no Terminal-Bench 4.0, com 70,6% contra 66,4%, e quase empata no GDPval-AA v2.1, com 1.844 contra 1.846 pontos.
Nos demais testes publicados em setembro de 2026, o Opus 5.5 fica à frente, e a Anthropic afirma que ele segue melhor em trabalho complexo e aberto. O Opus custa o dobro: US$ 4 de entrada e US$ 20 de saída por milhão de tokens.
A divisão que a própria Anthropic sugere é usar o Sonnet 5.5 em tarefas de escopo bem definido, correção de bugs e produção de documentos, planilhas e apresentações.
Qual a diferença entre GPT-6 Sol e GPT-6 Luna?
GPT-6 Sol e GPT-6 Luna são dois modelos que a OpenAI lançou juntos em 22 de setembro de 2026, ambos abaixo do GPT-6 Astra, o mais caro da empresa. O Sol é o que divide faixa de preço com o Claude Sonnet 5.5.
Os dois chegaram no mesmo dia à API, ao Codex, ao ChatGPT e ao GitHub Copilot. Para comparar com o Sonnet 5.5, o par correto é o Sol.
Dá para usar Claude Sonnet 5.5 e GPT-6 Sol no Brasil?
Os dois modelos são vendidos por API e por plataformas de nuvem globais, com cobrança em dólar. Nenhuma das duas empresas publica tabela de preços ou condição comercial específica para o Brasil.
Se a sua empresa já tem contrato com AWS, Google Cloud ou Microsoft, confirme com o provedor em quais regiões o Sonnet 5.5 está liberado. Para dados pessoais sob a LGPD, a opção de retenção zero do Sonnet 5.5 entra na avaliação jurídica.
Quando sai o Claude Haiku 5.5?
A Anthropic informou em 28 de setembro de 2026 que o Claude Haiku 5.5 chega “nas próximas semanas”, sem data definida. Ele vai ser o terceiro modelo da família Claude 5.5, voltado a aplicações de alto volume e sensíveis a custo.
Preço e benchmarks do Haiku 5.5 ainda não foram publicados. Se o seu caso é classificação ou triagem em grande escala, vale esperar esses números antes de fechar contrato de volume.
Como escolher e testar os dois modelos no seu caso de uso
Para escolher entre Claude Sonnet 5.5 e GPT-6 Sol, rode as mesmas tarefas reais nos dois modelos, com o nível de esforço definido dos dois lados, e compare quanto custa cada tarefa concluída. Comece pelo Sonnet 5.5 se o seu trabalho é código, documento ou leitura de gráfico, e pelo Sol se o time já vive no Codex ou no Copilot.
Um roteiro curto resolve a primeira rodada:
- Separe de 30 a 50 tarefas tiradas do seu histórico, com o resultado esperado de cada uma escrito antes do teste
- Fixe o mesmo nível de esforço nas duas APIs e repita a bateria em pelo menos dois níveis
- Registre tokens de entrada e de saída, número de chamadas de ferramenta e tempo até o primeiro token
- Divida o gasto total pelas tarefas aprovadas, sem contar as que falharam
- Peça a alguém da área para avaliar as saídas sem saber qual modelo gerou cada uma
O quarto passo muda o ranking com frequência. Um modelo que acerta mais na primeira tentativa sai mais barato mesmo quando gasta mais tokens por chamada.
Guarde a bateria de testes depois de decidir. O Claude Haiku 5.5 está prometido para as próximas semanas e a Artificial Analysis ainda vai publicar a medição do Sonnet 5.5, então a mesma comparação vai precisar ser refeita antes do fim de 2026.
Se você quer montar essa avaliação com as tarefas da sua operação, a consultoria de IA da AlphaCorp AI desenha a bateria e mede os dois modelos junto com o seu time.