Neste artigo(17)
- Lançamento do Gemini 4 Argon: o que o Google anunciou em 30 de setembro de 2026
- Quando o Gemini 4 Argon fica disponível e para quem
- Quanto custa o Gemini 4 Argon: preços da API e comparação com concorrentes
- Benchmarks do Gemini 4 Argon contra GPT-6 Astra, Claude Opus 5.5 e Claude Fable 5.1
- O que o Argon já faz na prática dentro do Google
- Defesa cibernética: como o Argon encontra e corrige vulnerabilidades
- Salvaguardas de segurança e riscos antes do lançamento amplo
- O que o lançamento do Gemini 4 Argon significa para o Brasil
- Perguntas frequentes sobre o Gemini 4 Argon
- O Gemini 4 Argon já está disponível no Brasil?
- O Gemini 4 Argon é melhor que o GPT-6 Astra e o Claude Opus 5.5?
- Qual a diferença entre o Gemini 4 Argon e o Gemini 3?
- Quanto custa usar a API do Gemini 4 Argon?
- O que é o Fairwind Program do Google?
- Por que o Google liberou o Argon sem guardrails cibernéticos?
- O Gemini 4 Argon tem model card ou system card?
- Como se preparar para a chegada do Argon
O lançamento do Gemini 4 Argon, em 30 de setembro de 2026, trouxe um modelo de fronteira do Google com limite de saída de 1 milhão de tokens, preço introdutório de US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída, e acesso restrito a defensores cibernéticos. Aqui você encontra a tabela completa de 19 benchmarks contra GPT-6 Astra e Claude Opus 5.5, a conta de custo por tarefa, as fases de liberação e o que muda para quem opera IA no Brasil. Tudo com uma ressalva: os números comparativos são do próprio Google.
- 1 milhão de tokens de saída por chamada, contra 64 mil no Gemini 3, segundo o anúncio do Google de 30 de setembro de 2026.
- 13 de 19 benchmarks liderados pelo Argon na tabela publicada pelo Google em 2026, com um empate e cinco derrotas.
- US$ 0,10 por milhão de tokens de entrada em cache, um desconto de 95% sobre o preço introdutório de 2026.
- 0,7% de taxa de sucesso para ataques de injeção de prompt indireta no benchmark Gray Swan IPI em 2026, o menor entre os 13 modelos listados.
- 17% das empresas brasileiras usavam IA em 2025, ante 13% em 2024, pela pesquisa TIC Empresas do Cetic.br.
Lançamento do Gemini 4 Argon: o que o Google anunciou em 30 de setembro de 2026
Em 30 de setembro de 2026, o Google anunciou o Gemini 4 Argon, seu novo modelo de fronteira, construído para sustentar raciocínio profundo em fluxos de trabalho longos e de várias etapas. O anúncio saiu no blog institucional da empresa, assinado por Koray Kavukcuoglu, que comanda o Google DeepMind desde agosto de 2026 e acumula o cargo de arquiteto-chefe de IA do Google. O nome Argon já circulava como codinome interno meses antes, quando o modelo ainda estava em pós-treinamento sob a mesma liderança.
O que o Google promete é desempenho de fronteira em quatro frentes:
- Engenharia de software no mundo real: de depuração cotidiana a migrações de bases de código inteiras, com tarefas que se estendem por horas.
- Trabalho de conhecimento corporativo: pesquisa e redação em jurídico, finanças e tributário.
- Defesa cibernética autônoma: encontrar, validar e corrigir vulnerabilidades sem intervenção humana a cada passo.
- Compreensão visual ampliada: análise de gráficos profissionais, vídeos longos e sequências de documentos.
O post também cita escrita criativa como área de força, mas o material de lançamento gasta pouco espaço nisso. O foco declarado é trabalho técnico e corporativo.
A mudança de arquitetura mais concreta está no limite de saída. O Gemini 3, de novembro de 2025, já aceitava 1 milhão de tokens de entrada, mas travava a saída em 64 mil tokens. O Argon eleva o limite de saída para 1 milhão de tokens, igualando entrada e saída. Na prática, o modelo pode pensar e gerar centenas de milhares de tokens em uma única trajetória, sem precisar quebrar um problema grande em várias chamadas costuradas por código externo.
Isso importa mais do que parece à primeira vista. Quem já montou um agente que reescreve um módulo inteiro sabe que o gargalo raramente é o que o modelo consegue ler. O gargalo é quanto ele consegue produzir de uma vez antes de perder o fio, e o corte de 64 mil tokens obrigava a picar a tarefa em pedaços, com cada emenda sendo um ponto de falha.
Segundo o Google, milhares de funcionários já usam o Argon no dia a dia, com destaque para tarefas de código especializadas, pesquisa aprofundada e qualidade de escrita. Uma ressalva que vale desde já: até 30 de setembro de 2026, não existe model card, system card nem artigo técnico do Argon publicado. Tudo o que se sabe sobre o modelo vem do post de lançamento e das tabelas que o acompanham.
Quando o Gemini 4 Argon fica disponível e para quem
O Gemini 4 Argon está disponível desde 30 de setembro de 2026 apenas para um grupo restrito de defensores cibernéticos e para equipes internas do Google. O acesso amplo, incluindo API paga e assinantes do Google AI Ultra, foi prometido para “em breve”, sem data confirmada.
O Google descreve o lançamento como faseado, e a lógica declarada é segurança: liberar um modelo desse nível de capacidade exige testar guardrails com usuários reais antes de abrir para todo mundo. As fases, na ordem em que o anúncio as apresenta:
- Defensores cibernéticos de confiança, via Fairwind Program, um programa de acesso limitado que reúne governos e parceiros selecionados em torno de ferramentas de defesa cibernética. Esse grupo, junto com os times internos do Google, recebe o modelo sem os guardrails cibernéticos padrão, para explorar toda a capacidade defensiva.
- Governo dos EUA, em paralelo, pelo processo voluntário de acesso pré-lançamento a modelos de fronteira. O Google diz estar participando ativamente.
- Clientes pagos da API e assinantes do Google AI Ultra, os primeiros do público geral a receber o modelo.
- Desenvolvedores, empresas e consumidores em geral, “assim que possível”, nas palavras do próprio Google.
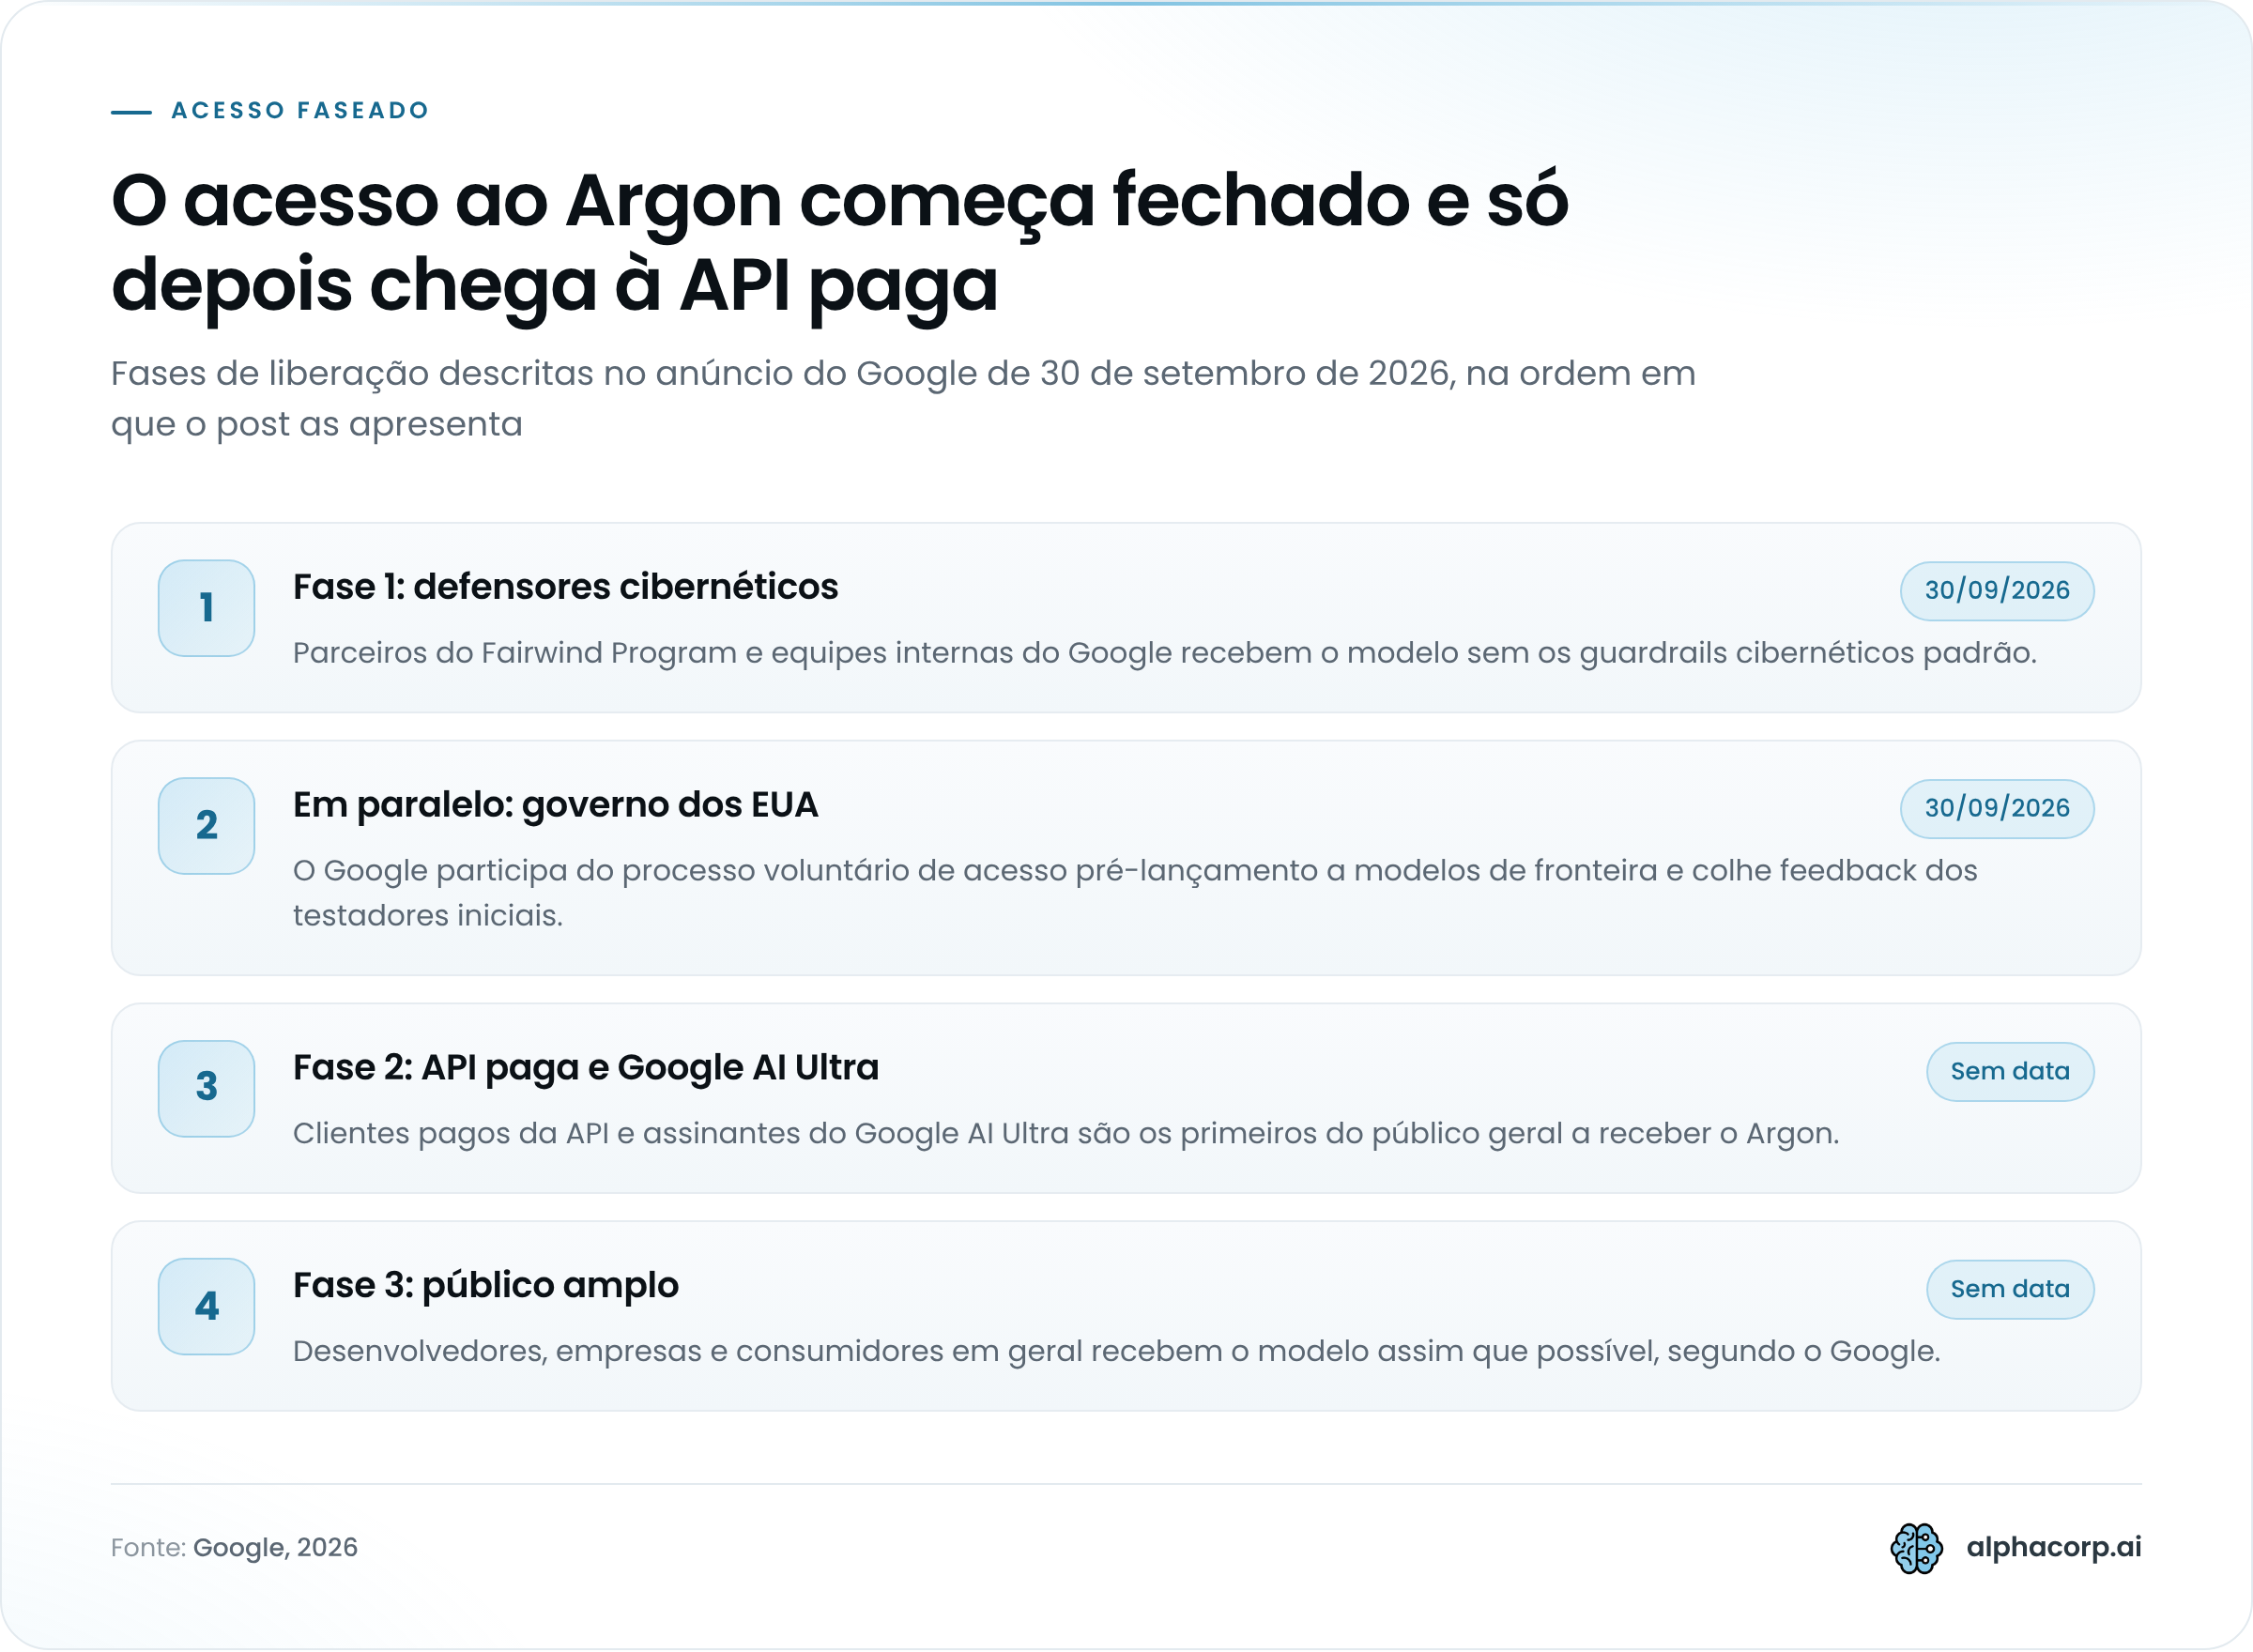
Entre a fase 1 e a fase 3, o Google afirma que vai colher feedback dos testadores iniciais e iterar nos guardrails. Não há prazo público para nenhuma das fases seguintes.
Se você está esperando para testar via API, a resposta honesta é: hoje não dá. Não existe lista de espera aberta descrita no anúncio, e o Fairwind Program não é um programa em que uma empresa comum se inscreve. Ele é voltado para governos e parceiros que o Google já considera confiáveis em defesa cibernética.
Por outro lado, o Google já divulgou preço e limites técnicos, o que sugere que a abertura para a API não está distante. Empresas que tinham anúncio de preço sem data de disponibilidade costumam abrir o acesso em semanas, mas isso é leitura minha do padrão do setor, sem confirmação oficial.
Quanto custa o Gemini 4 Argon: preços da API e comparação com concorrentes
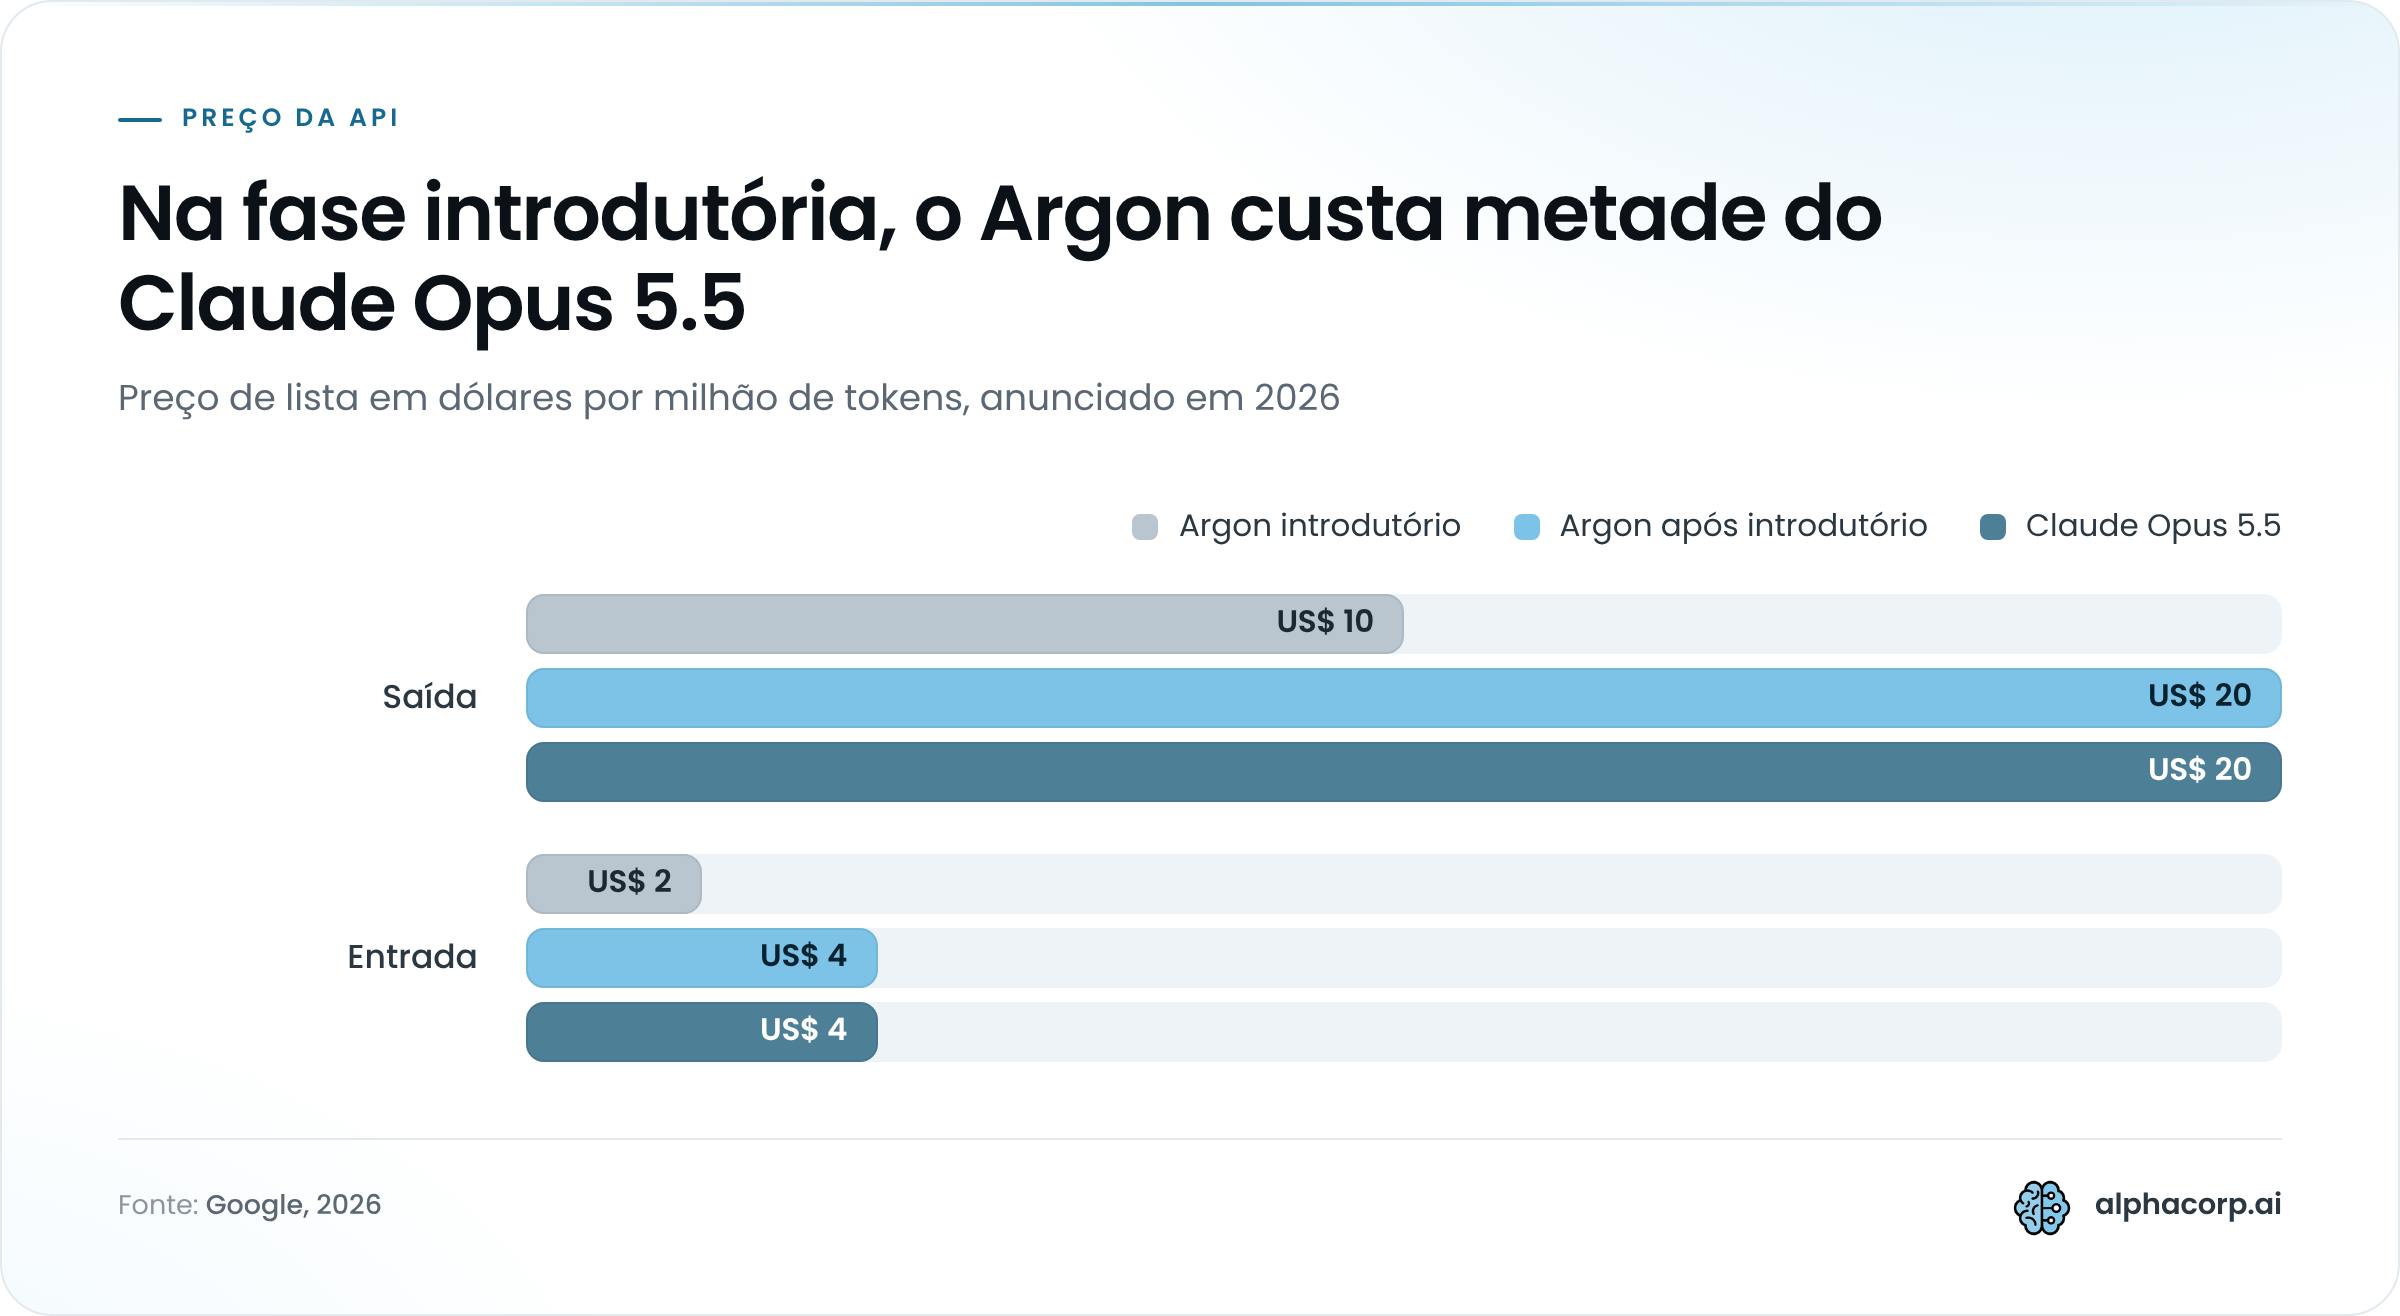
O Gemini 4 Argon custa US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída no preço introdutório anunciado em 30 de setembro de 2026, com tokens de entrada em cache a 95% de desconto, o que dá US$ 0,10 por milhão. Depois do período introdutório, o preço sobe para US$ 4 de entrada e US$ 20 de saída. O Google não divulgou quanto tempo dura a fase introdutória.
| Modelo (2026) | Entrada (US$/1M tokens) | Saída (US$/1M tokens) | Entrada em cache (US$/1M tokens) |
|---|---|---|---|
| Gemini 4 Argon, introdutório | 2,00 | 10,00 | 0,10 |
| Gemini 4 Argon, após introdutório | 4,00 | 20,00 | não divulgado |
| Claude Opus 5.5 | 4,00 | 20,00 | não divulgado |
A comparação direta mais limpa é com o Claude Opus 5.5, lançado pela Anthropic em 22 de setembro de 2026 a US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de saída. Na fase introdutória, o Argon custa exatamente a metade nas duas pontas. Depois dela, os dois modelos empatam em preço de lista. Frente ao GPT-6 Astra, da OpenAI, o preço introdutório do Argon também fica abaixo da camada padrão, mas o material de lançamento do Google não coloca os valores da OpenAI lado a lado.
O que esses números significam numa tarefa real? Alguns cálculos com o preço introdutório:
- Revisão de um módulo: 200 mil tokens de entrada (código mais contexto) e 50 mil de saída custam US$ 0,40 + US$ 0,50 = US$ 0,90. Após o período introdutório, US$ 1,80.
- Mesma revisão com o contexto em cache: os 200 mil tokens de entrada caem para US$ 0,02, e a tarefa fecha em US$ 0,52.
- Uma trajetória que usa o limite inteiro de saída: 1 milhão de tokens gerados custa US$ 10 hoje e US$ 20 depois. Isso é uma única chamada.
O último item merece atenção de quem controla orçamento. Um limite de saída de 1 milhão de tokens é ótimo para o agente, e péssimo para quem esqueceu de configurar um teto por requisição. Um loop de agente mal desenhado, que antes esbarrava em 64 mil tokens e parava, agora pode gerar dezenas de vezes mais antes de qualquer freio.
O desconto de 95% no cache é a peça que muda a conta em cargas repetitivas. Se o seu agente reenvia a mesma base de código, o mesmo contrato ou o mesmo manual a cada rodada, a entrada deixa de ser o custo dominante e a saída passa a mandar na fatura. Quem já opera agentes de IA em produção sabe que a diferença entre um projeto viável e um que estoura o orçamento costuma estar justamente nesse detalhe de arquitetura, e o Argon torna a estratégia de cache uma decisão de custo explícita desde o primeiro dia.
Benchmarks do Gemini 4 Argon contra GPT-6 Astra, Claude Opus 5.5 e Claude Fable 5.1
Na tabela de 19 benchmarks que o Google publicou em 30 de setembro de 2026, o Gemini 4 Argon lidera 13 linhas, empata em uma e perde cinco para o GPT-6 Astra ou para o Claude Opus 5.5. O Claude Fable 5.1 não vence nenhuma. Antes de qualquer leitura: quem rodou os testes, escolheu os benchmarks e montou a tabela foi o próprio Google, e até 30/09/2026 nenhum laboratório independente reproduziu esses números. A página de metodologia de avaliação do Argon descreve as condições de teste, mas continua sendo material do fabricante.
| Categoria | Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|---|
| Conhecimento | Vals Index | 68,9% | 63,1% | 65,8% | 67,0% |
| Conhecimento | AutomationBench | 51,3% | 41,4% | 31,4% | 42,5% |
| Conhecimento | Vals Finance Agent v2 | 65,4% | 53,5% | 58,9% | 58,6% |
| Conhecimento | Harvey’s Legal Agent Benchmark | 19,6% | 5,4% | 6,7% | 3,8% |
| Código agêntico | DeepSWE v1.1 | 77,9% | 74,1% | 67,4% | 74,2% |
| Código agêntico | FrontierSWE v2 | 55,0% | 65,5% | 56,3% | 62,3% |
| Código agêntico | Vibe Code Bench | 91,9% | 89,6% | 90,3% | 90,3% |
| Código agêntico | Terminal-bench 4.0 | 57,4% | 58,2% | 57,9% | 66,4% |
| Engenharia de ML | PostTrainBench | 45,3% | 44,3% | 40,2% | 49,3% |
| Ciência e matemática | Terminal-Bench Science 0.1 | 57,6% | 68,1% | 52,6% | 63,3% |
| Ciência e matemática | LABBench 2 | 88,8% | 85,4% | 68,6% | 73,1% |
| Ciência e matemática | RiemannBench | 76,0% | 72,0% | 65,6% | 69,6% |
| Contexto longo | GraphWalks, até 128k, BFS (F1) | 99,7% | 98,7% | 91,4% | 90,6% |
| Contexto longo | GraphWalks, 256k a 1M, BFS (F1) | 84,2% | 71,8% | 65,0% | 66,8% |
| Uso de computador | Agent’s Last Exam (taxa de acerto) | 39,5% | 34,2% | não informado | 38,2% |
| Uso de computador | OSWorld-2.0 (subconjunto offline, parcial) | 69,2% | 72,6% | não informado | não informado |
| Multimodal | Chartography | 71,6% | 71,0% | 46,2% | 66,3% |
| Multimodal | LVBench | 91,7% | 87,5% | 79,7% | 83,7% |
| Cibersegurança | CWE-bench v1 | 68,0% | 68,0% | 58,0% | 67,0% |
As vantagens mais largas do Argon estão em trabalho de conhecimento e em contexto longo. No GraphWalks entre 256 mil e 1 milhão de tokens, a distância para o segundo colocado é de 12,4 pontos percentuais, o que conversa diretamente com a promessa de trajetórias longas. No AutomationBench, da Zapier, são quase 9 pontos sobre o Opus 5.5. E no Harvey’s Legal Agent Benchmark o Argon marca 19,6% enquanto os três rivais ficam abaixo de 7%.
Esse último número pede um segundo olhar. Um benchmark em que o líder acerta menos de um quinto das tarefas diz mais sobre a dificuldade do teste do que sobre a prontidão de qualquer modelo para redigir um parecer sozinho. Pesquisa jurídica com agente continua, pelos números do próprio Google, uma área em que todo mundo erra a maior parte do tempo.
Em código, a história é dividida. O Argon vence o DeepSWE v1.1 por 3,7 pontos sobre o Opus 5.5, mas perde o FrontierSWE v2 para o GPT-6 Astra por 10,5 pontos e o Terminal-bench 4.0 para o Opus 5.5 por 9 pontos. Se o seu fluxo de trabalho vive no terminal, a tabela do Google aponta para o modelo da Anthropic. Se a tarefa é uma mudança longa numa base de código real, aponta para o Argon.
Há uma pequena divergência entre fabricantes que vale registrar. A tabela do Google atribui 58,2% ao GPT-6 Astra no Terminal-bench 4.0, enquanto a página de lançamento do GPT-6 Astra, da OpenAI, informa 57,9% no mesmo teste. A diferença é de 0,3 ponto e não muda o ranking, mas mostra que cada empresa roda o benchmark do jeito que escolhe. A Anthropic, por sua vez, divulga para o Opus 5.5 benchmarks que nem aparecem na tabela do Google, como FrontierCode v1.1 e CursorBench 4.0. Comparar lideranças autodeclaradas é, no fundo, comparar quais testes cada um decidiu mostrar.
O que o Argon já faz na prática dentro do Google
Dentro do Google, o Gemini 4 Argon já otimiza algoritmos quânticos, libera memória em data centers e reescreve bases de código de C/C++ para Rust, segundo os exemplos que a empresa incluiu no anúncio de 30 de setembro de 2026. São relatos do próprio fabricante sobre uso interno, sem auditoria externa, mas trazem números concretos o bastante para dar uma ideia do tipo de tarefa em que o modelo foi colocado.
Os quatro casos citados:
- Algoritmos quânticos: pesquisadores usam o Argon para reduzir os recursos de espaço-tempo (qubits vezes portas) de sub-rotinas que travam aplicações importantes. Em um dos exemplos, o modelo superou a baseline publicada em 40%, em questão de minutos.
- Memória nos data centers: um time de agentes Argon analisou a telemetria de profiling de toda a frota, identificou otimizações de memória e as aplicou por conta própria. Resultado após o rollout: mais de 300 TiB liberados, com estimativa total entre 500 TiB e 1 PiB.
- Migrações para Rust: agentes estão convertendo código C/C++ em escala que vai de dezenas de milhares de linhas, em bibliotecas como re2 e libgav1, até mais de 800 mil linhas no kernel Zircon do Fuchsia OS.
- Decodificador de vídeo libgav1: partindo de um port em Rust já existente, os agentes substituíram 32 mil linhas de código SIMD por Rust seguro, escrito para que o próprio compilador vetorizasse automaticamente. O decodificador ficou 2,7 vezes mais rápido que o port anterior, com saída de vídeo idêntica, e mais perto do C++ otimizado.
O caso do libgav1 é o que mais me interessou, porque descreve o método. Os agentes rodaram muitas rodadas de experimentos guiados por profile, estudaram a saída do compilador a cada rodada e ajustaram o código até a vetorização acontecer sozinha. Quem já tentou trocar intrínsecos SIMD escritos à mão por código que o compilador vetoriza sabe que esse ciclo (medir, ler o assembly gerado, reescrever, medir de novo) é lento e chato para um humano. É exatamente o tipo de loop em que um agente com muito orçamento de saída tem vantagem.
Mesmo assim, o Google faz questão de dizer que nada disso foi para produção sem revisão. As reescritas em larga escala passam por auditoria automatizada e manual, testes em emulação e revisão humana antes do rollout, justamente porque vários desses sistemas são críticos.
A lição para quem está fora do Google é menos sobre o modelo e mais sobre o processo. Uma migração de 800 mil linhas gerada por agente só é aceitável com um harness de verificação à altura, e montar esse harness costuma dar mais trabalho do que rodar o agente. Em projetos de engenharia de software com IA integrada, a parte que consome semanas raramente é o prompt. É a bateria de testes que decide se o código gerado pode ser confiado.
Defesa cibernética: como o Argon encontra e corrige vulnerabilidades
O Gemini 4 Argon foi treinado para encontrar, validar e corrigir vulnerabilidades críticas de software de forma autônoma, e o Google o considera seu modelo mais capaz em defesa cibernética até 30 de setembro de 2026. Essa é a frente que justifica o formato do lançamento: o primeiro grupo a receber o modelo é composto de defensores cibernéticos, que o usam sem os guardrails cibernéticos padrão para explorar a capacidade completa.
O caso mais concreto vem da Wiz, que já usa o Argon no Scan for Good, um programa que protege infraestrutura pública crítica de graça, encontrando e corrigindo exposições de alto risco. Em uma demonstração inicial, o modelo achou uma vulnerabilidade crítica que expunha dados pessoais sensíveis em um software hospitalar usado por hospitais no mundo inteiro.
“[…] identifying a severe risk that previous frontier models had missed.”
Anúncio do Gemini 4 Argon, Google, 30 de setembro de 2026
Se você trabalha com sistemas de saúde no Brasil, esse exemplo bate perto. Dado sensível de paciente exposto por software de prateleira é o tipo de incidente que a LGPD trata com o rigor máximo, e um scanner que acha o que os modelos anteriores deixaram passar muda a conta de risco.
Em correção de vulnerabilidades, o Argon empata na liderança. O CWE-bench v1, que mede a capacidade de remediar falhas de segurança (Pass@1, com desempate por Pass@4), tem três modelos em 68%:
- Grok 4.7, rodando no harness opencode: 68%
- Gemini 4 Argon, no Antigravity: 68%
- GPT-6 Astra, no Codex: 68%
- Claude Opus 5.5, no Claude Code: 67%
- Claude Fable 5.1, no Claude Code: 58%
- Grok 4.6, no opencode: 57%
- DeepSeek-V4.1-Flash e Muse Spark 1.3, ambos no opencode: 55%
Abaixo disso aparecem Hy4 Preview (53%), GPT-6 Sol (52%) e Inkling (37%). Repare que cada modelo roda em um harness de agente diferente, e o harness pesa no resultado. A pontuação mede o par modelo mais ferramenta, e um ponto percentual de diferença entre os quatro primeiros cabe dentro dessa variação.
O salto mais nítido é interno, contra o Gemini 3.8 Flash Cyber, o modelo especializado anterior do próprio Google. Em descoberta de vulnerabilidades reais, varrendo código-fonte em 20 linguagens, o Argon marca 85,8% contra 71,0% do 3.8 Flash Cyber. No benchmark de teste de penetração da Wiz, em que o modelo ataca sistemas web ao vivo sem acesso ao código-fonte, precisa mapear a superfície de ataque, identificar falhas e produzir uma prova de conceito que as valide, o resultado é 70,9% contra 58,2%.
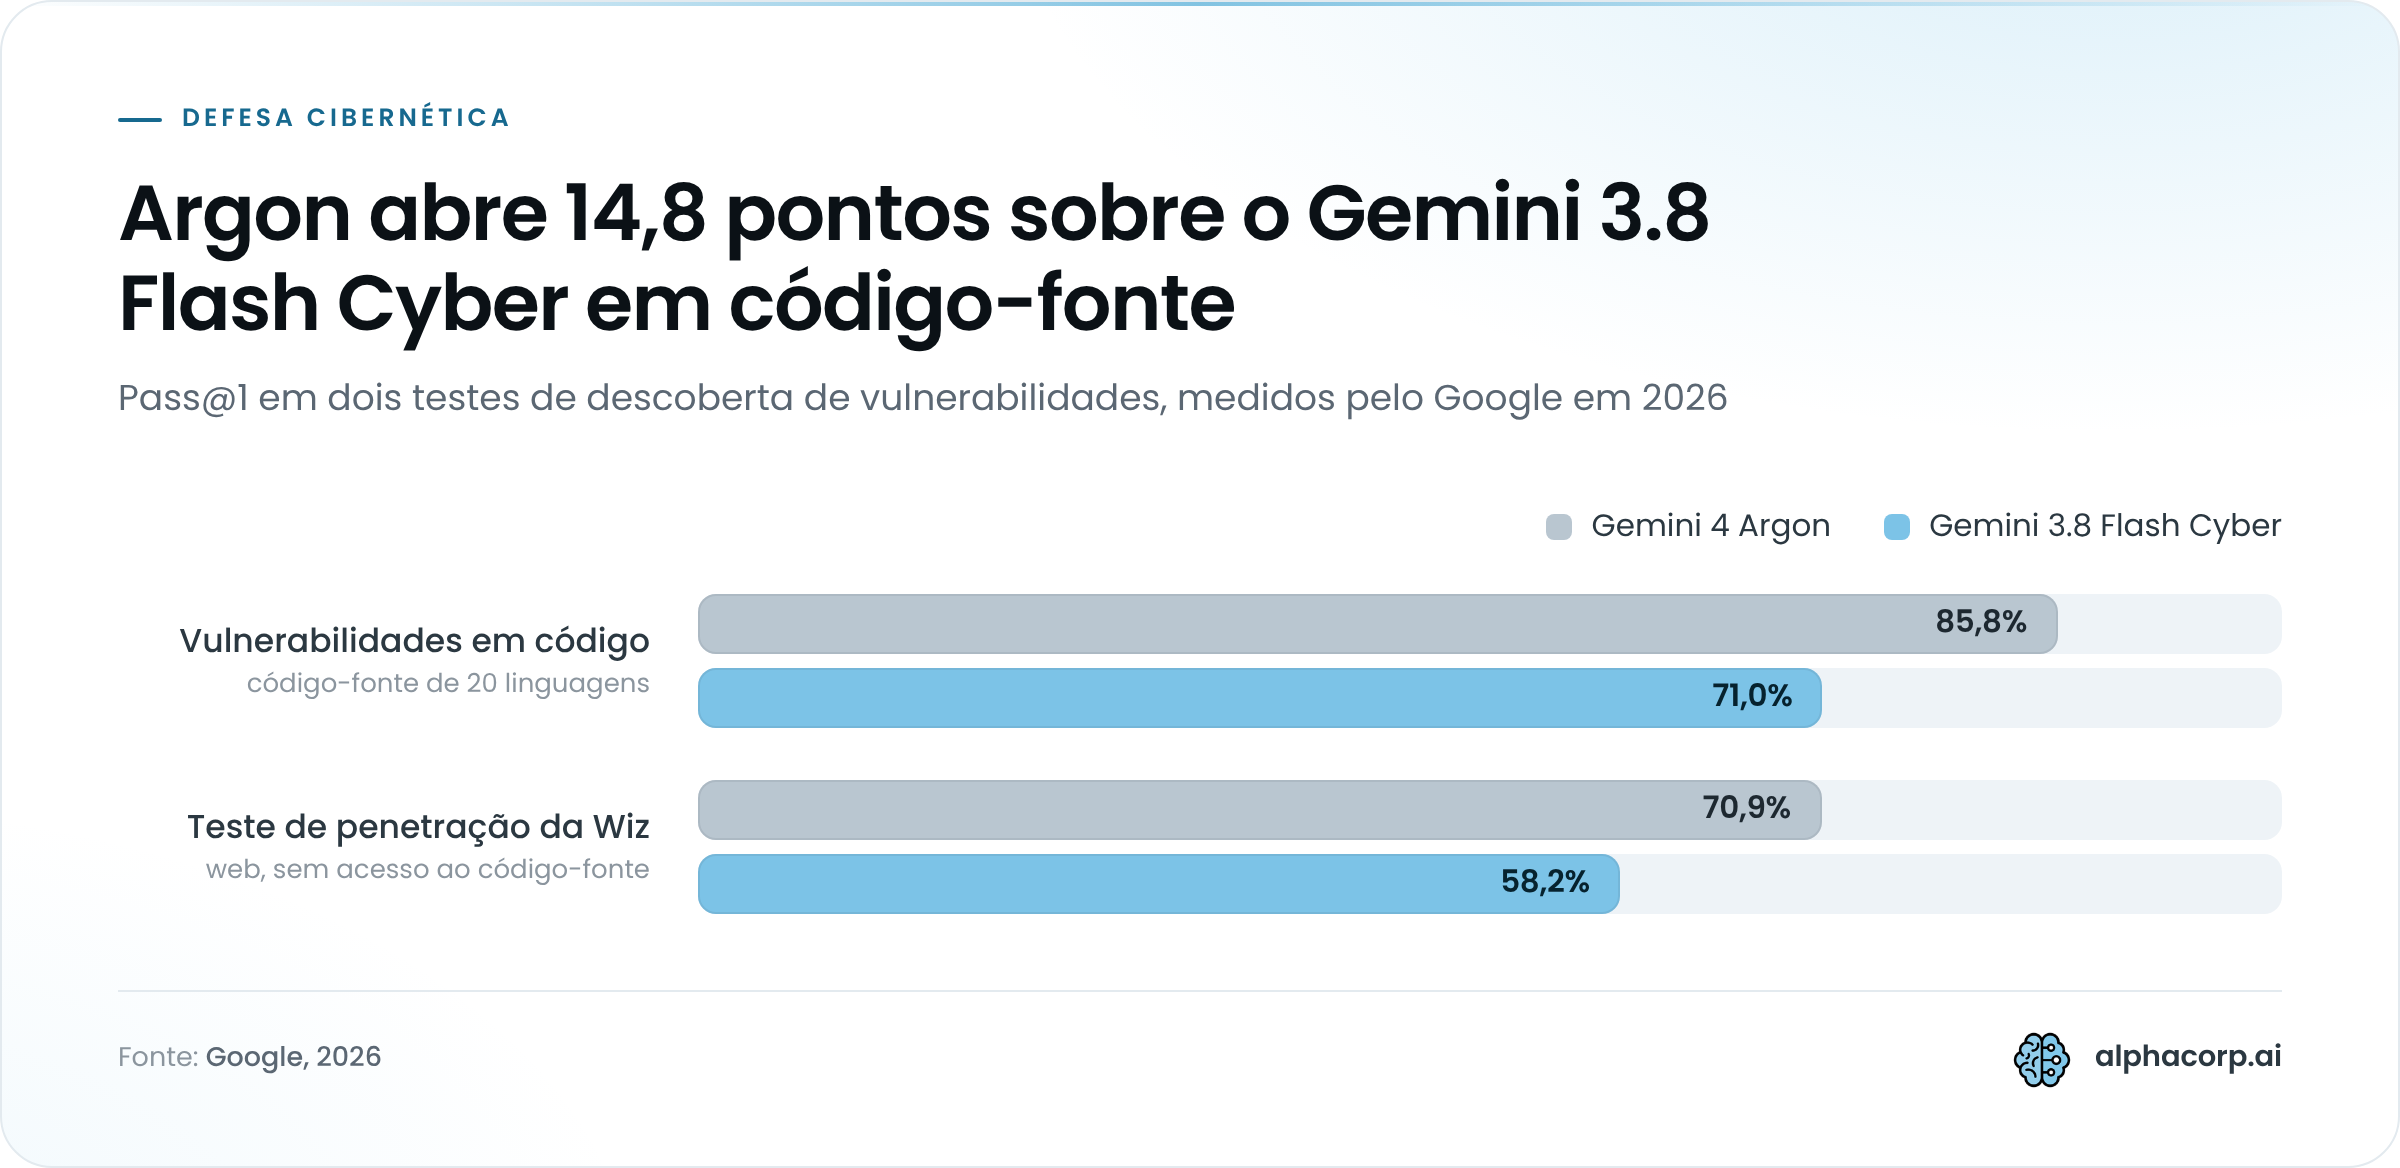
São 14,8 e 12,7 pontos percentuais de ganho em menos de um ciclo de modelo. O detalhe que me chama atenção é o teste da Wiz: descobrir falhas lendo código é uma coisa, e explorá-las num sistema em produção sem ver o código é outra, bem mais próxima do que um atacante de verdade faz. Um modelo que acerta sete em cada dez nessa condição é uma ferramenta de defesa e, nas mãos erradas, uma ferramenta de ataque. É por isso que a versão sem guardrails só sai para um grupo fechado.
Salvaguardas de segurança e riscos antes do lançamento amplo
Antes de abrir o Gemini 4 Argon ao público, o Google diz estar reforçando quatro frentes de proteção: recusa de pedidos de uso indevido (cibernético e CBRN), resistência a injeção de prompt indireta, monitoramento de desalinhamento na cadeia de raciocínio e isolamento dos ambientes de teste. Tudo isso está descrito no post de lançamento de 30 de setembro de 2026, e só nele. Não existe system card, model card nem relatório técnico do Argon publicado até essa data, então o que se pode avaliar é a descrição do fabricante, sem os números de avaliação que normalmente acompanham um documento desse tipo.
As quatro frentes, uma a uma:
- Uso indevido: o modelo foi desenhado para recusar pedidos que sirvam a ataques cibernéticos ou químicos, biológicos, radiológicos e nucleares (CBRN), preservando pesquisa científica legítima de uso duplo, conforme o Frontier Safety Framework do Google. A novidade declarada é o monitoramento das ativações internas do modelo para flagrar abuso, em vez de olhar só o texto que entra e sai. Red teams internos e externos atacaram essas salvaguardas com métodos manuais e automatizados.
- Injeção de prompt indireta: o ataque em que instruções maliciosas escondidas num documento, numa página ou num e-mail sequestram o comportamento do modelo. Com red teaming automatizado e treinamento adversarial, o Argon virou o modelo do Google que mais resiste a esse tipo de investida.
- Desalinhamento: um sistema acompanha a cadeia de raciocínio e as ações do Argon e interrompe a execução quando o modelo tenta cumprir a tarefa de um jeito que passa por cima da intenção do usuário.
- Ambientes de teste: os sandboxes são isolados e selados antes de qualquer treinamento ou avaliação de alto risco, seguindo o roteiro de controle de agentes do Google.
O único desses pontos com número público é a injeção de prompt. No benchmark Gray Swan de injeção indireta (IPI), que mede a taxa de sucesso do ataque em até 15 tentativas, quanto menor melhor:
| Modelo (2026) | Taxa de sucesso do ataque (k=15) |
|---|---|
| Gemini 4 Argon | 0,7% |
| Claude Opus 5.5 | 1,0% |
| Claude Fable 5.1 | 1,0% |
| Claude Opus 5 | 4,6% |
| Gemini 3.8 Flash | 5,5% |
| Gemini 3.8 Flash Cyber | 6,0% |
| GPT-6 Astra | 8,5% |
| GPT-6 Sol | 10,1% |
| Muse Spark 1.3 | 15,9% |
| GPT-5.6 Sol | 27,0% |
| GLM 5.3 | 31,5% |
| Grok 4.6 | 51,8% |
| Kimi K3 | 52,7% |
Leia esse 0,7% com cuidado. Ele significa que, com 15 tentativas por alvo, sete em cada mil ataques ainda passam. Para um agente que lê e-mails de clientes o dia inteiro, isso continua sendo um número, e o próprio Google admite que esse tipo de ataque exige vigilância constante e várias camadas de defesa. A distância para o GPT-6 Astra (8,5%) é grande, e a distância para o Grok 4.6 e o Kimi K3, em que mais da metade dos ataques funciona, é de outra ordem.
A decisão que mais me chamou atenção no anúncio está no monitoramento de desalinhamento. O Google usou um sistema parecido para vigiar os próprios treinamentos, com alertas para uma equipe de resposta a incidentes, e escolheu não realimentar o que encontrou no treinamento seguinte. O motivo declarado: se você treina o modelo para não disparar o monitor, ele aprende a esconder o raciocínio em vez de corrigi-lo. A empresa pede que o resto do setor preserve essa transparência da cadeia de raciocínio. É uma posição rara num post de produto, e concordo com ela.
O que o lançamento do Gemini 4 Argon significa para o Brasil
Para o Brasil, o lançamento do Gemini 4 Argon ainda não traz preço em real, data de chegada nem qualquer condição de disponibilidade própria: o anúncio de 30 de setembro de 2026 fala de acesso global restrito e não menciona nenhum mercado nacional. Quando a API abrir, a cobrança vai ser em dólar, no preço de lista global.
A demanda, por outro lado, já existe e cresce. A adoção de IA por empresas brasileiras subiu de 13% em 2024 para 17% em 2025, segundo a pesquisa TIC Empresas do Cetic.br, e o avanço se concentra justamente no público a que o Argon se dirige:
- Grandes empresas: 50% usam IA em 2025, contra 38% no ano anterior.
- Setor de Informação e Comunicação: 49% de adoção, o maior entre os setores.
- Pessoas: a TIC Domicílios 2025 estima cerca de 50 milhões de brasileiros usando IA generativa, o equivalente a 32% de quem tem acesso à internet.
- Desigualdade de acesso: 69% na classe A contra 16% nas classes D e E.
Esse último dado importa para quem constrói produto. Um modelo de fronteira em dólar, com limite de saída de 1 milhão de tokens, vai entrar primeiro nas grandes corporações e no setor de tecnologia, e a distância entre quem usa e quem não usa IA no país tende a se abrir mais antes de fechar.
No campo regulatório, o Brasil não tem lei específica de IA em vigor. Em dezembro de 2025, o Ministério da Gestão e da Inovação em Serviços Públicos enviou ao Congresso um projeto de lei complementar com um sistema de governança para a inteligência artificial, que coloca a Agência Nacional de Proteção de Dados (ANPD) como coordenadora de um futuro Sistema Nacional de Inteligência Artificial. O projeto ainda tramita. Até ele virar lei, o Argon vai operar no Brasil num vácuo regulatório específico de IA, mas inteiramente dentro da Lei 13.709/2018 (LGPD).
Na prática, isso muda pouco para quem já leva a LGPD a sério. Se o seu agente vai ler contratos, prontuários ou extratos de clientes, as obrigações sobre dados pessoais valem hoje, com ou sem Argon, e continuam valendo depois do PL. O que muda é a escala do que o modelo consegue processar de uma vez, e com ela o tamanho do estrago quando uma injeção de prompt passa ou um log vaza.
Perguntas frequentes sobre o Gemini 4 Argon
O Gemini 4 Argon já está disponível no Brasil?
Não. Desde 30 de setembro de 2026, o Gemini 4 Argon está liberado apenas para defensores cibernéticos do Fairwind Program e para equipes internas do Google, em qualquer país. O próximo grupo anunciado são clientes pagos da API e assinantes do Google AI Ultra, sem data confirmada e sem qualquer menção ao mercado brasileiro.
O Gemini 4 Argon é melhor que o GPT-6 Astra e o Claude Opus 5.5?
Depende da tarefa, e todos os números disponíveis são do próprio Google. Na tabela de 19 benchmarks do lançamento, o Argon lidera 13 e empata em um, com vantagem larga em trabalho de conhecimento, contexto longo e vídeo. O GPT-6 Astra vence em FrontierSWE v2, Terminal-Bench Science 0.1 e OSWorld-2.0, e o Claude Opus 5.5 vence em Terminal-bench 4.0 e PostTrainBench. Nenhum laboratório independente reproduziu essas comparações até 30/09/2026.
Qual a diferença entre o Gemini 4 Argon e o Gemini 3?
A diferença mensurável mais clara é o limite de saída: o Gemini 3, de 18 de novembro de 2025, gera no máximo 64 mil tokens por chamada, e o Argon gera até 1 milhão. A janela de entrada continua em 1 milhão de tokens nos dois. O Argon também foi treinado com foco em defesa cibernética e em tarefas longas de várias etapas, coisa que o Gemini 3 não tinha como frente principal.
Quanto custa usar a API do Gemini 4 Argon?
No preço introdutório, US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída, com entrada em cache a US$ 0,10 por milhão (95% de desconto). Depois do período introdutório, o preço sobe para US$ 4 de entrada e US$ 20 de saída. O Google não informou quanto tempo dura a fase introdutória nem quando a API abre para o público.
O que é o Fairwind Program do Google?
É um programa de acesso limitado do Google que oferece ferramentas de defesa cibernética a governos e parceiros que a empresa considera confiáveis. O Gemini 4 Argon é distribuído primeiro por esse canal, e é lá que o modelo roda sem guardrails cibernéticos. Não é um programa com inscrição aberta: uma empresa comum não consegue entrar por conta própria.
Por que o Google liberou o Argon sem guardrails cibernéticos?
Porque a capacidade de corrigir uma vulnerabilidade é a mesma capacidade de encontrá-la e explorá-la. Um guardrail que recusa pedidos ofensivos também recusa um teste de penetração legítimo, e o Google quer que defensores usem o modelo por inteiro. Por isso a versão sem guardrails só vai para o Fairwind Program e para times internos do Google, enquanto a versão para o público mantém as proteções contra uso indevido.
O Gemini 4 Argon tem model card ou system card?
Até 30 de setembro de 2026, não. O que existe é o post de lançamento no blog do Google, com as tabelas de benchmark e a descrição das salvaguardas, e uma página de metodologia de avaliação. Resultados de testes de segurança CBRN, detalhes do monitoramento de ativações internas e taxas de falso positivo dos guardrails não foram publicados.
Como se preparar para a chegada do Argon
Preparar-se para o Gemini 4 Argon, hoje, significa arrumar a casa em vez de esperar o modelo: definir tetos de custo, montar a bateria de testes e revisar o tratamento de dados pessoais antes de a API abrir. Quatro movimentos cabem nas próximas semanas:
- Fixe um limite de saída por requisição no seu código de agente. Um modelo que gera até 1 milhão de tokens numa chamada exige freio explícito, e o freio precisa existir antes do primeiro deploy.
- Desenhe a estratégia de cache agora. Separe o contexto que se repete (base de código, contrato, manual) do que muda a cada rodada, porque é essa divisão que decide a fatura.
- Rode suas cargas no Gemini 3.8 Flash e guarde os resultados. Quando o Argon chegar, você compara contra algo seu, em vez de contra a tabela do fabricante.
- Mapeie os dados pessoais que o agente vai tocar e alinhe o fluxo à Lei 13.709/2018 antes de trocar o modelo, porque a obrigação não muda com a versão.
Nos próximos anúncios, o que vale observar é a data de abertura da API, a duração do preço introdutório e a publicação de um system card. Se a sua equipe precisa de ajuda para transformar um modelo de fronteira em um agente que aguenta produção, o time da AlphaCorp AI monta o harness de testes junto com você.