Neste artigo(23)
- O que é o lançamento do Claude Sonnet 5.5 e o que muda em relação ao Sonnet 5
- Benchmarks do Claude Sonnet 5.5: os números frente ao Sonnet 5, ao Opus 5.5 e ao GPT-6 Sol
- As ressalvas que acompanham a tabela
- Quanto custa o Claude Sonnet 5.5
- Por que o preço igual resulta em tarefa mais barata
- Velocidade e níveis de esforço: como equilibrar custo e qualidade
- Desempenho em programação: o que os testes e os primeiros clientes mostram
- Trabalho de conhecimento, documentos e design
- Sonnet 5.5 ou Opus 5.5: qual modelo escolher
- Segurança, alinhamento e salvaguardas do novo modelo
- As três salvaguardas e quem elas afetam
- Como acessar o Claude Sonnet 5.5 e o que muda na migração
- O que o lançamento significa para empresas brasileiras
- O preço em dólar e o orçamento
- A LGPD e o envio de dados ao exterior
- Perguntas frequentes sobre o Claude Sonnet 5.5
- Quando o Claude Sonnet 5.5 foi lançado?
- O Claude Sonnet 5.5 é melhor que o Opus 5.5?
- Dá para usar o Claude Sonnet 5.5 de graça?
- Qual é o tamanho da janela de contexto do Claude Sonnet 5.5?
- O Claude Sonnet 5.5 funciona bem em português?
- Quando sai o Claude Haiku 5.5?
- Próximos passos para testar o modelo
O lançamento do Claude Sonnet 5.5, feito pela Anthropic em 28 de setembro de 2026, entrega um modelo mais de 30% mais rápido que o Sonnet 5, pelo mesmo preço por token. Ele marca 70,6% no Terminal-Bench 4.0 e quase empata com o Opus 5.5 em trabalho de conhecimento. Aqui você encontra as notas dos oito benchmarks com as ressalvas de cada um, a tabela de preços, as cinco mudanças que quebram integrações e o que a LGPD exige de quem envia dados à API. Os números valem para a data do anúncio.
Os dados que resumem o lançamento, todos de 2026 e publicados pela Anthropic no anúncio e na documentação do modelo:
- 70,6% no Terminal-Bench 4.0, contra 10,3% do Sonnet 5 e 66,4% do Opus 5.5
- US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída, valores iguais aos do Sonnet 5
- Custo por tarefa até 30% menor que o do Sonnet 5 nos testes da própria empresa
- 1.844 pontos no GDPval-AA v2.1, dois abaixo dos 1.846 do Opus 5.5
- Janela de contexto de 1 milhão de tokens, com corte de conhecimento em junho de 2026
O que é o lançamento do Claude Sonnet 5.5 e o que muda em relação ao Sonnet 5
O lançamento do Claude Sonnet 5.5, feito pela Anthropic em 28 de setembro de 2026, trouxe o segundo modelo da família Claude 5.5: mais rápido que o Sonnet 5, com o mesmo preço por token e notas bem maiores nos testes. Ele chega três meses depois do Sonnet 5, de 30 de junho de 2026, e uma semana depois do Opus 5.5, de 22 de setembro.
A própria empresa resume a proposta em uma frase:
“It’s a clear upgrade over Claude Sonnet 5, runs 30%+ faster, and costs up to 30% less for most work.” Página oficial de lançamento do Claude Sonnet 5.5, da Anthropic
O papel dele na linha é claro. O Opus 5.5 fica com o trabalho complexo, que pede julgamento cuidadoso. O Sonnet 5.5 cuida das tarefas cotidianas bem delimitadas: corrigir bugs, montar documentos, apresentações e planilhas.
A Anthropic organiza as melhorias sobre o Sonnet 5 em cinco eixos:
- Desempenho: 70,6% no Terminal-Bench 4.0, contra 10,3% do Sonnet 5, e dois pontos abaixo do Opus 5.5 no GDPval-AA
- Colaboração: texto mais claro que o da geração anterior, segundo os primeiros testadores
- Custo: preço por token igual ao do Sonnet 5, com custo por tarefa até 30% menor nos testes da empresa
- Velocidade: geração de saída mais de 30% mais rápida, a maior já registrada em um modelo Sonnet
- Alinhamento e segurança: resultado igual ou melhor que o do Sonnet 5 na maioria das medidas, e o primeiro Sonnet a sair com salvaguardas cibernéticas
Um detalhe curioso entra na conta do desempenho: é o primeiro Sonnet a terminar Pokémon Red trabalhando só com capturas de tela.
As especificações básicas mudaram pouco. A exceção é o corte de conhecimento.
| Especificação | Claude Sonnet 5.5 |
|---|---|
| Janela de contexto | 1 milhão de tokens |
| Saída máxima (API síncrona) | 128 mil tokens |
| Saída máxima (API de lotes, com cabeçalho beta) | 300 mil tokens |
| Corte de conhecimento confiável | junho de 2026 |
| Raciocínio adaptativo | ativado por padrão |
| Aposentadoria | não antes de 28 de setembro de 2027 |
O corte de conhecimento do Sonnet 5 era janeiro de 2026. Para quem pergunta ao modelo sobre bibliotecas e versões lançadas no primeiro semestre, esses cinco meses pesam mais do que parece.
Benchmarks do Claude Sonnet 5.5: os números frente ao Sonnet 5, ao Opus 5.5 e ao GPT-6 Sol
Os benchmarks do Claude Sonnet 5.5 mostram o modelo acima do Sonnet 5 nos oito testes divulgados pela Anthropic em 28 de setembro de 2026, perto do Opus 5.5 na maioria deles e à frente do GPT-6 Sol em três dos quatro com nota publicada. A exceção é o FrontierCode.
| Benchmark | O que mede | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | Tarefas profissionais em linha de comando | 70,6% | 10,3% | 66,4% | não divulgado |
| FrontierCode 1.1 | Código que pode entrar no merge sem edição humana | 46,2% (Max), 52,1% (Xhigh) | 42,4% | 54,4% | 49,3% |
| CursorBench 4.0 | Tarefas de sessões reais no Cursor | 55,5% | 34,1% | 57,8% | não divulgado |
| GDPval-AA v2.1 | Trabalho real de 44 ocupações em nove setores | 1.844 | 1.449 | 1.846 | 1.487 |
| AA-Briefcase v1.1 | Trabalho de conhecimento de longa duração | 1.811 | 1.359 | 1.822 | 1.483 |
| Humanity’s Last Exam | 2.500 questões na fronteira do conhecimento | 64,5% | 54,9% | 67,7% | não divulgado |
| OSWorld 2.1 | Uso de computador por interface gráfica | 80,1% | 57,0% | 81,8% | não divulgado |
| Chartography | Leitura visual de gráficos | 61,6% | 15,6% | 64,4% | 53,6% |
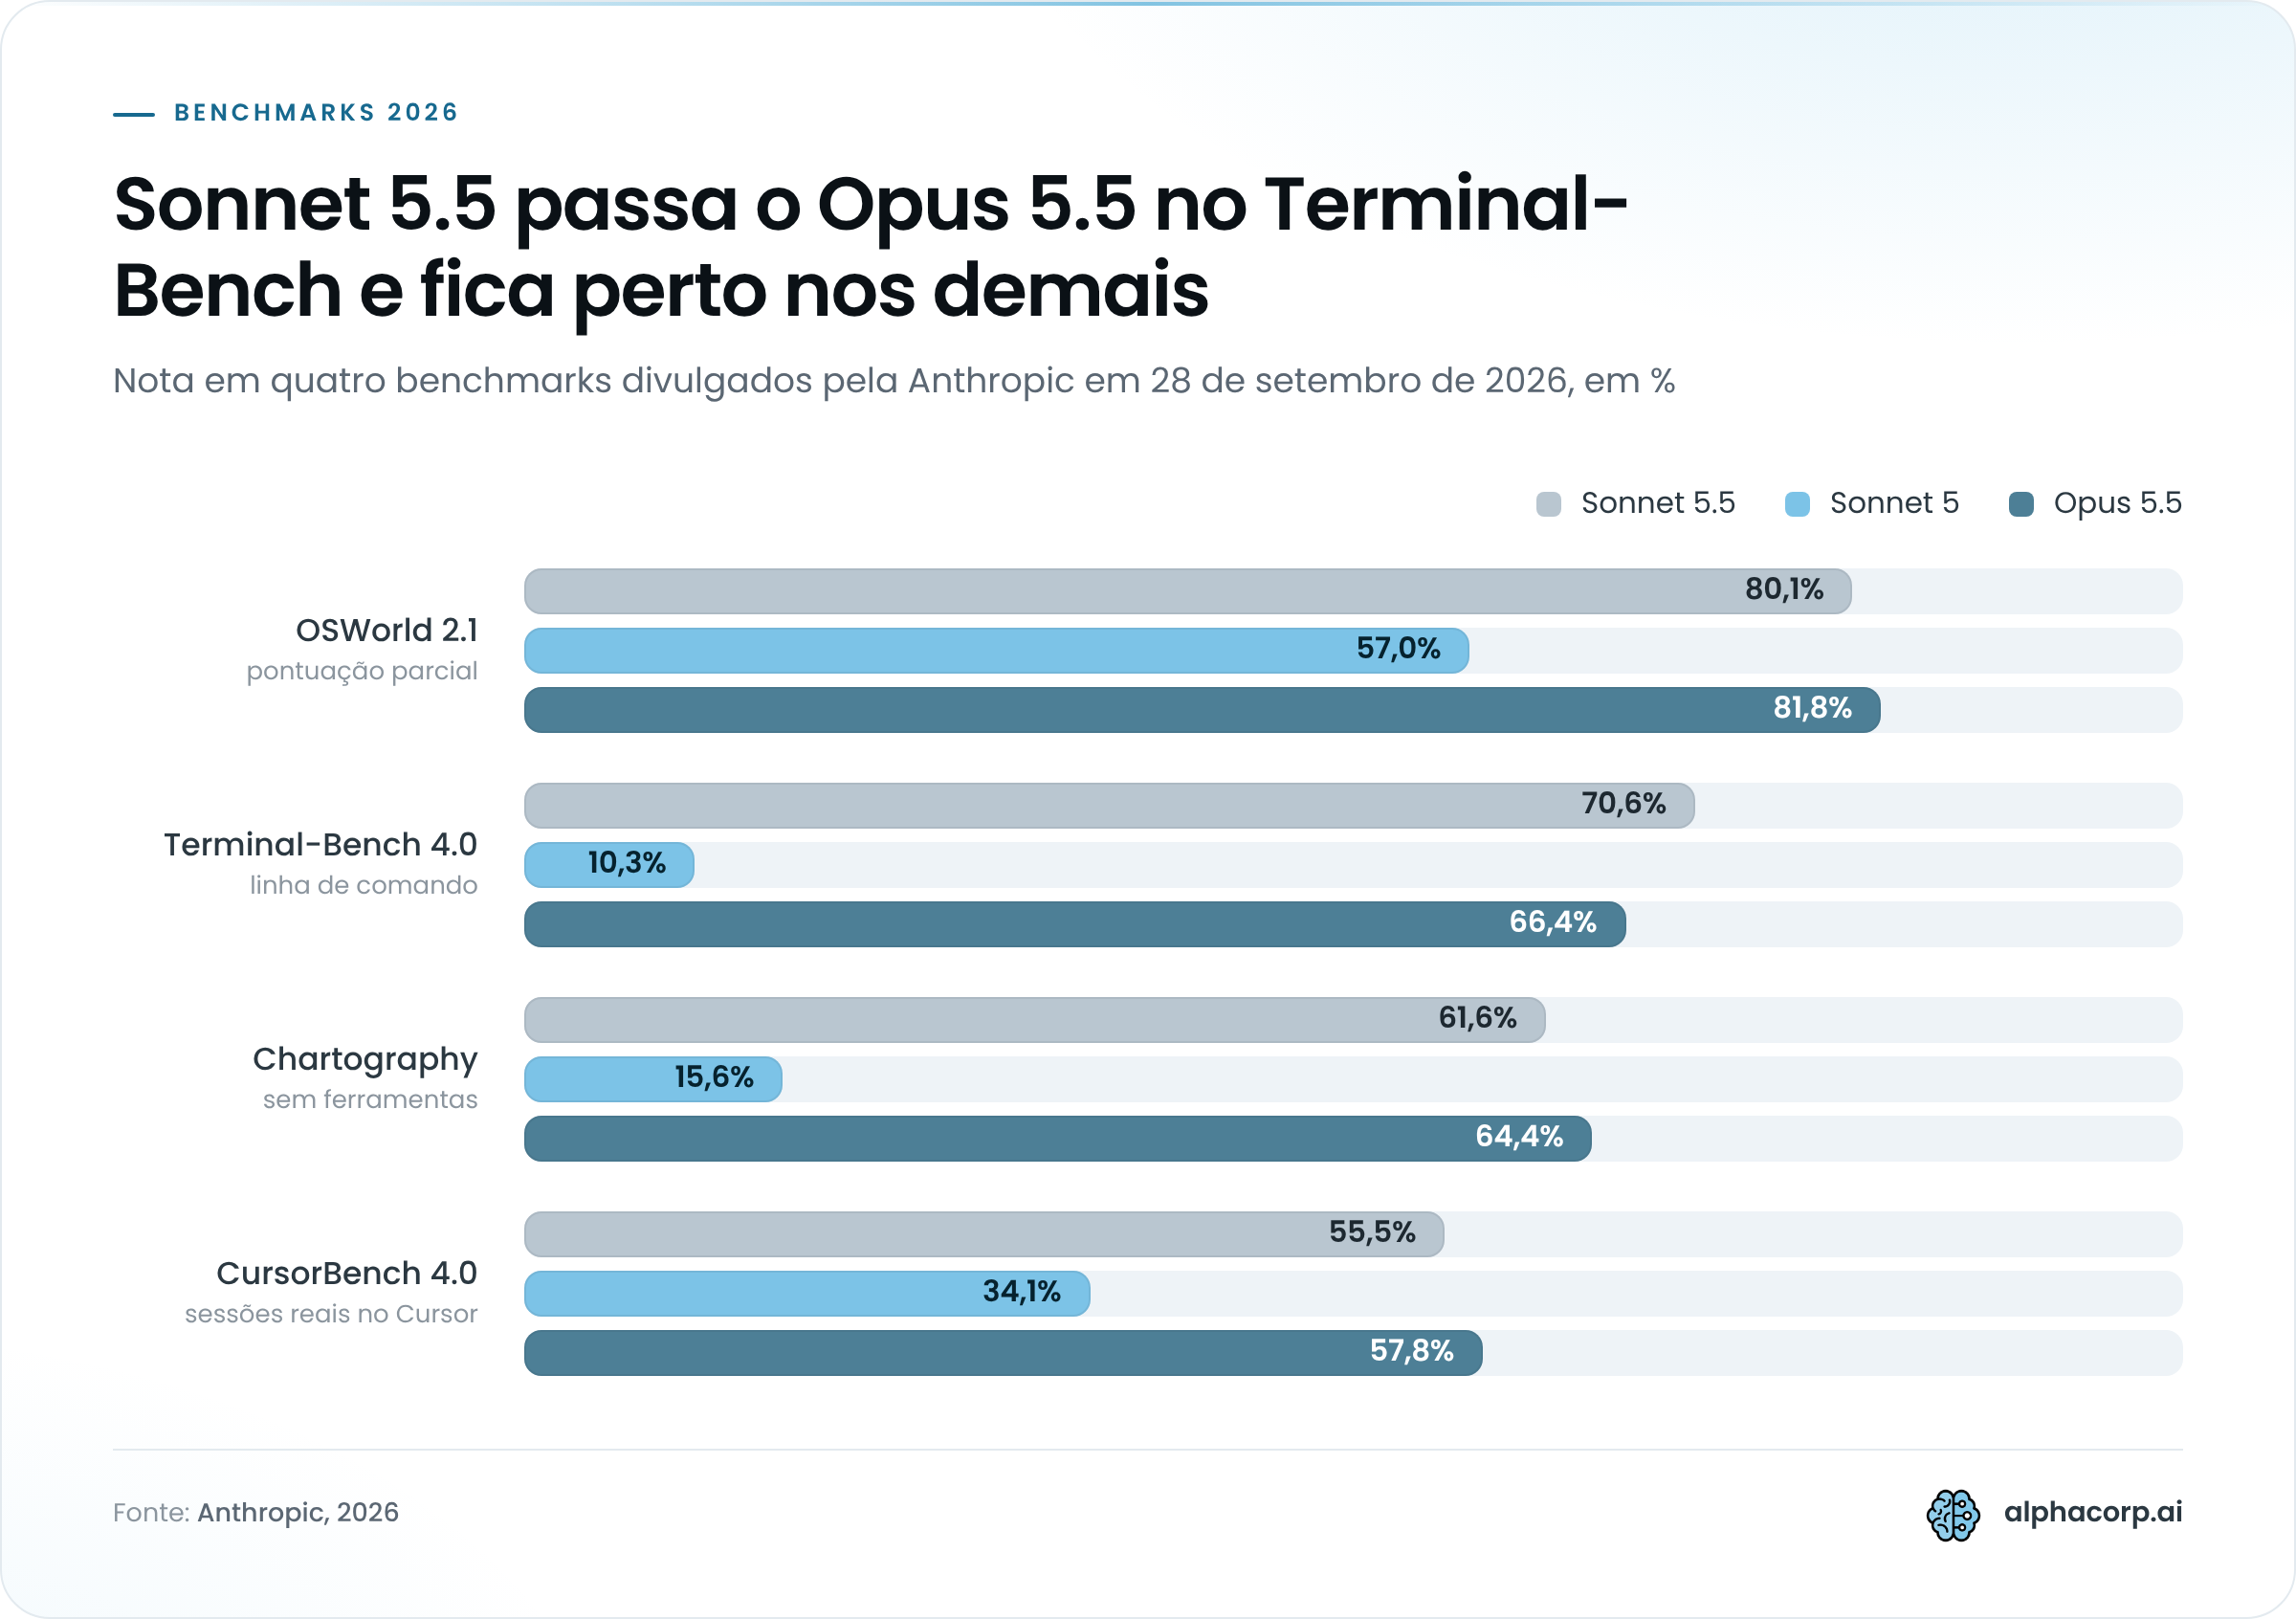
Três condições de teste acompanham esses números. O Humanity’s Last Exam foi rodado com ferramentas, o Chartography sem elas, e o OSWorld 2.1 usa pontuação parcial.
O salto que mais chama atenção é o do Terminal-Bench: de 10,3% para 70,6% em uma geração. A versão 4.0 da suíte é bem mais difícil que as anteriores, o que explica a nota baixa do Sonnet 5. Repare também que o Sonnet 5.5 passa o Opus 5.5 nesse teste, e a nota do Opus já é a melhor dele, obtida no esforço Xhigh.
As ressalvas que acompanham a tabela
Na minha leitura, as notas de rodapé do anúncio informam mais do que a tabela. São quatro pontos:
- FrontierCode no esforço Max: o Sonnet 5.5 marca 46,2% no Max e 52,1% no Xhigh. O teste pune alterações fora do escopo, mesmo quando são boas. No Max, o modelo acionou mais vezes a revisão de código do Claude Code, que distribui o trabalho entre subagentes, e em dois casos examinados pela Cognition isso gerou timeout ou edições além do pedido
- GDPval-AA e AA-Briefcase: a Artificial Analysis rodou os dois em uma versão de pré-lançamento com um bug que degradava respostas com saídas estruturadas. A Anthropic espera efeito pequeno, que subestimaria a nota, e já corrigiu o bug
- GPT-6 Sol: a OpenAI corrigiu um bug que prejudicava a leitura de imagens, e as notas do modelo no GDPval-AA, no AA-Briefcase e no Chartography podem ser anteriores ao ajuste
- Terminal-Bench: não existe nota pública do GPT-6 Sol, e os gráficos da Anthropic usam o GPT-5.6 Sol no lugar
Falta ainda um aviso da própria Anthropic. Nota de benchmark captura uma faceta só, e a empresa afirma que o Opus 5.5 continua mais forte em trabalho complexo e aberto.
Quanto custa o Claude Sonnet 5.5
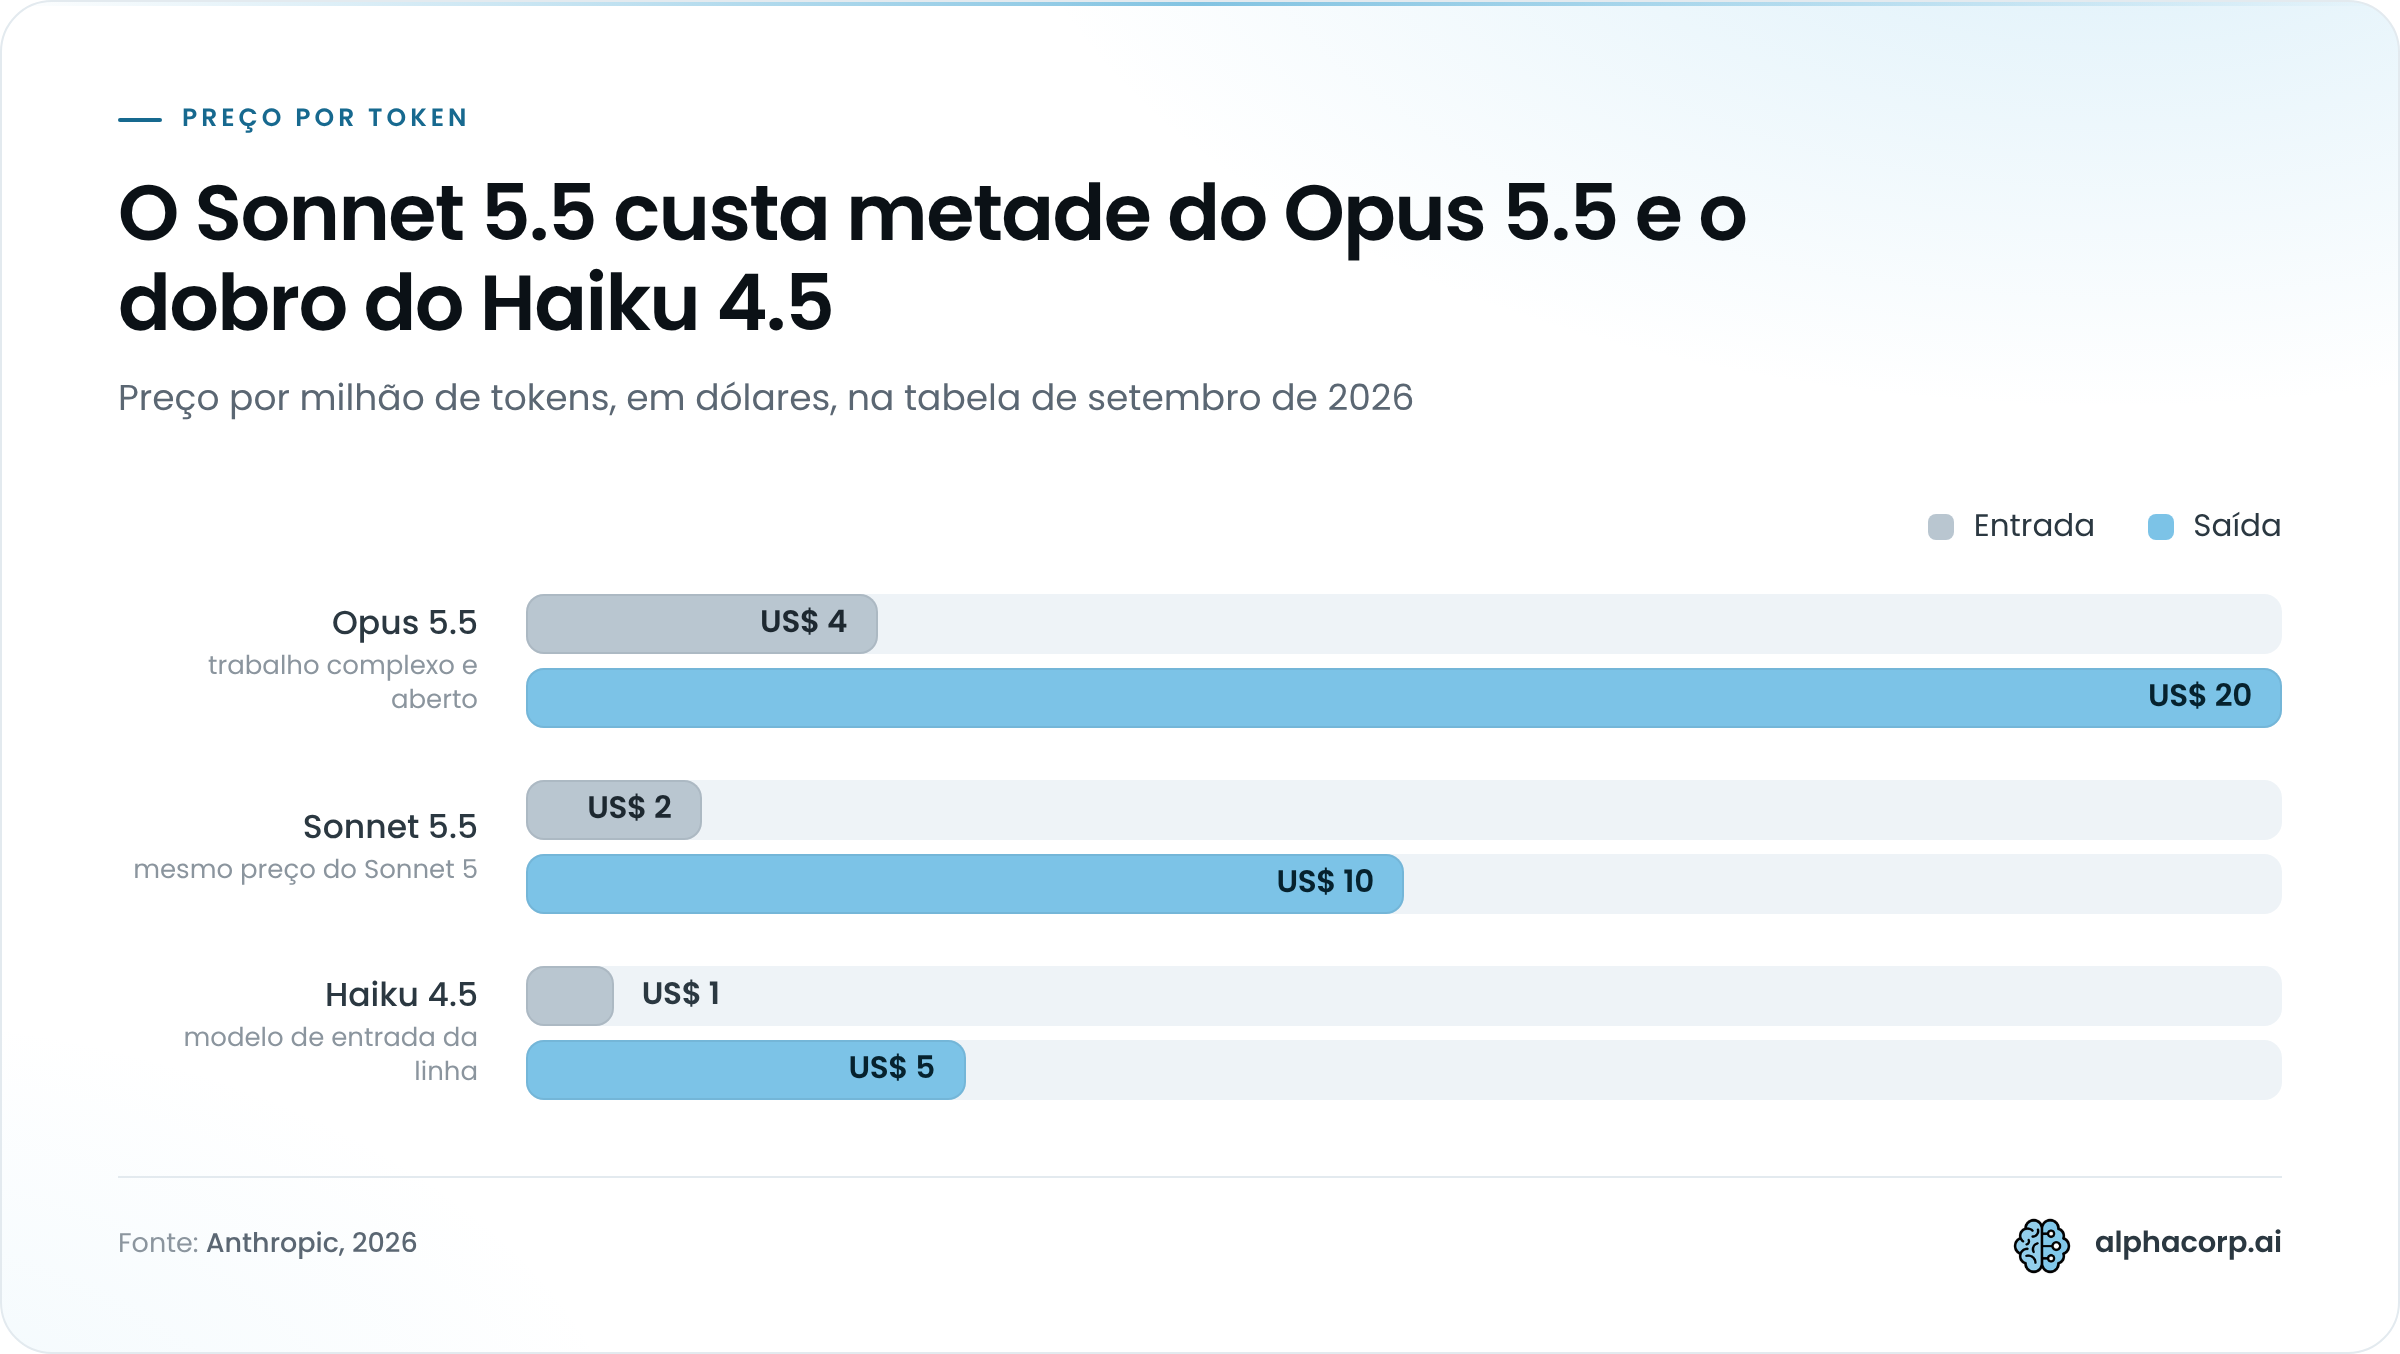
O Claude Sonnet 5.5 custa US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, os mesmos valores do Sonnet 5. A tabela de preços na documentação do Sonnet 5.5, consultada em 28 de setembro de 2026, traz os itens abaixo.
| Item | Preço por milhão de tokens |
|---|---|
| Entrada | US$ 2,00 |
| Saída | US$ 10,00 |
| Escrita em cache (5 minutos) | US$ 2,50 |
| Escrita em cache (1 hora) | US$ 4,00 |
| Leitura de cache | US$ 0,20 |
| API de lotes | 50% de desconto sobre entrada e saída |
O modelo continua no meio da linha. O Opus 5.5 custa o dobro, US$ 4 na entrada e US$ 20 na saída, depois de uma queda de cerca de 40% frente ao Opus 5. O Haiku 4.5 custa a metade: US$ 1 e US$ 5. A leitura de cache sai pelos mesmos US$ 0,20 no Sonnet 5.5 e no Opus 5.5.
Por que o preço igual resulta em tarefa mais barata
A fatura depende de quantos tokens cada tarefa consome. O preço por token ficou parado, mas o Sonnet 5.5 gasta menos tokens para chegar ao mesmo resultado. Nos testes da Anthropic, o custo por tarefa caiu até 30% em relação ao Sonnet 5.
O mecanismo é simples. O modelo agrupa mais chamadas de ferramentas em uma mesma etapa, então termina o trabalho em menos passos. Cada passo a menos corta tokens de saída, que custam cinco vezes o valor dos de entrada.
Duas ressalvas. O número de 30% é um teto medido pela própria Anthropic, e a economia real varia com a carga de trabalho. Além disso, preço por token é um péssimo critério isolado para comparar modelos. Em agentes de IA em produção, a métrica que fecha com a fatura é o custo por tarefa concluída, medido nas suas próprias tarefas.
Velocidade e níveis de esforço: como equilibrar custo e qualidade
O Claude Sonnet 5.5 gera saída mais de 30% mais rápido que o Sonnet 5, e o nível de esforço, que vai de Low a Max, é o parâmetro que troca custo e tempo de resposta por qualidade. No anúncio de 28 de setembro de 2026, a Anthropic o apresenta como o Sonnet mais rápido que já lançou.
O esforço funciona de um jeito simples. Nos níveis baixos, o modelo responde mais depressa e gasta menos tokens, o que serve para trabalho de rotina. Nos altos, ele raciocina por mais tempo e confere o próprio trabalho com mais cuidado, então a tarefa custa mais e, em geral, a nota sobe.
São cinco níveis: Low, Medium, High, Xhigh e Max. O padrão muda conforme o produto.
| Produto | Esforço padrão | Efeito esperado |
|---|---|---|
| Apps do Claude | Medium | Resposta mais rápida, menos tokens |
| Claude Code | Medium | Resposta mais rápida, menos tokens |
| Claude Platform (API) | High | Mais raciocínio, custo maior por tarefa |
Essa diferença de padrão tem efeito prático. Você valida um prompt no app, em Medium, leva para a API sem declarar o esforço, e o mesmo prompt passa a rodar em High. A resposta pode até melhorar, mas a latência e a fatura mudam sem que ninguém tenha mexido no código. Declare o esforço em toda chamada.
Os gráficos do anúncio cruzam a nota de cada modelo com o custo por tarefa em cada nível de esforço, com o eixo de custo em escala logarítmica. Quanto mais perto do canto superior esquerdo, mais capacidade por dólar. As leituras que importam são três:
- Em vários benchmarks, o Sonnet 5.5 em Low ou Medium supera a melhor nota do Sonnet 5 por cerca de um décimo do custo por tarefa
- No Terminal-Bench 4.0, em Medium, o Sonnet 5.5 passa com folga a melhor nota do Sonnet 5 (10,3%) por menos de um décimo do custo
- Frente ao Opus 5.5, o Sonnet 5.5 compensa mais nos níveis baixos, em que custa menos por tarefa. Nos níveis altos, os dois entregam desempenho comparável a custo parecido
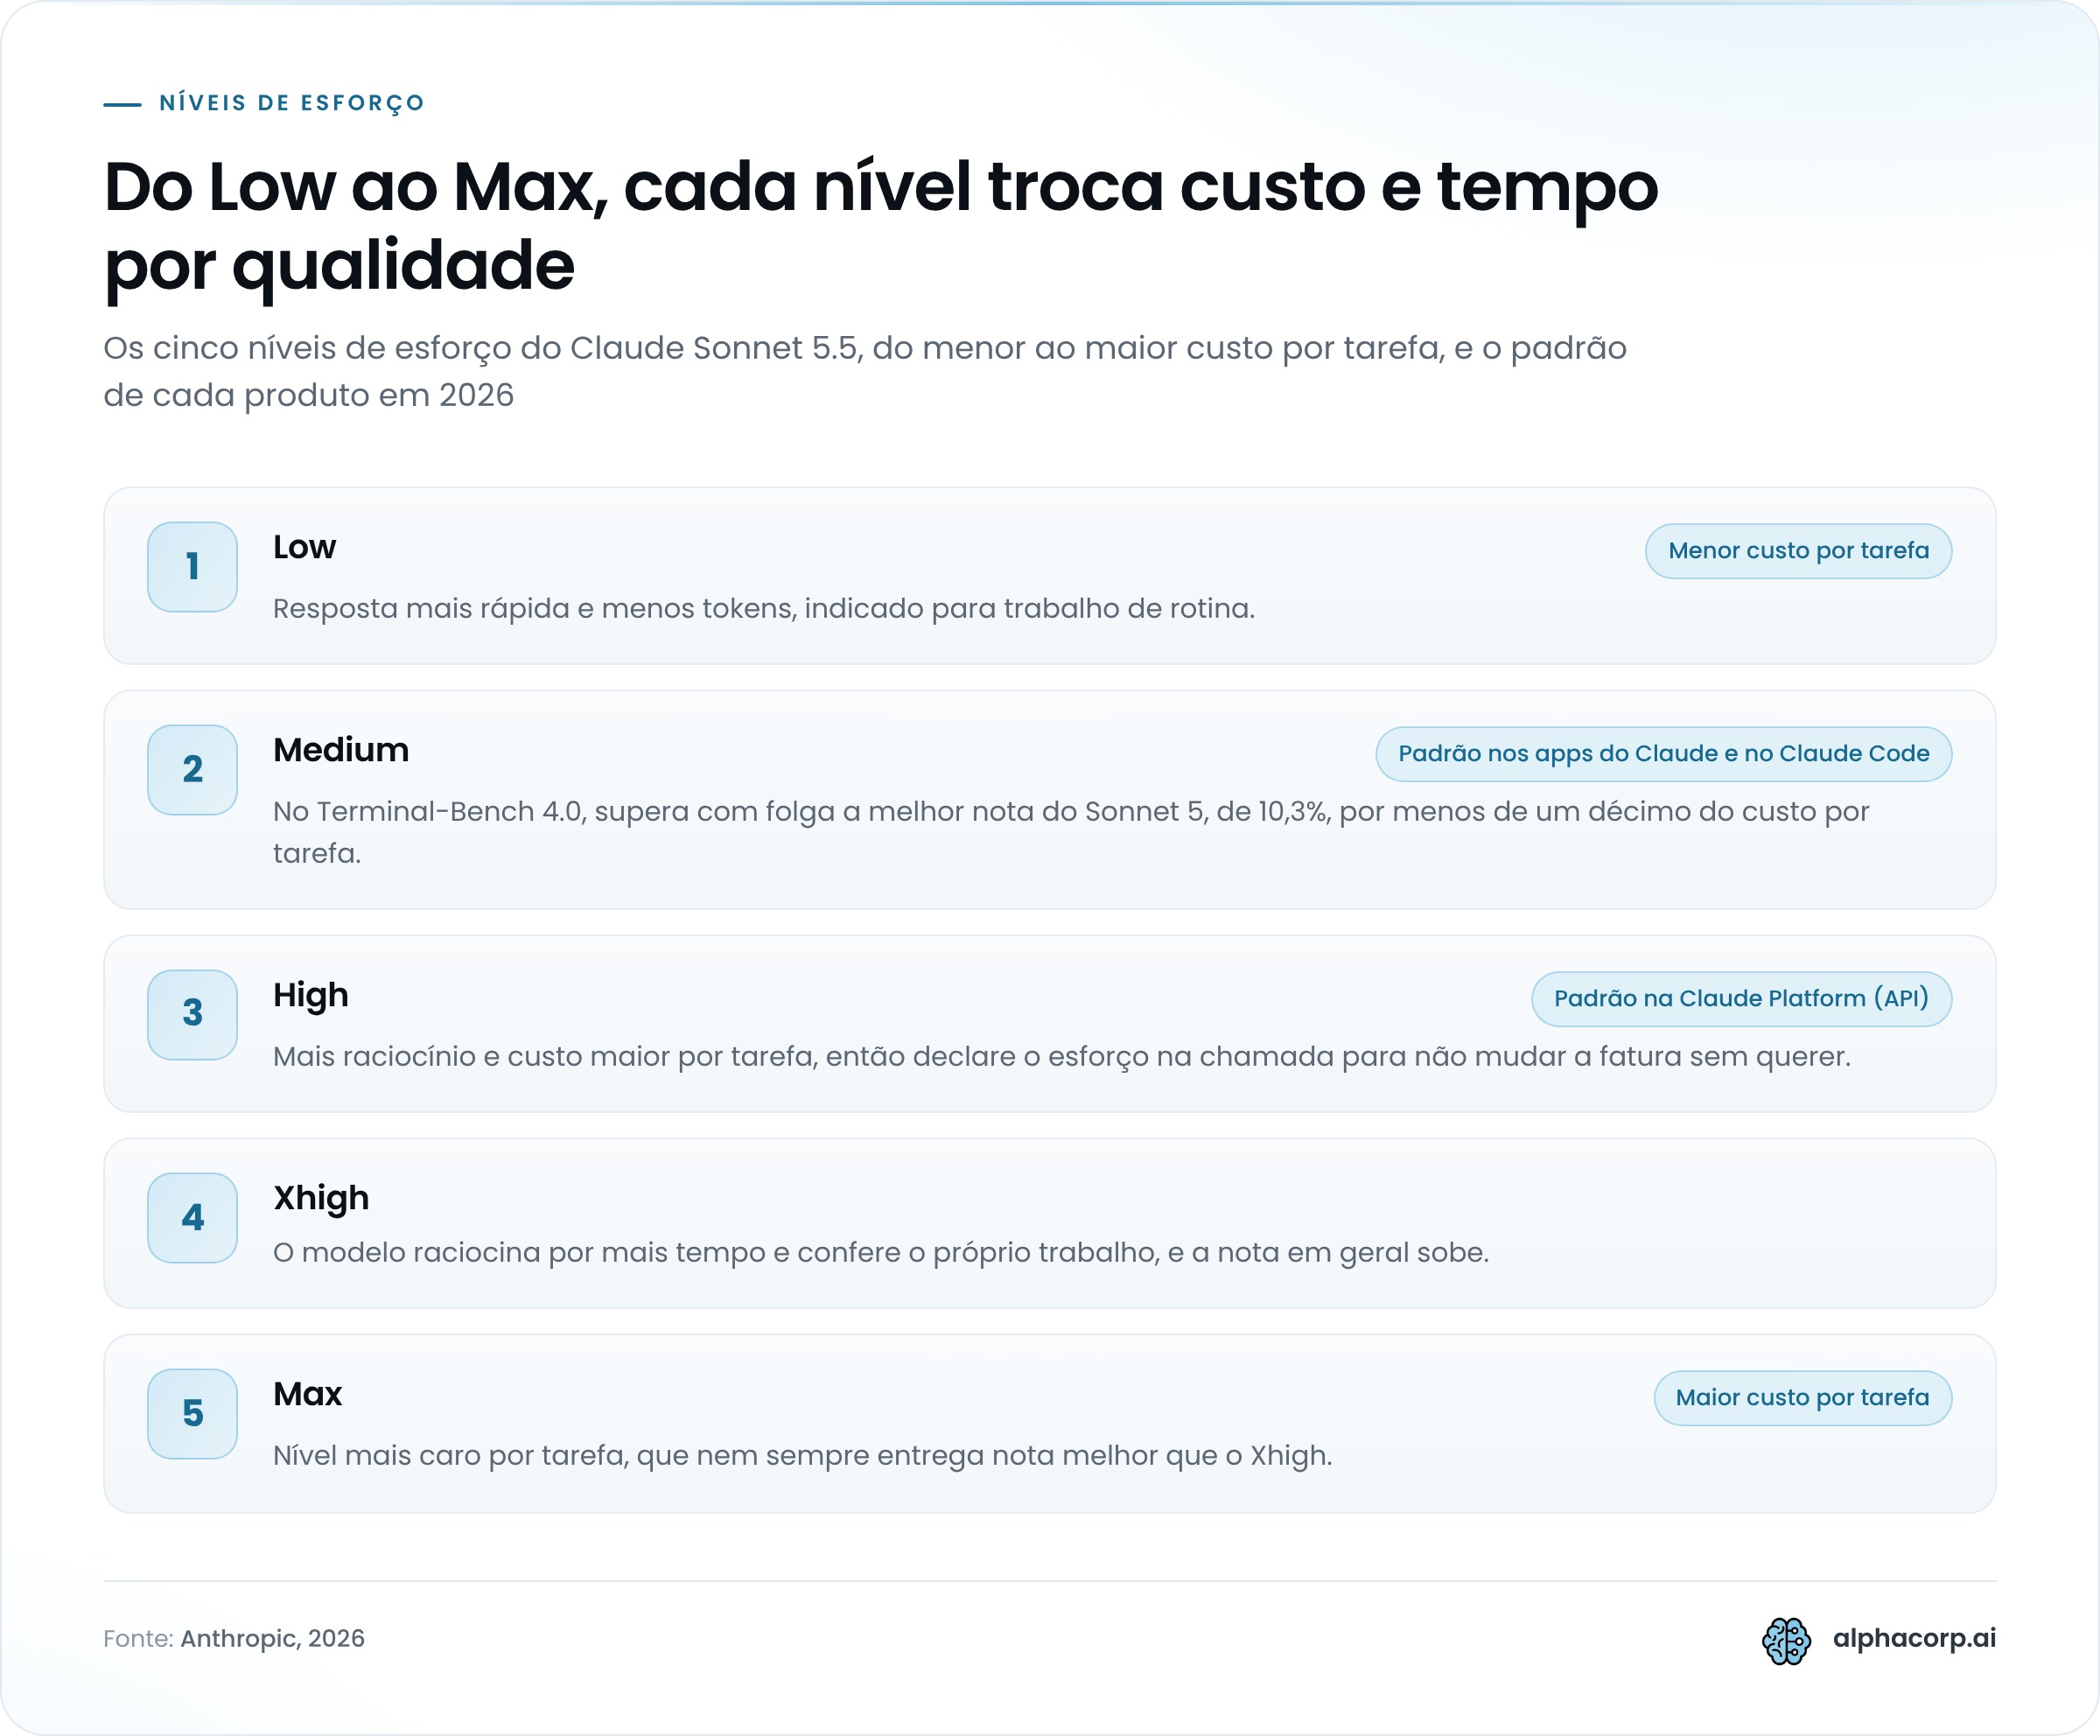
Subir o esforço ao máximo também não garante resultado melhor. No FrontierCode 1.1, a nota do Sonnet 5.5 em Max ficou abaixo da nota em Xhigh. Comece por Medium, meça nas suas tarefas e só suba quando a qualidade pedir.
Desempenho em programação: o que os testes e os primeiros clientes mostram
O desempenho do Claude Sonnet 5.5 em programação é o ganho mais visível do lançamento: nos testes divulgados em 28 de setembro de 2026, ele resolve mais tarefas de código que o Sonnet 5, em menos etapas e por uma fração do custo. No FrontierCode, em esforço High, marca 10 pontos a mais que o Sonnet 5 na mesma configuração, por cerca de um quinze avos do custo por tarefa.
Os outros dois testes de código apontam na mesma direção. No CursorBench, montado com tarefas de sessões reais no Cursor, a melhor nota do Sonnet 5.5 fica a cerca de dois pontos da nota do Opus 5.5. Já o Terminal-Bench avalia agentes em tarefas realistas de linha de comando, como engenharia de software e administração de sistemas, que é o tipo de trabalho que um agente de código faz no dia a dia.
Dois comportamentos explicam o resultado, segundo os primeiros testadores:
- Leitura da base de código: o modelo entende rápido um repositório que nunca viu
- Chamadas de ferramentas agrupadas: em execuções lado a lado, ele juntou mais chamadas em uma mesma etapa que o Sonnet 5
- Menos etapas por tarefa: com as chamadas agrupadas, o trabalho termina em menos passos e custa menos
O anúncio traz depoimentos de Epic Games, Every, CodeRabbit, SpaceXAI, Base44 e Unity. O mais detalhado é o de Daniel Vogel, diretor de operações da Epic Games:
“The new model managed tens of thousands of lines of code for gameplay system architecture, kept responses snappy, handled multi-hour tasks, and delivered with less prescriptive prompting.”
Vogel diz ainda que o modelo passou em uma auditoria de design de sistema e em uma revisão de fluxo de dados, no nível esperado de um modelo de categoria superior.
Cabe uma ressalva. Depoimento em página de lançamento é escolhido pelo fornecedor, e nenhum deles vem com metodologia publicada. O trecho sobre “less prescriptive prompting” é o que mais interessa a quem mantém prompts longos herdados do Sonnet 5: se o modelo precisa de menos instrução, parte daquele texto virou custo de entrada sem retorno.
Teste isso no seu repositório antes de acreditar. Em projetos de desenvolvimento de software com IA integrada, o que decide a troca de modelo é a taxa de PRs aceitos sem retrabalho, medida no seu próprio código.
Trabalho de conhecimento, documentos e design
No trabalho de conhecimento, o Claude Sonnet 5.5 praticamente empata com o Opus 5.5: marca 1.844 pontos no GDPval-AA v2.1, contra 1.846 do modelo mais caro, e fica cerca de 400 pontos acima do Sonnet 5. Os números são do anúncio da Anthropic de 28 de setembro de 2026.
O teste tem uma origem curiosa. O GDPval foi criado pela OpenAI para medir tarefas reais de 44 ocupações nos nove setores que mais pesam no PIB americano, com avaliação por comparação direta com especialistas humanos. A versão usada aqui, a GDPval-AA, é rodada pela Artificial Analysis.
Os demais resultados da área seguem o mesmo padrão:
- Uso de computador: nota próxima à do Opus 5.5 no OSWorld 2.1, que mede agentes operando interface gráfica em fluxos longos
- Leitura de gráficos: nota próxima à do Opus 5.5 no Chartography
- Trabalho de longa duração: resultado acima do Sonnet 5 e do GPT-6 Sol no AA-Briefcase
Parte do ganho não cabe em nota. Os primeiros testadores descrevem um modelo que conversa de forma mais natural, dá acabamento a interfaces e segue templates de slides a ponto de a apresentação pedir pouca edição.
Um teste interno ilustra isso. A Anthropic entregou ao modelo os materiais de resultado trimestral de uma empresa de capital aberto, as transcrições das teleconferências e um template, e pediu uma revisão operacional de 10 slides. Dois especialistas consideraram o primeiro rascunho pronto para envio. É um caso só, com dois avaliadores, conduzido pela própria empresa.
Entre os clientes citados estão Slack, Zendesk, Balyasny Asset Management, Box, Lovable e Atlassian. Curtis Allen, engenheiro principal do Slack, trouxe o dado mais concreto:
“Without changing any of our prompts, Claude Sonnet 5.5 did better than Sonnet 5 on almost all of our offline Slackbot evals, in fewer steps and with about 14% fewer output tokens.”
Repare no “almost all”. Alguma avaliação do Slackbot piorou ou ficou igual, e o depoimento não diz qual.
Para quem trabalha no Brasil, há um limite nesses testes. O GDPval mede ocupações da economia americana, e nenhum dos resultados publicados avalia documentos em português ou tarefas presas a normas brasileiras. Um relatório para a diretoria ou uma planilha de conciliação fiscal precisam entrar no seu próprio conjunto de avaliação.
Sonnet 5.5 ou Opus 5.5: qual modelo escolher
Entre Sonnet 5.5 e Opus 5.5, escolha o Sonnet 5.5 para tarefas cotidianas bem delimitadas e iteração rápida, e o Opus 5.5 para trabalho complexo e aberto, que exige julgamento sustentado por muitas etapas. Essa é a divisão que a Anthropic descreve no anúncio de 28 de setembro de 2026, e ela vale mesmo com as notas dos dois modelos tão próximas.
A pergunta que decide é outra: a tarefa tem escopo fechado? Corrigir um bug com teste que falha, montar uma planilha a partir de um template e revisar um PR pequeno têm começo, fim e critério de aceite. Uma migração de arquitetura sem especificação não tem.
| Tipo de tarefa | Modelo indicado | Motivo |
|---|---|---|
| Correção de bugs e tarefas de código bem delimitadas | Sonnet 5.5 | Metade do preço por token e resposta mais rápida |
| Documentos, apresentações e planilhas | Sonnet 5.5 | É o ponto forte declarado do modelo |
| Iteração rápida em tarefas menos complexas | Sonnet 5.5 em Low ou Medium | Menor custo por tarefa nos níveis baixos |
| Trabalho aberto, longo e com decisões de julgamento | Opus 5.5 | Mais forte nos testes internos e externos da Anthropic |
| Alto volume com orçamento apertado | Haiku 4.5 hoje, Haiku 5.5 depois | O Haiku 5.5 está previsto para as próximas semanas |
O nível de esforço muda a conta. O Sonnet 5.5 complementa melhor o Opus 5.5 quando roda em esforço baixo. Nos níveis altos, os dois chegam a desempenho comparável por custo parecido, e aí a vantagem de preço do Sonnet 5.5 desaparece.
O Opus 5.5 também ficou mais econômico nesta geração. No anúncio do modelo, Mario Rodriguez, do GitHub, relata que ele resolveu mais tarefas em menos da metade das etapas que o Opus 5 em testes no VS Code, e Noyan Tokgozoglu, da Optiver, fala em qualidade igual com custo de 40% a 50% menor.
Na prática, poucas equipes precisam escolher um só. O desenho mais comum é rotear: Sonnet 5.5 como padrão e Opus 5.5 para as tarefas que o padrão não fecha.
Segurança, alinhamento e salvaguardas do novo modelo
Em segurança e alinhamento, o Claude Sonnet 5.5 iguala ou supera o Sonnet 5 na maioria das medidas e é o primeiro modelo Sonnet lançado com salvaguardas cibernéticas e classificadores contra destilação. A Anthropic publicou os resultados em 28 de setembro de 2026, com um System Card dedicado ao modelo.
A avaliação teve escopo limitado, e a empresa explica o motivo. Como o Sonnet 5.5 não avança a fronteira de capacidade dos modelos da casa, os testes se concentraram em riscos que valem para qualquer nível: agir contra o interesse do usuário, enganar o usuário e cooperar com uso indevido de alto risco.
Os resultados divulgados:
- Auditoria comportamental automatizada: em cerca de 1.850 cenários, o Sonnet 5.5 iguala ou supera o Sonnet 5 na maioria das medidas de alinhamento, resistência a uso indevido e honestidade
- Contenção: o modelo chega perto do Opus 5.5 na raridade com que tenta escapar do sandbox, e é o que menos testa os limites dos containers entre todos os modelos da Anthropic
- Comparação geral: o Opus 5.5 ainda se sai um pouco melhor na auditoria completa
- Objetivos conflitantes: a empresa não encontrou evidência de que o modelo persiga metas contrárias à intenção do usuário
A Anthropic admite que nenhum conjunto de avaliações pega toda falha e que o modelo pode ter tendências ainda não encontradas. Por isso existem as salvaguardas.
As três salvaguardas e quem elas afetam
| Salvaguarda | Como funciona | Quem sente |
|---|---|---|
| Cibersegurança | Tarefas de maior risco passam, de forma visível, para o Sonnet 5 | Equipes de segurança ofensiva e defensiva |
| Biologia | Mesmas proteções do Sonnet 5 | Alguns pedidos de microbiologia e virologia, sinalizados por engano |
| Destilação | Classificadores impedem a extração de raciocínio, e o raciocínio fica preso à conta que o gerou | Quem move conversas entre contas |
Encontrar e corrigir bugs no próprio código continua liberado. O efeito prático aparece em produtos de segurança: se a sua aplicação faz análise de vulnerabilidades, parte das respostas pode vir do Sonnet 5, que é o modelo mais fraco. Registre nos logs qual modelo respondeu cada chamada.
Dois programas de verificação ampliam o acesso. O Life Sciences Verification Program já aceita pedidos de organizações da área de biologia. O Cyber Verification Program expandido ainda vai abrir, com acesso em níveis ao Sonnet 5.5, ao Opus 5.5 e aos modelos Claude Mythos.
O momento do lançamento pesa na leitura. Em 12 de setembro de 2026, o CEO da Anthropic publicou o ensaio em que Dario Amodei defende desacelerar o avanço de capacidades para que as práticas de segurança acompanhem os modelos, e a empresa anunciou uma parceria com a Accenture para dar a avaliadores externos acesso permanente aos sistemas de desenvolvimento. O Sonnet 5.5 é o segundo lançamento depois desse texto. Um modelo que declaradamente não avança a fronteira combina com o discurso.
Como acessar o Claude Sonnet 5.5 e o que muda na migração
O Claude Sonnet 5.5 está disponível desde 28 de setembro de 2026 na API da Claude, na Amazon Bedrock, no Google Cloud Vertex AI, no Microsoft Foundry e na Claude Platform on AWS, e a migração a partir do Sonnet 5 envolve cinco mudanças que quebram compatibilidade. O modelo também pode ser usado com retenção zero de dados, como o Opus 5.5 e o Sonnet 5.
| Plataforma | Identificador do modelo |
|---|---|
| API da Claude | claude-sonnet-5-5 |
| Amazon Bedrock | anthropic.claude-sonnet-5-5 |
| Google Cloud Vertex AI | claude-sonnet-5-5 |
| Microsoft Foundry | claude-sonnet-5-5 |
Trocar o identificador não basta. Estas são as cinco mudanças que podem quebrar uma integração feita para o Sonnet 5:
- Raciocínio desligado: quem roda o Sonnet sem raciocínio precisa adotar o parâmetro
between_tools, que mantém o raciocínio prévio desligado, antes de migrar - Uso forçado de ferramentas: passa a retornar erro
- Blocos de raciocínio: ficam vinculados ao modelo e à conversa que os gerou
- Uso de computador: a ferramenta antiga
computer_20251124deixa de ser aceita na API da Claude e no Google Cloud - Ferramenta advisor: rejeita Claude Opus 4.8, Opus 4.7 e Sonnet 5 como conselheiros
O item 3 merece atenção. A documentação fala em vínculo com o modelo e a conversa, e o anúncio acrescenta que o raciocínio não pode ser separado da conta que o criou. A Anthropic diz que a maioria dos desenvolvedores não vai notar diferença. Quem nota é quem move conversas entre contas, inclusive trocando de conta no meio de uma sessão do Claude Code.
Existe ainda uma mudança que não quebra nada, mas altera comportamento: o texto que o modelo escreve entre chamadas de ferramentas passa a vir dentro de blocos de thinking. Se a sua interface mostra ao usuário mensagens de progresso lidas desses trechos, confira o que aparece na tela depois da troca.
A ordem segura é ajustar o between_tools primeiro, ainda no Sonnet 5, e só depois apontar para o novo identificador. O guia de migração da Anthropic detalha cada item.
O que o lançamento significa para empresas brasileiras
Para empresas brasileiras, o lançamento do Claude Sonnet 5.5 significa um modelo intermediário mais capaz pelo mesmo preço em dólar, sem nenhuma mudança nas exigências da LGPD para envio de dados ao exterior. Ele chega com a adoção de inteligência artificial (IA) em alta no país.
A pesquisa TIC Empresas do Cetic.br sobre uso de IA mediu esse avanço entre 2024 e 2025.
| Indicador | 2024 | 2025 |
|---|---|---|
| Empresas brasileiras que usam IA | 13% | 17% |
| Grandes empresas que usam IA | 38% | 50% |
| Uso de geração de linguagem natural, entre as empresas que usam IA | 20% | 30% |
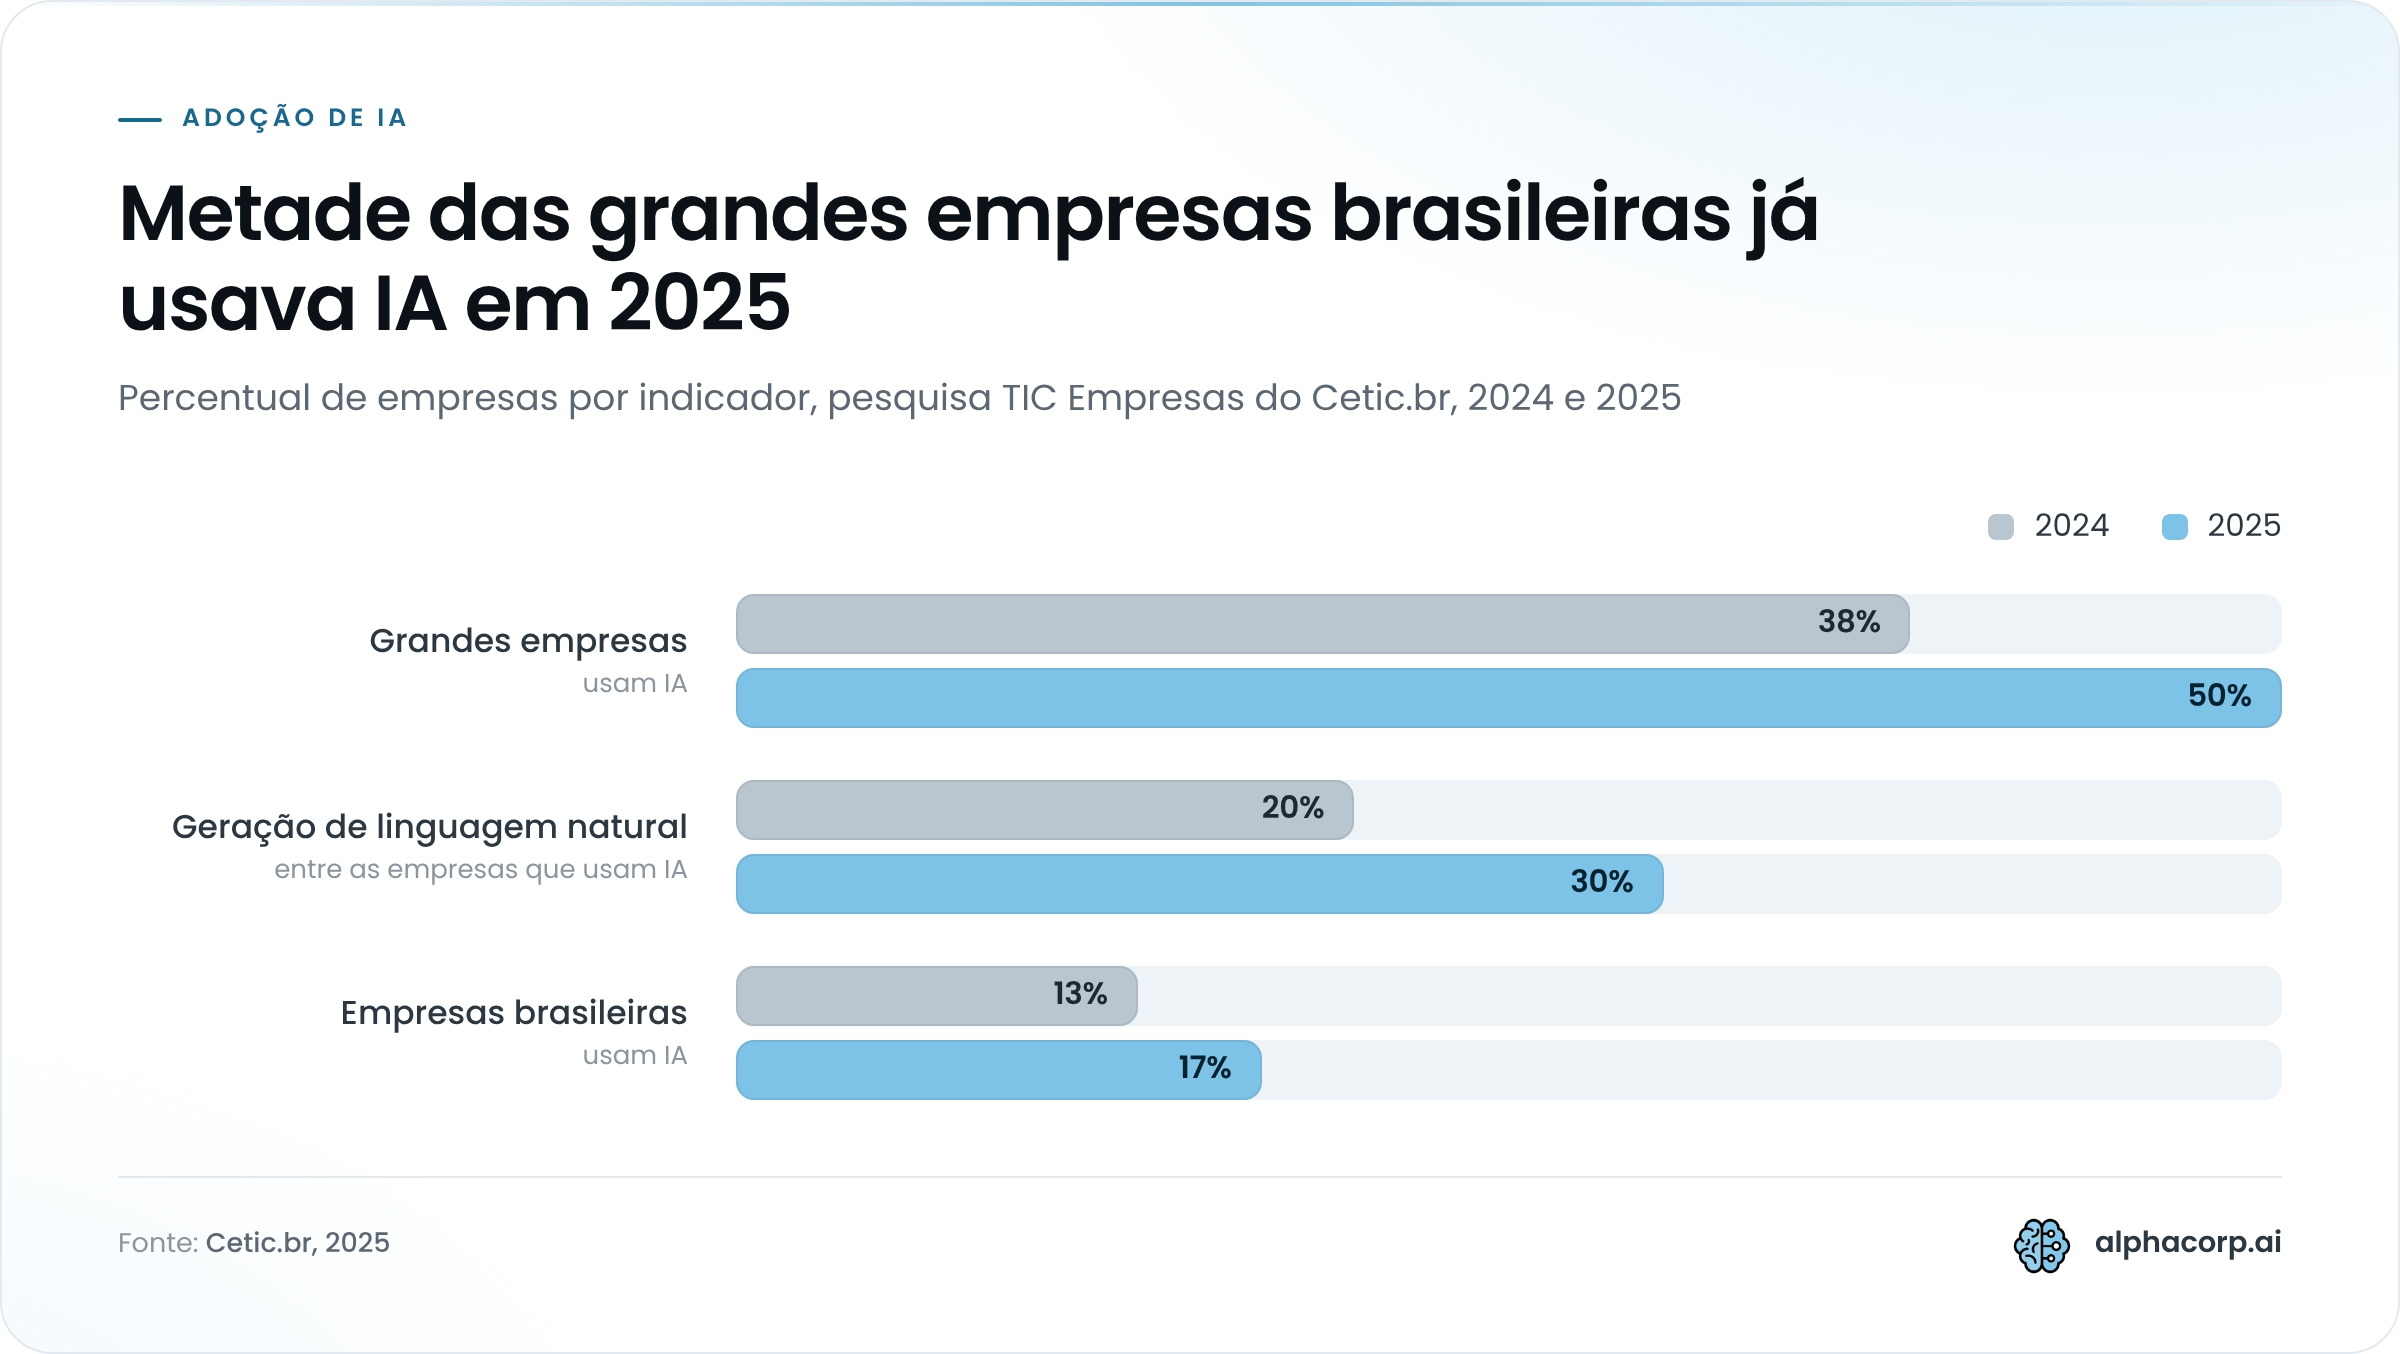
A geração de linguagem natural foi a ferramenta que mais cresceu, e é nessa categoria que entram modelos como o Sonnet 5.5. Metade das grandes empresas do país já usava IA em 2025.
O preço em dólar e o orçamento
A cobrança é em dólar. Como o valor por token ficou igual ao do Sonnet 5, a linha do orçamento continua exposta ao câmbio, e o que o modelo novo altera é a quantidade de tokens gasta por tarefa. Se o consumo cair nas suas cargas, a fatura cai junto. Meça antes de refazer a previsão do ano.
A LGPD e o envio de dados ao exterior
Quem manda dados pessoais para a API transfere esses dados para fora do Brasil, porque o Claude roda em infraestrutura da Anthropic e de provedores de nuvem parceiros. A Lei 13.709/2018 (LGPD) exige um mecanismo válido para isso. As orientações da Agência Nacional de Proteção de Dados sobre transferência internacional tratam de cláusulas contratuais padrão e da verificação do nível de proteção no país de destino.
Trocar de modelo não altera esse quadro. Se você cuida dos dados de uma fintech ou de uma operadora de saúde, levante quais campos saem do país antes do primeiro teste com dados reais.
Perguntas frequentes sobre o Claude Sonnet 5.5
As perguntas frequentes sobre o Claude Sonnet 5.5 giram em torno de seis pontos: data de lançamento, comparação com o Opus 5.5, acesso gratuito, janela de contexto, uso em português e a chegada do Haiku 5.5. As respostas abaixo valem para 28 de setembro de 2026.
Quando o Claude Sonnet 5.5 foi lançado?
A Anthropic lançou o Claude Sonnet 5.5 em 28 de setembro de 2026. O modelo saiu três meses depois do Sonnet 5, de 30 de junho de 2026, e uma semana depois do Opus 5.5, de 22 de setembro de 2026. A documentação oficial o classifica como a versão mais recente da linha Sonnet.
O Claude Sonnet 5.5 é melhor que o Opus 5.5?
Na maior parte dos testes, o Opus 5.5 ainda fica à frente, por margem pequena. O Sonnet 5.5 vence no Terminal-Bench 4.0, com 70,6% contra 66,4%, e fica dois pontos atrás no GDPval-AA v2.1. A Anthropic afirma que o Opus 5.5 continua mais forte em trabalho complexo e aberto, e o Sonnet 5.5 custa a metade por token.
Dá para usar o Claude Sonnet 5.5 de graça?
O anúncio de 28 de setembro de 2026 não menciona acesso gratuito. A Anthropic publicou os preços da API, de US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída, e informou que o modelo roda nos apps do Claude com esforço Medium por padrão. Para saber quais planos dos apps incluem o modelo, consulte a página de planos da empresa.
Qual é o tamanho da janela de contexto do Claude Sonnet 5.5?
A janela de contexto do Claude Sonnet 5.5 é de 1 milhão de tokens, o que equivale a cerca de 555 mil palavras em inglês. A saída máxima é de 128 mil tokens na API síncrona e pode chegar a 300 mil tokens na API de lotes, com o cabeçalho beta output-300k-2026-03-24. Texto em português tem outra relação entre palavras e tokens, então conte os tokens dos seus próprios documentos.
O Claude Sonnet 5.5 funciona bem em português?
A Anthropic não publicou nenhuma nota por idioma neste lançamento. Os oito benchmarks divulgados não separam resultados em português, e o GDPval-AA se baseia em ocupações da economia americana. Para saber como o modelo se sai no seu caso, monte um conjunto de teste com seus textos e compare com o modelo que você usa hoje.
Quando sai o Claude Haiku 5.5?
O Claude Haiku 5.5 está previsto para “as próximas semanas”, segundo o anúncio de 28 de setembro de 2026, sem data marcada. Ele vai ser o modelo da família Claude 5.5 voltado a aplicações de alto volume e sensíveis a custo. Até lá, o modelo de entrada da linha é o Haiku 4.5, a US$ 1 por milhão de tokens de entrada e US$ 5 por milhão de saída.
Próximos passos para testar o modelo
O próximo passo depois do lançamento do Claude Sonnet 5.5 é rodar um teste comparativo com as suas próprias tarefas, porque nenhuma nota de benchmark substitui esse resultado. Uma tarde de trabalho costuma bastar para a primeira rodada.
- Separe de 20 a 50 tarefas reais que o Sonnet 5 já resolve em produção, com critério de aceite definido
- Rode as mesmas tarefas no Sonnet 5.5 em esforço Medium, declarado na chamada
- Compare custo por tarefa concluída, latência e taxa de acerto, e só então teste High
- Leia o guia de migração e ajuste o
between_tools, o uso forçado de ferramentas e a ferramenta de uso de computador - Registre nos logs qual modelo respondeu cada chamada antes de virar a chave
Se a qualidade empatar em Medium, a troca se paga na fatura. Se cair, o problema costuma estar em prompts escritos para o comportamento do modelo antigo.
A AlphaCorp AI monta esse tipo de avaliação comparativa e acompanha a migração até a produção, e você pode começar por uma consultoria de IA voltada à escolha de modelo.