On this page(17)
- O que é MLOps e qual problema ele resolve
- Como funciona MLOps na prática: do treino do modelo ao monitoramento em produção
- Para que serve MLOps em uma empresa que já tem modelos de machine learning?
- Qual a diferença entre MLOps, DevOps e DataOps
- Níveis de maturidade em MLOps: do notebook manual ao pipeline totalmente automatizado
- Ferramentas de MLOps mais usadas e como escolher a stack
- Quanto custa implementar MLOps e quando o investimento se paga
- Quando MLOps falha: erros comuns de quem adota a prática cedo demais
- O que mudou em MLOps com LLMs e IA generativa
- Perguntas frequentes sobre o que é MLOps
- MLOps é um cargo ou uma prática?
- Preciso de MLOps se tenho um único modelo em produção?
- Qual a diferença entre MLOps e engenharia de dados?
- MLOps serve para quem não programa?
- Quanto ganha um engenheiro de MLOps no Brasil?
- MLOps é obrigatório pela LGPD?
- Por onde começar a implementar MLOps no seu time
MLOps é o conjunto de práticas de engenharia que leva um modelo de machine learning do experimento à produção e o mantém funcionando, com versionamento, automação e monitoramento. O nome junta ML e DevOps, e o que separa os dois é um fato incômodo: o modelo degrada sem ninguém mexer no código. Neste guia você encontra o ciclo de vida completo, como MLOps se compara a DevOps e DataOps, os modelos de maturidade, o custo, os erros comuns e o que mudou com LLMs. Em 11 de novembro de 2026, o Brasil não tem indicador oficial de adoção de MLOps, só de uso de IA.
- 17% das empresas brasileiras usaram IA em 2025, contra 13% em 2024, segundo a pesquisa TIC Empresas 2025 do Cetic.br, que ouviu 4.174 empresas
- Entre as grandes empresas, a adoção de IA subiu de 38% para 50% de 2024 para 2025, na mesma pesquisa do Cetic.br
- 80% das empresas que usam IA compraram software pronto em 2025, e 60% contrataram fornecedor externo, de acordo com a TIC Empresas 2025
- Os dois modelos de maturidade mais citados discordam no número de degraus: o Google Cloud descreve três níveis, a Microsoft descreve cinco
- Um estudo de 2025 no Journal of Innovation & Knowledge, com 12 profissionais entrevistados, agrupou os obstáculos à adoção de MLOps em quatro categorias e onze temas
O que é MLOps e qual problema ele resolve
MLOps é o conjunto de práticas de engenharia que unifica o desenvolvimento (Dev) e a operação (Ops) de sistemas de machine learning, para que um modelo saia do experimento e continue funcionando em produção. O nome junta “ML” e “DevOps”, e a intenção é a mesma que o DevOps teve para software comum: integrar, entregar e operar de forma contínua, com automação no lugar de tarefa manual. A definição mais citada vem do guia de arquitetura de MLOps do Google Cloud, que chama a disciplina de “an ML engineering culture and practice that aims at unifying ML system development (Dev) and ML system operation (Ops)”.
Repare na palavra cultura. MLOps é menos uma ferramenta que você instala e mais um acordo sobre como dados, código e modelos atravessam o caminho até o usuário final. Definições acadêmicas acrescentam a essa base os papéis envolvidos, os componentes técnicos e a arquitetura, mas o núcleo continua esse.
O problema que motiva tudo isso ficou nomeado em 2015. O artigo do Google sobre dívida técnica oculta em sistemas de machine learning, apresentado na NeurIPS daquele ano, mostrou que esses sistemas geram custos de manutenção contínuos e muito maiores que o código sugere. Os fatores de risco listados ali continuam atuais:
- Erosão de fronteiras entre componentes que deveriam ser independentes
- Emaranhamento (entanglement): mudar uma entrada muda o comportamento de todas as outras
- Laços de feedback ocultos, em que o modelo influencia os próprios dados futuros
- Consumidores não declarados, que usam a predição sem ninguém saber
- Dependências de dados mais frágeis que dependências de código
- Problemas de configuração espalhados pelo sistema
- Mudanças no mundo externo que invalidam o que o modelo aprendeu
- Antipadrões de sistema, como código de cola e pipelines improvisados
Esse é um fundamento de 2015, e o mundo mudou desde então. Só que o diagnóstico nunca foi contestado.
O mesmo guia do Google reconhece que um sistema de ML é um sistema de software, então práticas parecidas se aplicam. Mas aponta cinco diferenças que fazem o DevOps puro não bastar. A equipe inclui cientistas de dados que nem sempre são engenheiros de software capazes de construir serviços de nível de produção. O desenvolvimento é experimental por natureza, com dezenas de tentativas até uma versão prestar. Testar é mais complexo, porque além do código você valida dados e qualidade do modelo. A implantação vai além de empacotar um modelo treinado offline como serviço de predição. E, em produção, os modelos “can decay in more ways than conventional software systems”: degradam de mais maneiras do que um serviço comum.
A última diferença é a que mais dói na prática. Um serviço web quebra quando alguém muda o código. Um modelo quebra sem ninguém encostar nele, porque o mundo que gerou os dados de treino parou de existir.
Como funciona MLOps na prática: do treino do modelo ao monitoramento em produção
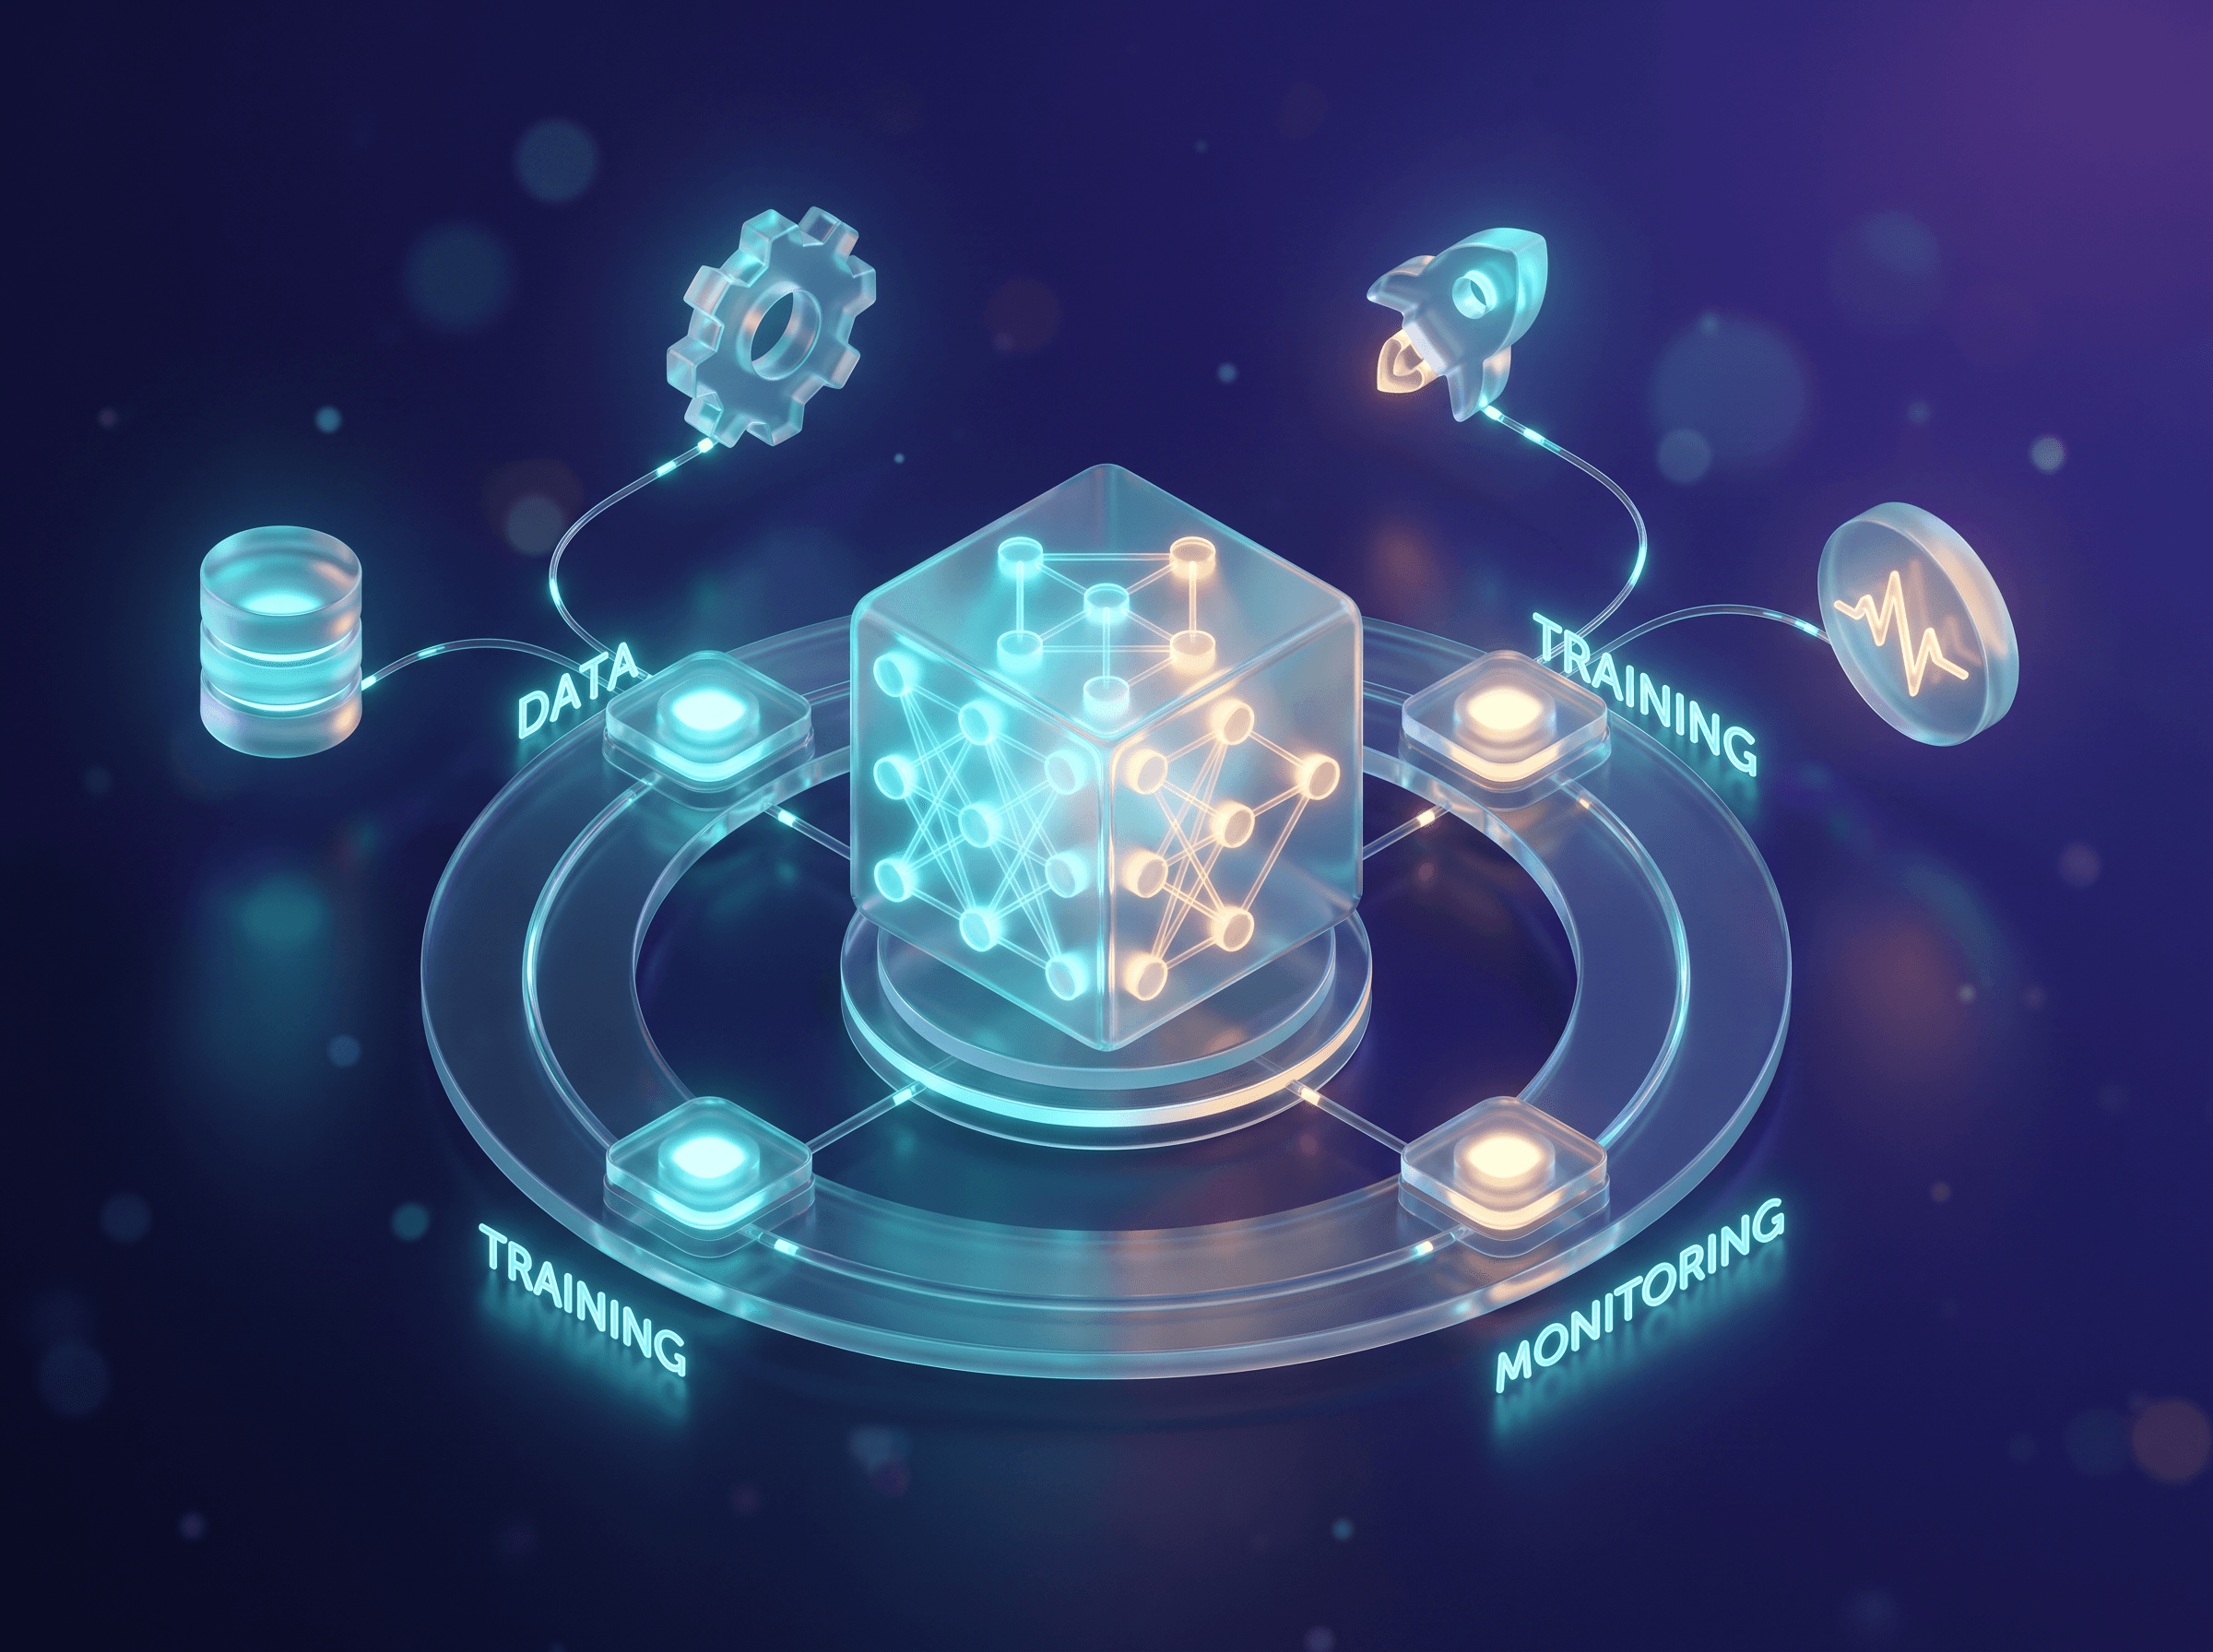
Na prática, MLOps funciona como um pipeline automatizado que leva dados brutos até um modelo servido e monitorado, e que dispara um novo treinamento quando o desempenho cai. A sequência é sempre parecida, independentemente da ferramenta:
- Preparação e versionamento dos dados. Cada versão do dataset recebe identificador próprio, para você saber com quais dados exatos um modelo foi treinado.
- Rastreamento de experimentos. Parâmetros, métricas e artefatos de cada tentativa ficam registrados, em vez de perdidos em notebooks.
- Treinamento. Roda como etapa reproduzível do pipeline, com código e dados versionados como entrada.
- Validação do modelo. Antes de seguir, o modelo passa por testes de qualidade e por comparação com a versão que está em produção.
- Registro no model registry. O modelo aprovado entra num catálogo com versão, metadados e linhagem até os dados originais.
- Implantação. O modelo vira serviço de predição (ou job em lote) promovido entre ambientes de forma automatizada.
- Monitoramento de desempenho e drift. Métricas de negócio, latência e distribuição das entradas são acompanhadas depois do deploy.
- Treinamento contínuo (CT). Quando o monitoramento detecta degradação ou chegam dados novos, o pipeline treina o modelo de novo e volta ao passo 1.

O passo 8 é o que separa essa arquitetura de um pipeline de CI/CD comum. O Google define o treinamento contínuo como “a new property, unique to ML systems”, voltada a treinar e servir modelos de novo sem intervenção humana. Em software tradicional, o gatilho do pipeline é um commit. Em ML, o gatilho pode ser um commit, um lote novo de dados, uma queda de métrica ou simplesmente o calendário.
O que ninguém descobre até tentar é que a parte mais trabalhosa raramente é o treino. É o passo 6. O modelo que validou bonito no notebook depende de features calculadas de um jeito, e o serviço de predição, escrito por outra pessoa em outra linguagem, calcula de outro. O modelo não dá erro. Só responde errado, em silêncio, até alguém do negócio reclamar.
Por isso o monitoramento em MLOps vai além de CPU e latência. Ele acompanha a distribuição dos dados de entrada (os clientes de hoje se parecem com os de quando o modelo foi treinado?) e a qualidade das predições, quando a resposta certa chega com atraso. Esse fenômeno de mudança nas relações entre entrada e saída chama-se concept drift, e a pesquisa sobre o tema o organiza em três tarefas: detectar que houve drift, localizar em quais regiões dos dados ele aconteceu e explicar por quê.
Cada bloco desse fluxo pode começar manual. O que define MLOps é a direção: cada passo que você automatiza tira uma pessoa do caminho crítico entre o experimento e o usuário.
Para que serve MLOps em uma empresa que já tem modelos de machine learning?
MLOps serve para que uma empresa com modelos em produção consiga reproduzir qualquer versão, encurtar o caminho entre experimento e deploy, perceber quando um modelo degrada e provar, com registros, como cada decisão automatizada foi tomada. Quem ainda está no primeiro protótipo sente pouco disso. Quem já tem três modelos atendendo clientes sente todos os dias.
Os ganhos concretos se dividem em quatro frentes:
- Reprodutibilidade: dados, código e parâmetros versionados juntos permitem reconstruir o modelo de seis meses atrás e entender por que ele decidiu o que decidiu.
- Tempo até produção: com pipeline automatizado, a versão nova sai do experimento para o serviço sem passar por uma fila de tarefas manuais de infraestrutura.
- Detecção de degradação: monitoramento de drift e de métricas de negócio avisa antes que a queda de qualidade vire reclamação de cliente ou prejuízo.
- Rastreabilidade para auditoria: o model registry liga cada predição a uma versão específica de modelo e de dados, o que transforma uma pergunta do jurídico em uma consulta, em vez de uma investigação.
A última frente é a que mais cresce em peso. O Art. 20 da Lei 13.709/2018 (LGPD) dá ao titular o direito de solicitar revisão de decisões tomadas unicamente com base em tratamento automatizado de dados pessoais. O AI Risk Management Framework 1.0 do NIST, de janeiro de 2023 e de adoção voluntária, coloca a função GOVERN em todos os estágios do ciclo de vida, com MAP, MEASURE e MANAGE aplicadas a sistemas específicos. E o Art. 12 do AI Act europeu exige que sistemas de IA de alto risco registrem eventos automaticamente ao longo da vida, em parte para sustentar o monitoramento pós-comercialização do Art. 72.
A ligação entre esses textos e MLOps é uma leitura minha: nenhum deles cita a disciplina pelo nome. Mas todos pedem exatamente o que o pipeline produz, que são versões rastreáveis, logs e monitoramento contínuo. Sem isso, atender a um pedido de revisão da LGPD vira arqueologia.
No Brasil, essa necessidade está concentrada num grupo pequeno de empresas. Os números mais recentes sobre uso de IA nas empresas brasileiras são da pesquisa TIC Empresas 2025 do Cetic.br, divulgada em 2026:
- 17% das empresas brasileiras usaram IA em 2025, contra 13% em 2024, o que representa cerca de 93.475 empresas
- Entre as grandes, a adoção subiu de 38% para 50% no mesmo período
- Entre as pequenas, foi de 10% para 15%
- 80% das que usam IA compraram software pronto, e 60% contrataram fornecedor externo para desenvolver ou adaptar
- O desenvolvimento interno só cresceu entre as grandes
A coleta ouviu 4.174 empresas entre fevereiro de 2025 e janeiro de 2026. Não existe indicador oficial de adoção de MLOps no Brasil, e nenhum desses números mede isso.
Na minha interpretação, o recorte diz muito. Quem compra software pronto terceiriza o ciclo de vida do modelo para o fornecedor. Quem treina modelo próprio, hoje sobretudo as grandes, é quem carrega o problema de versionar, monitorar e explicar. Montar essa infraestrutura de MLOps e DevOps é trabalho de engenharia de plataforma, e costuma caber a quem já cuida do CI/CD da empresa, com o time de dados como cliente interno.
Curious what AI could do for your business?
No jargon and no hard sell. Just a friendly look at where AI fits, and where it doesn't.
Qual a diferença entre MLOps, DevOps e DataOps
A diferença entre MLOps, DevOps e DataOps está no objeto que cada prática gerencia: DevOps cuida de código que vira serviço, DataOps cuida de dados que viram tabelas confiáveis, e MLOps cuida de um modelo que depende dos dois e ainda degrada sozinho. As três compartilham automação, versionamento e entrega contínua. O que muda é o que entra no pipeline, o que dispara uma nova execução e como a coisa quebra.
| Critério | DevOps | DataOps | MLOps |
|---|---|---|---|
| Objeto gerenciado | Código de aplicação | Pipelines de dados e tabelas | Modelo treinado, mais o código e os dados que o geraram |
| Artefatos versionados | Código, configuração, imagem de container | Esquemas, transformações, versões de dataset | Código, dataset, parâmetros, modelo e métricas |
| Gatilho do pipeline | Commit ou merge | Chegada de dado novo ou agenda | Commit, dado novo, queda de métrica ou calendário |
| Testes | Unitários, integração, carga | Qualidade e frescor dos dados, contrato de esquema | Tudo isso, mais validação dos dados de treino e da qualidade do modelo |
| Modo de falha típico | Erro visível, deploy quebrado | Tabela atrasada ou com valor errado | Predição errada em silêncio, sem erro nenhum |
A linha dos gatilhos é a que carrega a diferença de fundo. Em DevOps, o pipeline roda porque alguém mudou o código. Em MLOps, ele precisa rodar quando ninguém mudou nada, porque os dados do mundo real se afastaram dos dados de treino. O Google chama essa propriedade de treinamento contínuo (CT) e a descreve como exclusiva de sistemas de ML. Nenhuma das outras duas disciplinas tem equivalente, porque uma tabela e um serviço web não aprendem.
DataOps é a mais mal definida das três. Cada fornecedor estica o termo para cobrir o que vende, de orquestração a catálogo de dados, então trate a coluna do meio como descrição de propósito e menos como padrão fechado. Na prática, o pipeline de MLOps consome o que o DataOps entrega: se a tabela de features chega atrasada ou com valores trocados, o modelo treina errado e passa na validação mesmo assim, porque os dados de teste vieram da mesma tabela.
A distinção é sobre o artefato. O organograma pode ser o mesmo, e num time pequeno costuma ser: a mesma pessoa de plataforma mantém o CI/CD da aplicação, o agendador dos jobs de dados e o pipeline de treino. O que ela precisa aceitar é que o terceiro tem um modo de falha que os outros dois não têm, e que monitorar só disponibilidade e latência deixa esse modo invisível.
Níveis de maturidade em MLOps: do notebook manual ao pipeline totalmente automatizado
Os níveis de maturidade em MLOps medem quanto do ciclo de vida do modelo roda sem intervenção humana, e os dois modelos mais citados discordam até no número de degraus: o Google descreve três, a Microsoft descreve cinco. Não existe padrão único. Vale saber os dois, porque fornecedores, consultorias e vagas de emprego citam um ou outro sem avisar.
No modelo do Google, o nível 0 é o processo manual, em que “Every step is manual”: o cientista de dados treina no notebook, entrega o arquivo do modelo e alguém da engenharia transforma aquilo em serviço. O nível 1 automatiza o pipeline de ML inteiro, da preparação dos dados à implantação, e o objetivo declarado é chegar ao treinamento contínuo. O nível 2 automatiza a integração e a entrega contínuas do próprio pipeline, para que uma mudança no código de treino seja testada e promovida como qualquer outro software.
O modelo de maturidade de MLOps da Microsoft corta mais fino e avalia três dimensões em cada degrau: pessoas e cultura, processos e estruturas, objetos e tecnologia.
| Degrau | Google (3 níveis) | Microsoft (5 níveis) |
|---|---|---|
| 0 | Processo manual | No MLOps: sem automação, sem rastreio |
| 1 | Automação do pipeline de ML, com CT | DevOps but no MLOps: CI/CD para a aplicação, modelo ainda manual |
| 2 | Automação do CI/CD do pipeline | Automated training: treino reproduzível e automatizado |
| 3 | Não existe | Automated model deployment: promoção entre ambientes por registry |
| 4 | Não existe | Full MLOps automated operations: treino, deploy e monitoramento fechados em ciclo |
A correspondência entre as colunas é aproximada. O nível 1 do Google já inclui treinamento contínuo, enquanto a Microsoft separa treino automatizado (nível 2) de deploy automatizado (nível 3) e só fecha o ciclo no nível 4.
O degrau mais revelador é o nível 1 da Microsoft. Ele nomeia uma situação que o modelo do Google não enxerga: a empresa tem pipeline de CI/CD maduro para a aplicação, testes automatizados e deploy várias vezes por dia, mas o modelo que a aplicação consome foi copiado para o servidor por alguém, em algum momento, a partir de um notebook que ninguém mais acha. A infraestrutura de software é de nível 2 do Google. A de ML é zero.
A página da Microsoft diz com todas as letras que uma organização pode exibir características de mais de um nível ao mesmo tempo, e que a progressão é um contínuo. Isso bate com o que acontece em qualquer empresa com mais de um time de dados: a área de crédito tem registry e monitoramento, a de marketing roda tudo em planilha, e as duas respondem ao mesmo CTO. Perguntar “em que nível a empresa está” rende uma resposta errada. Pergunte por modelo.
Ferramentas de MLOps mais usadas e como escolher a stack
As ferramentas de MLOps se organizam por função dentro do ciclo de vida e por tipo de oferta, e a escolha certa depende menos do nome do produto e mais do nível de maturidade em que seu time está e de quantas pessoas vão operar a stack. Seis funções cobrem o que um pipeline completo precisa:
- Rastreamento de experimentos: guarda parâmetros, métricas e artefatos de cada tentativa de treino, para que a comparação entre versões não dependa da memória de quem treinou
- Versionamento de dados: dá identificador a cada versão do dataset e liga essa versão ao modelo que saiu dela
- Orquestração de pipelines: encadeia preparação, treino, validação e deploy como etapas reproduzíveis, com gatilho por commit, por dado novo ou por agenda
- Model registry: cataloga modelos aprovados com versão, metadados e linhagem, e controla a promoção entre desenvolvimento, homologação e produção
- Serving: expõe o modelo como serviço de predição online ou job em lote
- Monitoramento: acompanha métricas de negócio, latência e distribuição das entradas, e dispara alerta ou novo treino quando algo foge do esperado
Essas funções chegam em dois formatos. A plataforma gerenciada de um provedor de nuvem entrega as seis integradas, com um único login e uma única fatura, e o preço disso é acoplamento: migrar depois exige reescrever a cola entre as etapas. Os componentes open source permitem montar função por função e trocar uma peça sem mexer nas outras, e o preço é que a integração vira responsabilidade sua. Nenhum dos dois caminhos é errado. O erro é escolher sem olhar o tamanho do time que vai manter aquilo às três da manhã.
Um detalhe que só aparece depois do contrato assinado: o nome do produto do provedor muda, e a documentação muda junto. A documentação do Google para IA generativa hoje cita a Gemini Enterprise Agent Platform onde anúncios anteriores falavam de Vertex AI. O conceito por trás continuou o mesmo, mas quem tinha script, treinamento interno e orçamento amarrados ao nome antigo passou semanas atualizando.
Três critérios resolvem a maior parte das decisões:
- Nível de maturidade atual. Time no nível manual ganha mais com rastreamento de experimentos e registry do que com orquestrador sofisticado, porque ainda não tem pipeline para orquestrar. Orquestração e CI/CD do pipeline fazem sentido quando o treino já é reproduzível.
- Tamanho e perfil do time. Com dois cientistas de dados e nenhuma pessoa de plataforma, a stack gerenciada compensa o acoplamento. Com time de plataforma próprio e vários modelos de áreas diferentes, componentes separados dão mais controle.
- Quantas ferramentas você consegue operar de verdade. Cada componente adicional é mais uma versão para atualizar, mais um ponto de autenticação e mais uma integração que quebra quando a API de um dos lados muda. Seis ferramentas para um modelo é coleção, e coleção gera manutenção sem gerar predição.
Há quem construa a própria plataforma. Uma dissertação da USP de 2022 propôs a Flowi, uma plataforma para gerenciar o ciclo de vida de modelos com rastreio de experimentos, implantação e monitoramento. Funciona como prova de que as seis funções são o requisito, e a ferramenta é detalhe de implementação. Se o seu time não sabe em qual degrau está antes de escolher, uma avaliação de prontidão para IA feita antes da compra sai mais barata do que a migração feita depois dela.
Quanto custa implementar MLOps e quando o investimento se paga
Implementar MLOps custa, acima de tudo, horas de gente qualificada, e o investimento se paga quando o número de modelos em produção, a frequência de novo treino ou o prejuízo de um incidente por degradação passam a custar mais do que manter o processo manual. Não existe valor público de referência em reais. Qualquer cifra fechada que chegar numa proposta comercial foi calculada para um contexto que dificilmente é o seu.
A conta tem quatro componentes:
- Pessoas e papéis: alguém precisa manter o pipeline, o registry e os alertas. Pode ser o engenheiro de plataforma que já cuida do CI/CD, pode ser uma vaga nova. É o item mais caro e o mais fácil de subestimar, porque entra como salário recorrente e nunca como projeto com começo e fim.
- Infraestrutura de nuvem: treino que dispara sozinho significa jobs rodando sem ninguém pedir, armazenamento para cada versão de dataset e de modelo, e um serviço de predição no ar o tempo todo. A fatura cresce junto com a frequência de novo treino.
- Licenças: plataforma gerenciada cobra por uso, componente open source cobra em horas de integração. O custo existe nos dois casos, só muda de rubrica.
- Tempo de migração: mover modelos que já rodam para o pipeline novo trava parte do time por semanas, e nesse período ninguém entrega modelo novo.
Os sinais de que o retorno chegou são três, e você consegue medir cada um sem consultoria. Quantos modelos estão em produção? Com um, o processo manual incomoda pouco. Com cinco, cada etapa manual se multiplica por cinco e as versões começam a se misturar. Com que frequência o modelo precisa ser treinado de novo? Modelo de fraude ou de precificação, cujos dados mudam toda semana, não sobrevive a um fluxo em que alguém copia o arquivo para o servidor. E quanto custou o último incidente de degradação? Um modelo de crédito que respondeu errado por dois meses tem um valor em reais, mesmo que ninguém tenha somado ainda.
O que costuma convencer o financeiro é esse último número, com data e valor, e raramente uma planilha de economia projetada.
Por porte, o quadro muda de forma previsível. Time pequeno com um ou dois modelos ganha mais ao versionar dados e registrar experimentos, que custam quase nada, e pode adiar o resto sem culpa. Empresa média com modelos espalhados por áreas diferentes paga a falta de registry em modelos duplicados e em ninguém saber qual versão está no ar. Grande empresa com desenvolvimento interno já está pagando a conta inteira, só que diluída em incidentes, horas de investigação e pedidos do jurídico que viram arqueologia de notebook.
Quando MLOps falha: erros comuns de quem adota a prática cedo demais
MLOps falha quando a empresa automatiza o ciclo de vida antes de ter um modelo que valha a pena operar, empilha ferramentas sem dono definido e monitora só o que é fácil de medir. Os três erros têm a mesma raiz: tratar a disciplina como compra de tecnologia, quando o gargalo está em papéis e processo.
A literatura de adoção confirma o diagnóstico. Um estudo de 2025 no Journal of Innovation & Knowledge sobre os obstáculos à adoção de MLOps combinou revisão de literatura com entrevistas semiestruturadas com 12 profissionais e agrupou os problemas em quatro categorias (organizacionais, técnicas, operacionais e de negócio) e onze temas. Parte deles, como a complexidade de dados e modelos, é específica do MLOps. Outra parte a empresa já conhece do DevOps. Doze entrevistas é amostra pequena, então leia o estudo como mapa dos problemas, e menos como medida de quão frequente cada um é. Um preprint de fevereiro de 2025 no arXiv, com survey de 150 profissionais e 20 entrevistas, chega a um quadro parecido, mas ainda sem revisão por pares.
Na prática, os erros aparecem nesta ordem:
- Automatizar antes de ter modelo de valor. Pipeline com treino automático em volta de um modelo que ninguém consulta é custo fixo sem retorno. Primeiro prove que a predição muda uma decisão de alguém. Depois automatize.
- Excesso de ferramentas. Cada componente escolhido por uma pessoa vira órfão quando ela sai, e a empresa passa a manter integrações que ninguém entende.
- Falta de papéis definidos. O cientista de dados acha que a plataforma é da engenharia. A engenharia acha que o modelo é do cientista. O modelo em produção fica sem dono, e o primeiro incidente vira discussão sobre quem deveria ter visto.
- Monitorar só métrica técnica. Uma revisão multivocal de 2025 sobre monitoramento de sistemas de ML concluiu que desempenho e drift recebem muito mais atenção e têm soluções mais maduras do que os aspectos de ML responsável. O dashboard fica verde enquanto o modelo trata mal um grupo de clientes.
- Deixar ML responsável para quando o regulador perguntar. Viés, explicabilidade e revisão de decisão automatizada são requisitos do pipeline desde o primeiro deploy, porque reconstruir isso depois exige dados que já não existem.
Pipeline automatizado em volta de um modelo ruim só entrega o modelo ruim mais rápido.
O erro 4 é o que mais me incomoda, porque é o mais barato de evitar. Quem já instrumentou latência e distribuição de entrada tem toda a infraestrutura para acompanhar também a taxa de aprovação por faixa etária ou por região. Falta decidir que isso é métrica de produção. Ninguém decide, e o problema só aparece quando chega um pedido de revisão amparado na LGPD.
O que mudou em MLOps com LLMs e IA generativa
Com LLMs e IA generativa, MLOps ganhou uma extensão chamada LLMOps, que mantém o ciclo de versionar, implantar e monitorar, mas troca o artefato central: em vez de um modelo treinado pela própria empresa, o que se opera é um modelo de terceiros cercado de prompts, bases de retrieval e filtros. Uma comparação entre MLOps e LLMOps publicada na revista Information em 2025 descreve o LLMOps como um guarda-chuva que abrange GenAIOps (treino e implantação de modelos generativos) e RAGOps (gestão da informação que complementa a geração). LLMOps estende MLOps em vez de substituí-lo.

Quatro coisas mudam de verdade no dia a dia de quem opera:
- Ativos novos para versionar. O prompt se comporta como código, mas muda sem commit. A base de retrieval-augmented generation (RAG) se comporta como dado, mas altera a resposta sem nenhum treino. Os guardrails são regras que ninguém testa até alguém burlar. Os três precisam entrar no registry com a mesma seriedade que um modelo.
- Avaliação sem gabarito. Um modelo preditivo tem resposta certa que chega depois: o cliente pagou ou não pagou. Texto gerado não tem. Avaliar vira amostragem, rubrica e, com frequência, julgamento por outro modelo, com todos os vieses que isso traz.
- Custo que acompanha o uso. Em ML preditivo, o treino custa caro e a predição custa quase nada. Com LLMs de terceiros, cada chamada consome tokens cobrados pelo fornecedor, então a fatura segue o volume de requisições e o tamanho dos prompts.
- Monitoramento de comportamento, e não só de métrica. O relatório NIST AI 800-4, de março de 2026, sobre os desafios de monitorar sistemas de IA já implantados, propõe seis categorias de monitoramento e organiza os problemas em lacunas, barreiras e questões em aberto. Que um órgão de padrões publique isso em 2026 diz quanto o tema ainda está sem resposta fechada.
O próprio guia de arquitetura do Google avisa que suas recomendações de MLOps se aplicam sobretudo a IA preditiva, e mantém um blueprint separado para operar IA generativa e ML corporativos juntos. Um TCC da UFC de 2026 sobre LLMOps sustenta a mesma tese, a de que as práticas tradicionais não bastam para modelos generativos de grande porte. É trabalho de graduação, então vale como indício.
Na minha leitura, a distância entre as duas disciplinas é menor do que o nome novo sugere. Quem já tem registry, pipeline e monitoramento de drift resolve LLMOps acrescentando artefatos ao que existe. Quem não tem nada vai descobrir que um sistema de RAG em produção degrada tanto quanto um modelo de crédito, e pelos mesmos motivos: a base mudou, o mundo mudou, e ninguém estava olhando.
Perguntas frequentes sobre o que é MLOps
As dúvidas mais buscadas sobre o que é MLOps giram em torno de cargo, tamanho mínimo de operação, fronteira com engenharia de dados, salário e obrigação legal. As respostas curtas estão abaixo, cada uma de pé por conta própria.
MLOps é um cargo ou uma prática?
É uma prática, e o cargo veio depois. O Google define MLOps como cultura e prática de engenharia; “engenheiro de MLOps” é o nome que o mercado deu a quem mantém o pipeline, o registry e o monitoramento. Em times pequenos, essa função costuma ficar com o engenheiro de plataforma que já cuida do CI/CD. Contratar o cargo sem adotar a prática produz uma pessoa sozinha cuidando de um processo que o resto do time ignora.
Preciso de MLOps se tenho um único modelo em produção?
Precisa de uma parte dele. Com um modelo, versionar dados e registrar experimentos já evita o cenário em que ninguém sabe com quais dados a versão no ar foi treinada, e isso custa quase nada. Pipeline com treinamento contínuo e CI/CD só compensa quando o número de modelos ou a frequência de novo treino aumenta.
Qual a diferença entre MLOps e engenharia de dados?
Engenharia de dados entrega tabelas confiáveis e atualizadas. MLOps entrega um modelo treinado a partir dessas tabelas, implantado e monitorado. O engenheiro de dados responde pela qualidade e pelo frescor do dado; quem faz MLOps responde pelo que acontece depois, que é treino reproduzível, versão do modelo no ar e alerta quando a predição degrada. Na prática, o pipeline de MLOps é cliente do que a engenharia de dados produz.
MLOps serve para quem não programa?
Serve para entender e cobrar, mas a implementação exige código. Gestor de produto, jurídico e área de risco consomem o que o MLOps gera: qual versão do modelo tomou determinada decisão, com quais dados, e se o desempenho caiu desde então. Montar o pipeline é trabalho de engenharia, e plataforma gerenciada com interface visual reduz o esforço sem dispensar alguém que escreva e mantenha o código.
Quanto ganha um engenheiro de MLOps no Brasil?
Não existe levantamento público consolidado com salário específico de engenheiro de MLOps no Brasil. O que dá para dizer é o que puxa o valor: a função junta engenharia de software, infraestrutura de nuvem e noção de modelagem, um perfil raro, e a demanda está concentrada nas empresas que desenvolvem modelos próprios, hoje sobretudo as grandes. Desconfie de qualquer número fechado que apareça sem fonte, método e data de coleta.
MLOps é obrigatório pela LGPD?
Não. A Lei 13.709/2018 não cita MLOps nem nenhuma técnica de engenharia. O que o Art. 20 da LGPD garante é o direito do titular de solicitar revisão de decisões tomadas unicamente com base em tratamento automatizado de dados pessoais. Para atender a esse pedido você precisa saber qual versão do modelo decidiu, com quais dados e segundo quais critérios, e é exatamente isso que versionamento, registry e logs produzem. A lei cobra o resultado. MLOps é o caminho mais barato até ele.
What could a custom AI agent take off your plate?
We build production-grade AI systems that quietly handle the busywork, so your team can focus on the work that actually matters.
Por onde começar a implementar MLOps no seu time
Comece a implementar MLOps pelo degrau logo acima do que seu time ocupa hoje, em vez de pelo pipeline completo. Cada ponto de partida tem um primeiro passo próprio:
- Tudo manual: versione dados e código juntos e registre cada experimento, com parâmetros e métricas. Dá para começar nesta semana.
- Treino reproduzível, mas no notebook: automatize um único pipeline, do dado ao modelo validado, para um modelo só.
- Pipeline rodando: instrumente monitoramento da distribuição de entrada e de uma métrica de negócio, com alerta que chega em alguém.
- Monitoramento no ar: feche o ciclo com novo treino disparado por queda de métrica, e deixe o deploy passar pelo registry.
Depois, um teste para esta semana. Escolha o modelo que mais custa quando erra e responda, por escrito, com quais dados e qual código a versão em produção foi treinada. Se a resposta levar mais de uma hora, o passo 1 é o seu, independentemente do que o resto da infraestrutura já faz.
Se preferir montar esse primeiro pipeline com quem já tirou modelo do notebook e o manteve em produção, fale com o time da AlphaCorp AI sobre o modelo que você quer colocar sob controle.