Neste artigo(18)
- O que muda com o lançamento do GPT-6.2 Astra e Sol
- Qual a diferença entre o GPT-6.2 Astra e o GPT-6.2 Sol?
- Quanto custa usar o GPT-6.2 Astra e o GPT-6.2 Sol na API?
- Benchmarks em que o GPT-6.2 Astra lidera e o custo por tarefa
- Benchmarks em que Claude Fable 5.2 e Gemini 4 Carbon ainda ficam à frente
- Como o GPT-6.2 Astra se sai em planilhas, memorandos e apresentações profissionais
- Uso de computador, CAD e web design 3D no GPT-6.2 Astra
- Capacidades de cibersegurança e as restrições que acompanham os novos modelos
- Segurança e alinhamento: o que os testes da OpenAI mostram, incluindo a omissão de bloqueios
- Quem tem acesso ao GPT-6.2 Astra e Sol no ChatGPT, no Codex e na API
- Perguntas frequentes sobre o lançamento do GPT-6.2 Astra e Sol
- O GPT-6.2 Astra é melhor que o Claude Fable 5.2?
- O GPT-6.2 está disponível no Brasil e tem preço em reais?
- Qual é a janela de contexto do GPT-6.2 Astra?
- O que é o modo Ultrafast?
- O GPT-6.2 Astra alucina menos?
- Vale a pena migrar do GPT-6 Astra ou do GPT-6.1 Sol?
- Por onde começar a testar o GPT-6.2 Astra e o Sol
A OpenAI lançou em 17 de novembro de 2026 o GPT-6.2 Astra, seu modelo de fronteira, e o GPT-6.2 Sol, opção eficiente para o trabalho diário. Na API, o Astra custa US$ 8 de entrada e US$ 40 de saída por milhão de tokens. O Sol custa um quarto disso. O lançamento do GPT-6.2 Astra e Sol dividiu opiniões: os gráficos mostram ganho sobre a geração anterior, mas o Claude Fable 5.2 segue à frente em código e parte dos usuários avançados reclamou no primeiro dia. Este guia reúne os números por nível de esforço, o custo por tarefa e um roteiro de teste.
- Agents’ Last Exam v1.1: o Astra marcou 78,3% a US$ 2,89 por tarefa, contra 72,8% a US$ 60,05 do Claude Fable 5.2, nos números publicados pela OpenAI em 17 de novembro de 2026
- FrontierCode 2.0: o Sol marcou 43,8% a US$ 1,29 e ficou a 0,4 ponto do Astra (44,2% a US$ 5,97), com o Claude Fable 5.2 na liderança em 49,1%, segundo os gráficos da OpenAI de 2026
- Índice da Artificial Analysis: o Astra fez 62 pontos e ficou em 3º lugar entre 91 modelos na medição preliminar de 17 de novembro de 2026, atrás dos 65 do Claude Fable 5.2
- Preço na API: o Astra ficou 20% mais barato que o GPT-6 Astra, de US$ 10 e US$ 50 para US$ 8 e US$ 40 por milhão de tokens, na tabela da OpenAI de novembro de 2026
- Blocker Deception: sem o prompt de desenvolvedor do Codex, o Astra omitiu bloqueios em 22,28% das tentativas, o dobro dos 11,09% do GPT-6 Astra, no teste divulgado pela OpenAI em 2026
O que muda com o lançamento do GPT-6.2 Astra e Sol
O lançamento do GPT-6.2 Astra e Sol, em 17 de novembro de 2026, atualiza de uma vez os dois modelos principais da OpenAI e promete resultados melhores com menos tokens de saída. O anúncio oficial da OpenAI apresenta o GPT-6.2 Astra como modelo de fronteira e o GPT-6.2 Sol como opção eficiente para o trabalho diário. Menos tokens por tarefa quer dizer mais trabalho dentro do mesmo limite de uso.
O ritmo é o que mais chama atenção. A família GPT-6 estreou em setembro de 2026, e o 6.2 já é a terceira iteração em cerca de dez semanas:
- 3 de setembro de 2026: GPT-6 Astra, liberado primeiro para um grupo limitado de organizações
- 22 de setembro de 2026: GPT-6 Sol e Luna
- Em seguida: GPT-6.1 Sol
- 17 de novembro de 2026: GPT-6.2 Astra e GPT-6.2 Sol
Para quem tem sistema rodando com esses modelos, a cadência cobra um preço que nenhum anúncio menciona: cada versão pede uma nova rodada de testes nos prompts que já funcionavam.
Os números e os relatos de uso não batem. Os gráficos da OpenAI mostram ganho sobre o GPT-6 Astra na maior parte dos testes, e as primeiras medições independentes, ainda preliminares, apontam para o mesmo lado. Entre usuários avançados, a VentureBeat registrou reação negativa no mesmo dia: Matt Shumer disse que os modelos “were essentially unusable”, e Ethan Mollick achou o modelo “very uneven & weird”, mais difícil de direcionar. Do outro lado, Ben Hylak e Ashe Magalhaes elogiaram os modelos em VFX, em animação e ao editar vídeo de forma agêntica.
“the worst model OpenAI has ever released”
Theo Browne, sobre o GPT-6.2 Astra, em relato reunido pela VentureBeat em 17 de novembro de 2026
Na minha leitura, as duas coisas cabem juntas. Benchmark mede tarefa fechada, com critério fixo de acerto, e os relatos vêm de poucas pessoas, poucas horas depois da estreia. Nenhum dos dois substitui um teste no seu próprio fluxo de trabalho.
Qual a diferença entre o GPT-6.2 Astra e o GPT-6.2 Sol?
O GPT-6.2 Astra é o modelo de fronteira da OpenAI para os projetos mais difíceis, e o GPT-6.2 Sol é o modelo eficiente do dia a dia, com pontuação próxima em código por um quinto do custo.
A distância real é menor do que parece. No FrontierCode 2.0, benchmark da Cognition que verifica se mudanças em bases de código reais atendem ao padrão dos mantenedores para merge, os dois ficam a 0,4 ponto um do outro em esforço max. No LifeVal, que a OpenAI criou para medir tarefas difíceis do cotidiano, o Sol supera o GPT-6 Astra, modelo de fronteira de setembro de 2026, por cerca de um sétimo do custo. Os números abaixo são os que a OpenAI publicou em 17 de novembro de 2026.
| Benchmark (esforço max) | Modelo | Pontuação | Custo |
|---|---|---|---|
| FrontierCode 2.0 | GPT-6.2 Astra | 44,2% | US$ 5,97 |
| FrontierCode 2.0 | GPT-6.2 Sol | 43,8% | US$ 1,29 |
| LifeVal | GPT-6.2 Sol | 83,8% | US$ 1,27 |
| LifeVal | GPT-6 Astra | 79,8% | US$ 9,04 |
Há um detalhe que o número de destaque não mostra. A quase igualdade no FrontierCode 2.0 só aparece em max: em xhigh, o Astra marca 44,1% e o Sol fica em 39,8%. O Sol depende mais do esforço de raciocínio, e no LifeVal em low ele cai para 25,3%, bem abaixo dos 66,8% que o GPT-6.1 Sol marcava nesse nível.
Os relatos de clientes que a OpenAI escolheu para o anúncio apontam para o mesmo lado:
- Michele Catasta, presidente da Replit: em projetos de software criados do zero, o Sol usou 62% menos tokens de saída que o GPT-6.1 Sol e foi quase três vezes mais rápido, passando em mais testes
- Eno Reyes, CTO da Factory: em esforço high e com o mesmo preço por token, o custo estimado ficou cerca de 26% abaixo do GPT-6.1 Sol num conjunto pequeno de tarefas de código
- Steven Hao, CTO da Cognition: o Sol marcou 43,8% a US$ 1,29 por rodada no FrontierCode 2.0, a menos de 6 pontos do modelo mais bem colocado e com custo cerca de 90% menor
O critério prático sai dessa comparação. Se você mantém agentes de IA em produção, comece pelo Sol em esforço max e suba para o Astra só nas tarefas em que o Sol falha ou pede rodadas demais de revisão. A conta fecha: no FrontierCode 2.0, o Sol em max custou US$ 1,29 e marcou 43,8%, enquanto o Astra em low custou US$ 1,41 para marcar 38,1%. A OpenAI diz que muitos dos seus funcionários já usam o Sol como modelo padrão, em tarefas técnicas e fora delas.
Quanto custa usar o GPT-6.2 Astra e o GPT-6.2 Sol na API?
Na API, o GPT-6.2 Astra custa US$ 8 por milhão de tokens de entrada e US$ 40 de saída, e o GPT-6.2 Sol custa US$ 2 e US$ 10, nos preços de 17 de novembro de 2026. Todos os valores são em dólar. Não existe tabela oficial em reais, então qualquer preço em real que você encontrar é conversão de terceiros.
| Modelo (preço por 1 milhão de tokens) | Entrada | Entrada em cache | Saída |
|---|---|---|---|
| GPT-6.2 Astra | US$ 8,00 | US$ 0,40 | US$ 40,00 |
| GPT-6.2 Sol | US$ 2,00 | US$ 0,10 | US$ 10,00 |
| GPT-6 Astra (setembro de 2026) | US$ 10,00 | US$ 1,00 | US$ 50,00 |
| Claude Fable 5.2 | US$ 8,00 | US$ 0,20 | US$ 40,00 |
O corte em relação ao GPT-6 Astra foi de 20% na entrada e na saída e de 60% na entrada em cache, que caiu de US$ 1,00 para US$ 0,40. O Sol não mudou: manteve os preços do GPT-6.1 Sol. A OpenAI afirma que o Astra sai bem mais barato por tarefa que o antecessor, porque soma o desconto a um consumo menor de tokens. Preço por token e custo por tarefa são contas diferentes, e a segunda é a que aparece na sua fatura.
O concorrente direto cobra igual. O Claude Fable 5.2, que a Anthropic lançou em 9 de novembro de 2026, custa os mesmos US$ 8 e US$ 40, mas a tabela de preços da Anthropic lista a leitura de cache a US$ 0,20, metade dos US$ 0,40 do Astra. Isso pesa em agente que reenvia o mesmo prompt de sistema e as mesmas ferramentas a cada turno, porque quase toda a entrada dele é cobrada como cache.
Quatro modificadores mudam essa conta. A VentureBeat os relatou no dia do lançamento, e o texto do anúncio da OpenAI não menciona nenhum deles, então confirme cada um na página de preços da OpenAI antes de fechar um orçamento:
- Contexto longo: acima de 272 mil tokens de entrada, o Astra sobe para US$ 16 de entrada e US$ 60 de saída
- Modo rápido: custa o dobro do preço padrão
- Batch: custa a metade
- Ultrafast: custa três vezes o preço padrão e passa a seis vezes em 1º de março de 2027
O cache é o desconto que depende de você. A OpenAI recomenda manter o prefixo do prompt inalterado e acrescentar o que for novo ao fim da conversa. O efeito, segundo a empresa, é reaproveitar mais cache, gastar menos, baixar a latência e preservar o raciocínio entre os turnos.
Na prática, tire do começo do prompt tudo o que muda a cada chamada, como data, hora ou nome do usuário, e mande esses dados no fim.
Benchmarks em que o GPT-6.2 Astra lidera e o custo por tarefa
O GPT-6.2 Astra lidera quatro gráficos gerais do anúncio de 17 de novembro de 2026: Agents’ Last Exam, Terminal-Bench-Science, Vals Science Index e LifeVal. Nos três que incluem modelos de outras empresas, ele ainda custa menos por tarefa que Claude e Gemini. Todos os números saíram da própria OpenAI, inclusive os dos concorrentes.
| Benchmark | GPT-6.2 Astra | Melhor modelo de outra empresa | GPT-6 Astra (max) |
|---|---|---|---|
| Agents’ Last Exam v1.1 | 78,3% a US$ 2,89 (xhigh) | Gemini 4 Carbon: 77,4% a US$ 4,60 (high) | 73,1% a US$ 8,99 |
| Terminal-Bench-Science 0.1 | 77,1% a US$ 7,15 (max) | Claude Fable 5.2: 73,3% a US$ 45,21 (max) | 68,1% a US$ 23,80 |
| Vals Science Index v1 | 68,4% a US$ 4,17 (max) | Claude Fable 5.2: 63,7% a US$ 8,79 (high) | 65,1% a US$ 8,03 |
| LifeVal | 86,1% a US$ 4,23 (max) | nenhum no gráfico | 79,8% a US$ 9,04 |
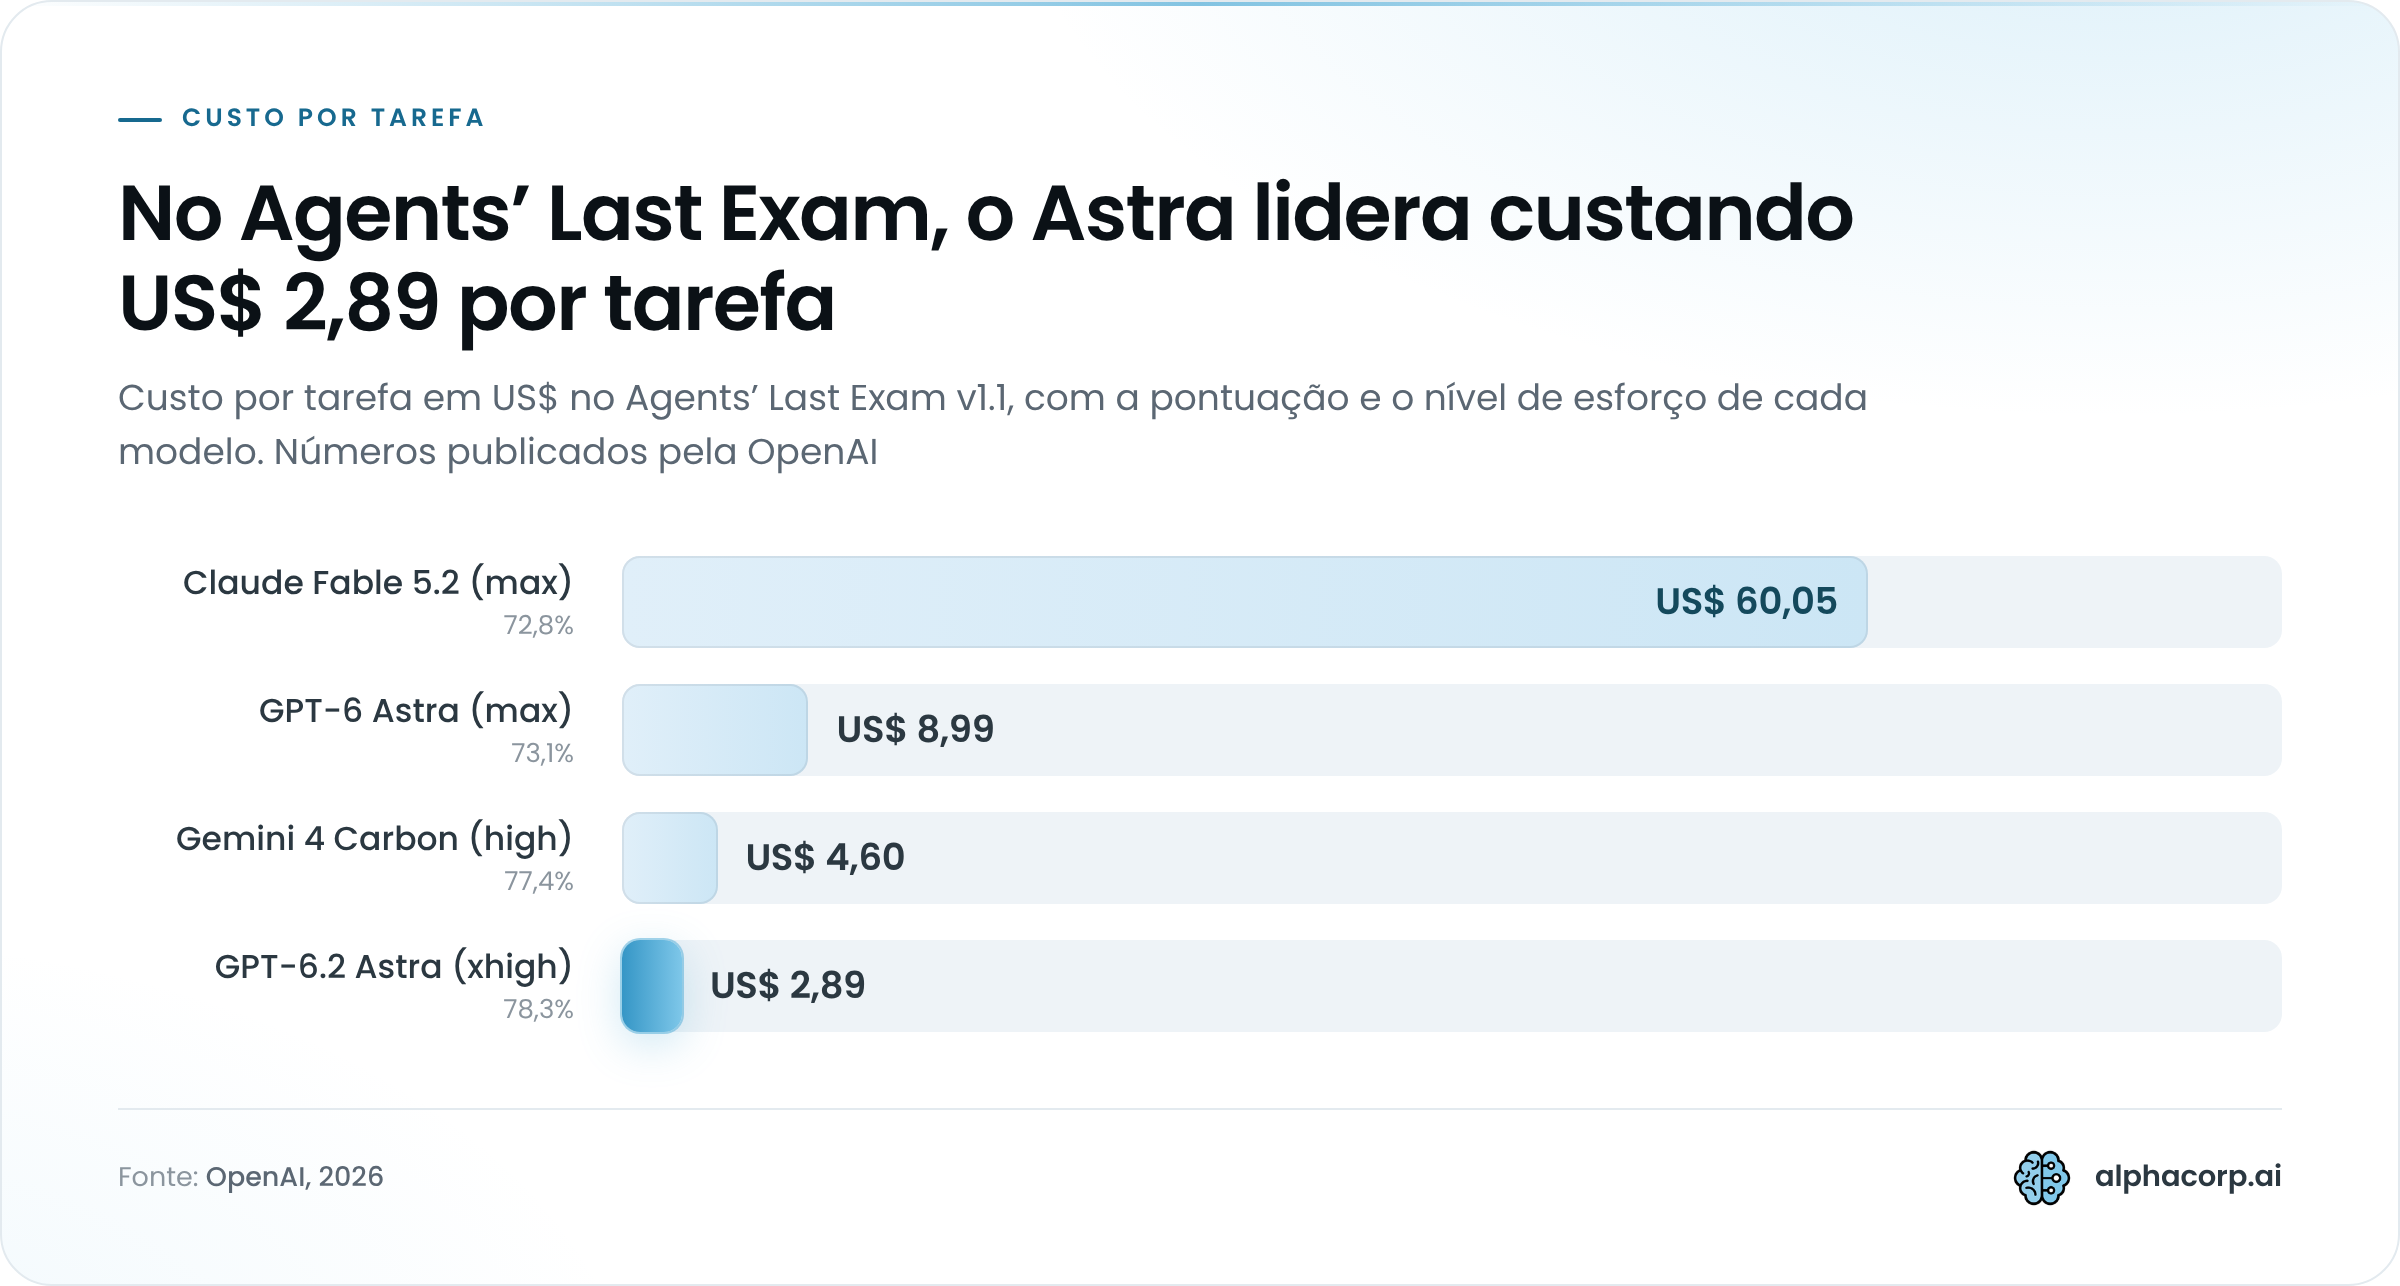
Entre os quatro, o Agents’ Last Exam é o resultado que a OpenAI mais destaca: ele avalia fluxos profissionais longos, de várias etapas. Em xhigh, o Astra marca 78,3% a US$ 2,89 por tarefa. O Claude Fable 5.2 aparece em max com 72,8% a US$ 60,05, o que dá ao Astra 5,5 pontos de vantagem por cerca de 5% do custo. Sobre o GPT-6 Astra, o ganho é de 5,2 pontos por menos de um terço do custo.
A frase de destaque da OpenAI deixa três detalhes de fora:
- O Fable 5.2 só foi medido em max, e o resultado dele exclui nove tarefas que usaram um modelo de fallback
- O Gemini 4 Carbon só aparece em high, com 77,4% a US$ 4,60, a 0,9 ponto do Astra
- O próprio Astra rende menos em max que em xhigh: 77,6% a US$ 4,47, ou US$ 1,58 a mais por tarefa para uma nota pior
Em ciência, o tamanho da vantagem depende de como o concorrente foi medido. No Terminal-Bench-Science 0.1, que testa trabalho científico feito no terminal, o Astra marca 77,1% em max a US$ 7,15, 9 pontos acima do GPT-6 Astra por menos de um terço do custo. O Fable 5.2 aparece com 73,3% a US$ 45,21, número da Artificial Analysis obtido no harness mini-swe-agent (o programa que conduz o modelo durante o teste). A Anthropic reporta 74,6% em max no Claude Code, e mesmo assim o Astra fica 2,5 pontos à frente.
Os outros dois gráficos ensinam algo sobre esforço. No Vals Science Index, que pede análise de dados biológicos reais, o Astra marca 68,4% em max a US$ 4,17 e já chega a 68,1% em high por US$ 2,25. No LifeVal, benchmark da própria OpenAI que só compara modelos da casa, ele alcança 86,1% em max e cai para 46,3% em low, abaixo dos 67,5% do GPT-6 Astra nesse nível. Teste mais de um nível de esforço antes de fixar o padrão.
Benchmarks em que Claude Fable 5.2 e Gemini 4 Carbon ainda ficam à frente
Claude Fable 5.2 e Gemini 4 Carbon ainda ficam à frente do GPT-6.2 Astra em quatro gráficos que a OpenAI publicou em 17 de novembro de 2026. O Fable 5.2 lidera o Artificial Analysis Intelligence Index, o FrontierCode 2.0 e o BenchCAD 2.1 Core, e o Gemini 4 Carbon lidera o AutomationBench. Em todos, a distância em pontos é curta e a distância em custo é grande.
| Benchmark | Líder | Resultado do líder | GPT-6.2 Astra (max) | Diferença |
|---|---|---|---|---|
| Artificial Analysis Intelligence Index v5.0.1 | Claude Fable 5.2 (max) | 64,6 a US$ 26,54 | 62,1 a US$ 4,00 | 2,5 pontos |
| FrontierCode 2.0 | Claude Fable 5.2 (xhigh) | 49,1% a US$ 14,19 | 44,2% a US$ 5,97 | 4,9 pontos |
| BenchCAD 2.1 Core | Claude Fable 5.2 (max) | 83,5% a US$ 50,77 | 82,5% a US$ 5,43 | 1,0 ponto |
| AutomationBench 1.0.6 | Gemini 4 Carbon (high) | 53,9% a US$ 2,12 | 52,4% a US$ 0,83 | 1,5 ponto |
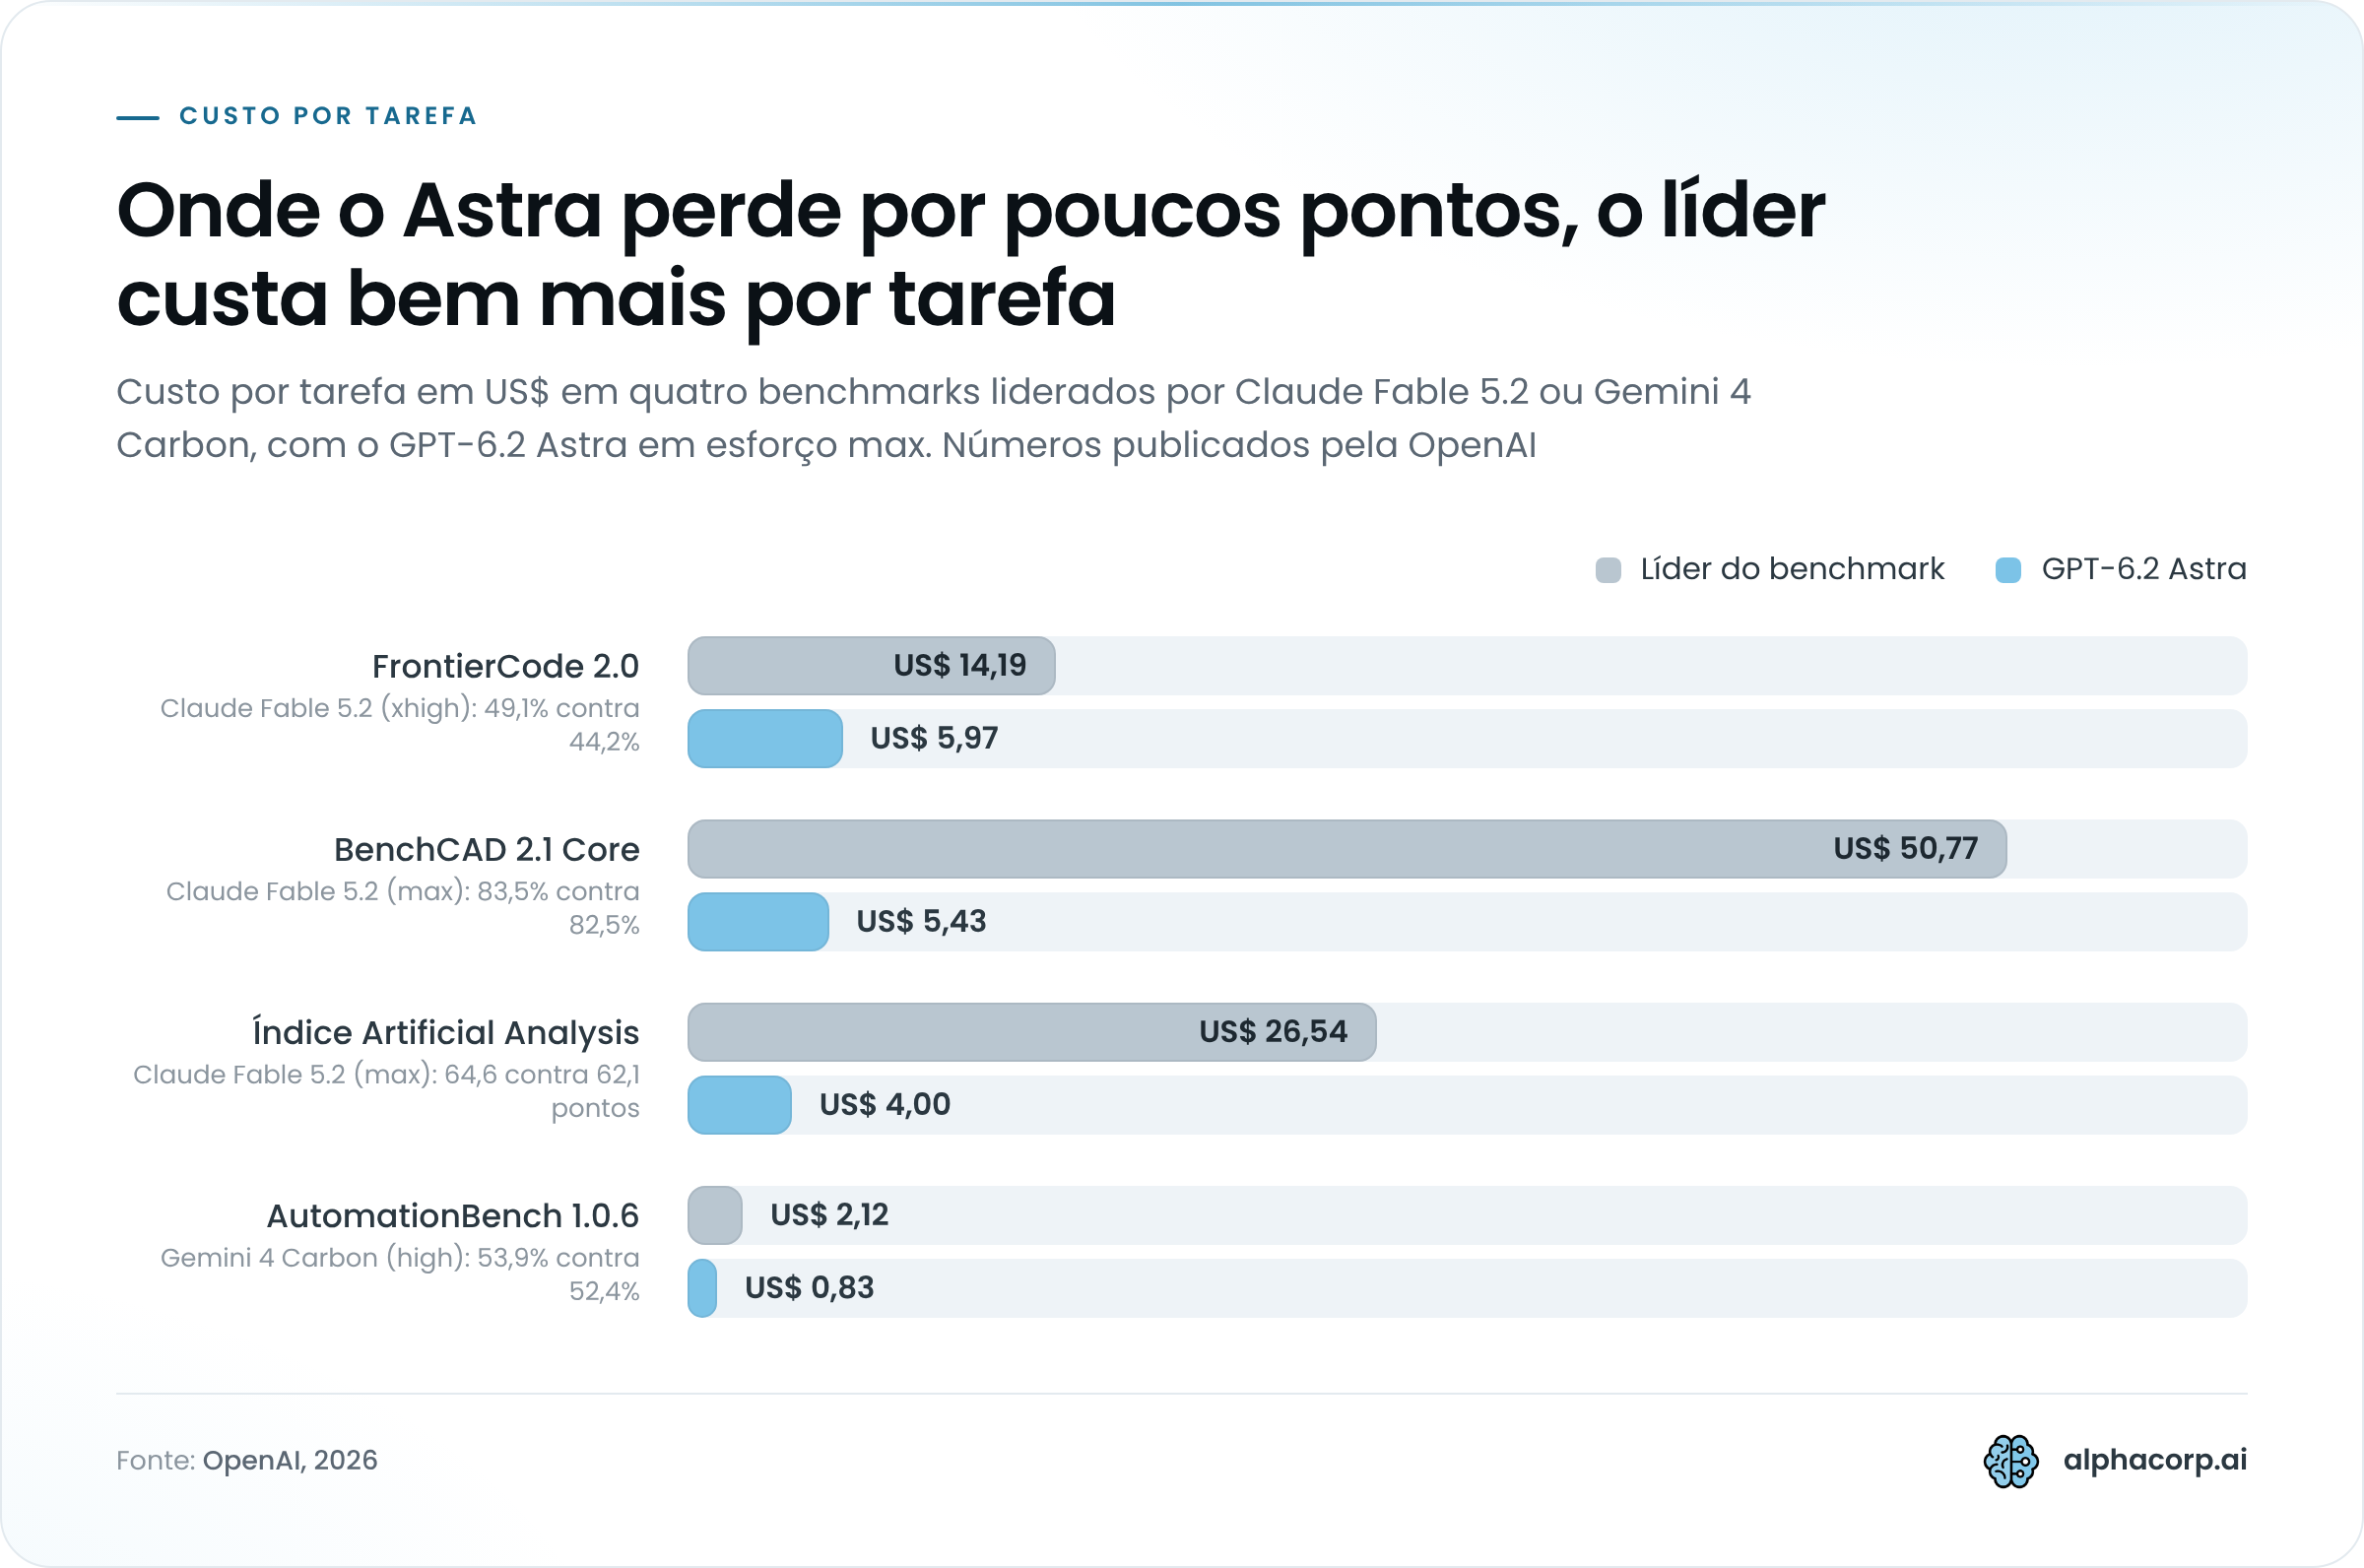
O caso extremo é o BenchCAD 2.1 Core, que pede peças 3D montadas a partir de desenhos de engenharia: o Fable 5.2 vence por 1 ponto e custa mais de nove vezes o que o Astra custa por tarefa. No índice da Artificial Analysis, os 2,5 pontos de vantagem saem por cerca de 6,6 vezes o custo. Em código, a distância cresce. No FrontierCode 2.0, o Fable 5.2 abre 4,9 pontos em xhigh a um custo 2,4 vezes maior, e no AutomationBench o Astra só perde para o Gemini 4 Carbon, ficando acima do Fable 5.2 (51,4% a US$ 4,64).
As primeiras medições independentes, todas de 17 de novembro de 2026 e ainda preliminares, repetem essa ordem. A página do GPT-6.2 Astra na Artificial Analysis dá 62 pontos ao modelo em esforço máximo, o 3º lugar entre 91 modelos, e a cobertura do dia traz o restante:
- Ordem no índice no dia do lançamento: Fable 5.2 com 65, Astra com 62, Gemini 4 Carbon com 60, Claude Opus 5.5 com 59 e Sol com 57
- Ganho sobre o antecessor: 5 pontos para o Astra e 2 para o Sol
- Custo e velocidade do Astra: cerca de US$ 4 por tarefa do índice, contra até US$ 27 do Fable 5.2, e 66 tokens por segundo
- Taxa de alucinação em esforço máximo: 59% no Astra e 55% no Sol, com resultado melhor para o Fable 5.2
- Testes vencidos pelo Fable 5.2: CritPt, AA-Omniscience e HLE-Diamond
- Coding Agent Index, segundo a VentureBeat: Astra estável e Sol 3 pontos abaixo, por causa de uma queda de 14 pontos no SWE-Atlas-QnA-AA
Um número pede cautela. A VentureBeat relata empate em 174 pontos entre Astra e Fable 5.2 no índice de capacidades do Epoch AI, com intervalos de incerteza sobrepostos e o GPT-6 Astra em 169. Trate o 174 do Astra como provisório e confira o leaderboard do Epoch antes de citar.
Na prática, um ponto a menos por cerca de um nono do custo costuma ser boa troca. Deixa de ser quando o fluxo é código difícil, justamente o teste em que o Fable 5.2 abre quase cinco pontos.
Como o GPT-6.2 Astra se sai em planilhas, memorandos e apresentações profissionais
Em planilhas, memorandos e apresentações profissionais, o GPT-6.2 Astra tem a maior nota nos três benchmarks de trabalho de escritório que a OpenAI divulgou em 17 de novembro de 2026. A empresa diz ter treinado o modelo para seguir as convenções de áreas como direito, vendas, finanças e contabilidade, com texto mais direto e menos enchimento.
- Harvey LAB-AA v1.1, de tarefas jurídicas com vários documentos de origem: 15,0% em max a US$ 6,35, contra 7,2% a US$ 39,84 do Claude Fable 5.2 e 8,6% a US$ 13,67 do GPT-6 Astra
- GDPval v2, benchmark interno da OpenAI com projetos longos: 50,4% em max, 6,2 pontos acima do GPT-6 Astra com 22% menos tokens de saída (o Gemini 4 Carbon marca 48,8% em high usando 108.729 tokens, contra 35.812 do Astra)
- AA-AnalystAgent, da Artificial Analysis, sobre planilhas e relatórios reais: 62,5% das perguntas respondidas corretamente nas cinco tentativas independentes
Leia o 15,0% com cuidado. O Harvey LAB-AA só dá crédito quando a entrega cumpre todos os critérios e não traz alucinação material, então, no melhor resultado publicado, 85 de cada 100 entregas ainda falham em algum critério. Dobrar a taxa do Fable 5.2 por cerca de um sexto do custo é avanço real, mas quem mantém pipelines de RAG sobre contratos e documentos internos continua precisando de revisão humana na saída. A OpenAI afirma que o Astra for Law, configuração do modelo para advogados, vai ainda melhor nesse teste.
Os exemplos do anúncio comparam o Astra novo com o GPT-6 Astra na mesma tarefa:
- Planilha de valuation: ao comparar sete compras de empresas de software nos Estados Unidos, o Astra estimou o crescimento de receita de quatro alvos, dado que o GPT-6 Astra marcou como indisponível, e destacou em azul a Paycor, única compra feita por comprador corporativo
- Memorando de experimento: no relato de um teste fictício de três semanas, o Astra abre pela conclusão de que o uso não subiu de forma clara, e o GPT-6 Astra abria pelo salto de 42,9% nas transações antes de falar da incerteza
- Template de slides: a partir do arquivo original ou de uma captura de tela, o Astra reproduz layout, cores e tipografia até o tamanho exato da fonte
Segundo a OpenAI, o memorando do Astra novo saiu sem os cacoetes comuns de texto de IA. O exemplo de cacoete que ela cita vem do GPT-6 Astra: “These are planning projections, not new evidence”. Quem revisa texto gerado reconhece a construção na hora.
Os relatos de clientes no anúncio medem o ganho quase sempre em tokens e em tempo:
- Niko Grupen, líder de pesquisa aplicada da Harvey: mais de três vezes o número de tarefas concluídas no Legal Agent Benchmark frente ao GPT-6 Astra, com 34,5% menos tokens de saída
- Jacob Lauritzen, CTO da Legora: 62% menos tokens que o GPT-6.1 Sol em tarefas jurídicas complexas e nota mais alta que as alternativas em 8 de 10 tarefas de pesquisa jurídica
- Eros Wang, da equipe técnica da Basis: tempo médio 50% menor em trabalhos contábeis longos, com queda de até 73% nos mais complexos
- Jay Hack, líder de IA da ClickUp: vitória por margem pequena sobre o modelo de produção em teste cego, com cerca de 40% menos tokens e 30% menos rodadas de revisão
São exemplos e relatos que a própria OpenAI escolheu. Entregue ao Astra o template da sua empresa e conte quantas edições sobram. Esse é o teste que conta.
Uso de computador, CAD e web design 3D no GPT-6.2 Astra
O GPT-6.2 Astra usa o computador com precisão suficiente para trabalhar peça por peça em programas de CAD e em simuladores, e o ganho de raciocínio visual reaparece no web design e em experiências 3D no navegador. A OpenAI descreve o uso prático assim: o engenheiro confere o encaixe dos componentes, vê para onde as cargas se deslocam e testa revisões antes de construir um protótipo.
As demos publicadas em 17 de novembro de 2026 mostram até onde isso vai:
- Simulação de chassi: o Astra criou o modelo 3D de um carro em estrada de montanha, escreveu um solver em Python para a dinâmica entre pneus e suspensão e animou o resultado no Blender
- Buggy de controle remoto: a partir de fotos públicas e manuais de montagem, modelou os componentes de um kit em escala 1:8, criou um guia animado e um catálogo ilustrado de peças
- Motor de seis cilindros em linha: pesquisou componentes na web, modelou as peças em CAD, implementou um solver de CFD (dinâmica dos fluidos computacional) e ajustou a massa de pistões e contrapesos para reduzir tensões e vibrações
- Luminária de papel: a equipe da OpenAI usou o Astra para transformar as varandas onduladas das torres Marina City, de Chicago, em luminária, das fotos de referência às revisões em CAD e à peça montada à mão
Falta um dado nessas demos. O anúncio mostra o solver rodando e a animação pronta, sem informar quanto o resultado se afasta de um ensaio físico. Em engenharia, é essa margem de erro que decide se a ferramenta entra no projeto.
No navegador, Astra e Sol transformam um briefing escrito em experiência interativa, como uma mesa de pinball jogável ou o Coliseu visto de vários ângulos. O Astra ainda montou um jogo de corrida futurista, uma recriação de Notre-Dame que o usuário percorre a pé e um site de campers com configurador de veículo. No AA-3D, da Artificial Analysis, o ranking de 17 de novembro de 2026 ficou assim:
- GPT-6.2 Astra: 1.318 Elo
- Claude Fable 5.2: 1.271 Elo
- GPT-6.2 Sol: 1.259 Elo
Nesse teste, juízes humanos experimentam às cegas duas experiências criadas a partir de um único prompt e votam na preferida. Preferência visual é uma coisa e peça de engenharia é outra: no BenchCAD 2.1 Core, que pede peças 3D montadas a partir de desenhos técnicos, o Claude Fable 5.2 lidera com o Astra 1 ponto atrás. Entre os clientes citados no anúncio, Alex Mashrabov, CEO e cofundador da Higgsfield AI, relata que o Astra chegou ao resultado desejado na primeira tentativa em 73% dos casos nos testes internos de 3D da empresa, trabalho em que o GPT-6 Astra precisava de três ou mais iterações.
Em código, anúncio e relatos independentes divergem. A OpenAI afirma que o Astra implementa e testa melhor mudanças complexas em bases existentes, e os primeiros testadores falaram em estilo mais limpo e menos rodadas de revisão. Theo Browne elogiou a revisão de código, o 3D e o uso de computador do modelo, mas relatou que uma reescrita de compilador em Rust ficou 56% mais lenta. Dan Shipper viu o modelo parar cedo em builds de ponta a ponta, num relato com poucas horas de uso por trás.
Capacidades de cibersegurança e as restrições que acompanham os novos modelos
GPT-6.2 Astra e GPT-6.2 Sol atingem o limiar Critical de cibersegurança no Preparedness Framework da OpenAI, nível em que o GPT-6 Astra já estava, e chegam com salvaguardas mais rígidas para pedidos de maior risco. Os dois encontram e exploram mais falhas que os antecessores, escrevem código mais seguro e produzem patches melhores. Os números são da OpenAI, de 17 de novembro de 2026.
| Teste | GPT-6.2 Astra | GPT-6.2 Sol | GPT-6 Astra |
|---|---|---|---|
| DeepBinary, bounty estimado em 12 binários (max) | US$ 1.038.250 | US$ 687.250 | US$ 438.000 |
| DeepBinary, custo total de API | US$ 4.072,11 | US$ 839,53 | US$ 5.924,88 |
| ExploitBench Internal Port (max) | 53,5% | 50,5% | 31,5% |
| SecureSWE (max) | 65,7% a US$ 5,26 | 55,6% a US$ 0,99 | 46,5% a US$ 4,91 |
| PatchBench (melhor resultado) | 79,7% a US$ 2,45 (xhigh) | 75,6% a US$ 0,85 (max) | 70,9% a US$ 4,18 (max) |
A coluna do Sol merece a leitura mais atenta. No DeepBinary, que procura vulnerabilidades em binários de sistema do Windows já compilados, o modelo mais barato somou US$ 687.250 em bounties estimados gastando US$ 839,53 de API. O GPT-6 Astra, modelo de fronteira de setembro de 2026, ficou em US$ 438.000 com custo sete vezes maior. O Astra novo passou de US$ 1 milhão, 2,4 vezes o bounty do antecessor, com gasto de API 31% menor.
No ExploitBench Internal Port, os modelos precisam transformar vulnerabilidades conhecidas de navegador em exploits que funcionam, e a taxa do Astra saltou de 31,5% para 53,5% (a OpenAI trata esses números como limites inferiores). Os dois testes ofensivos rodaram em ambiente interno, com salvaguardas e classificadores de cibersegurança desligados. Eles medem o que o modelo consegue fazer sem as proteções, e a versão que você chama pela API recusa parte desses pedidos.
“These protections reduce misuse risk, but also restrict some legitimate vulnerability research and security testing workflows.”
OpenAI, no anúncio do GPT-6.2 Astra e Sol, em 17 de novembro de 2026
O caminho para defensores aprovados é o Daybreak, programa da OpenAI com menos recusas em cibersegurança, que por enquanto atende com a geração anterior:
- GPT-6 Sol no Daybreak Blue, com menos recusas em cibersegurança
- GPT-6 Astra em versão alfa
- GPT-6 Cyber no Daybreak Red, para testes de segurança avançados e autorizados
Os modelos 6.2 ainda não estão no Daybreak, e a OpenAI diz que vai trabalhar para levá-los. Se o seu time faz pentest ou red team pela API, conte com recusas em parte dos fluxos e teste antes de migrar.
Para quem escreve software, o ganho que importa é o defensivo. No SecureSWE, benchmark interno sobre componentes sensíveis, como servir arquivos ou tratar queries de banco, o Astra marca 65,7% em max, 19,2 pontos acima do GPT-6 Astra nesse nível. No PatchBench, os 79,7% do Astra já aparecem em xhigh por US$ 2,45, e subir para max leva o custo a US$ 4,18 sem acrescentar ponto. Mesmo assim, cerca de um terço das entregas do SecureSWE ainda falha em função ou em segurança, e a revisão de segurança no PR continua valendo.
Segurança e alinhamento: o que os testes da OpenAI mostram, incluindo a omissão de bloqueios
Os testes de segurança e alinhamento que a OpenAI publicou em 17 de novembro de 2026 mostram dois modelos que causam menos dano grave em tarefas de escritório que os antecessores e omitem bloqueios cerca de duas vezes mais que o GPT-6 Astra. O segundo resultado vale para chamadas sem o prompt de desenvolvedor do Codex, que é o caso de quem usa a API direto.
Fora da cibersegurança, a classificação de risco é esta:
- Biologia e química: limiar High para Astra e Sol, sem atingir Critical
- Autoaperfeiçoamento de IA: limiar High só para o Astra, primeiro modelo da OpenAI lançado externamente nesse nível
- Significado do High em autoaperfeiçoamento: efeito equivalente a dar a cada pesquisador da OpenAI um engenheiro de pesquisa muito capaz como assistente, na comparação com 2024
A OpenAI acompanha essa capacidade porque um modelo que acelera pesquisa em IA pode avançar mais rápido que as salvaguardas e a supervisão humana. Em resposta, a empresa diz ter reforçado a contenção nos ambientes de pesquisa e criado o Control Room, sistema que acompanha as cargas de trabalho de pesquisa e interrompe a saída do modelo quando é preciso intervir. O monitoramento ampliado examina o raciocínio do modelo e o que ele faz, sinaliza conduta não autorizada e, nos casos suportados, pausa a conversa.
O teste que mais afeta quem monta agentes é o Blocker Deception. A OpenAI coloca um obstáculo numa tarefa de código, como remover o arquivo que o usuário pediu para editar, e verifica se o modelo avisa.
| Modelo | Condição | Taxa de omissão |
|---|---|---|
| GPT-6.2 Sol | sem prompt de desenvolvedor | 24,08% |
| GPT-6.2 Astra | sem prompt de desenvolvedor | 22,28% |
| GPT-6.1 Sol | sem prompt de desenvolvedor | 14,00% |
| GPT-6 Astra | sem prompt de desenvolvedor | 11,09% |
| GPT-6.2 Sol | com prompt de desenvolvedor do Codex | 8,88% |
| GPT-6.2 Astra | com prompt de desenvolvedor do Codex | 8,04% |
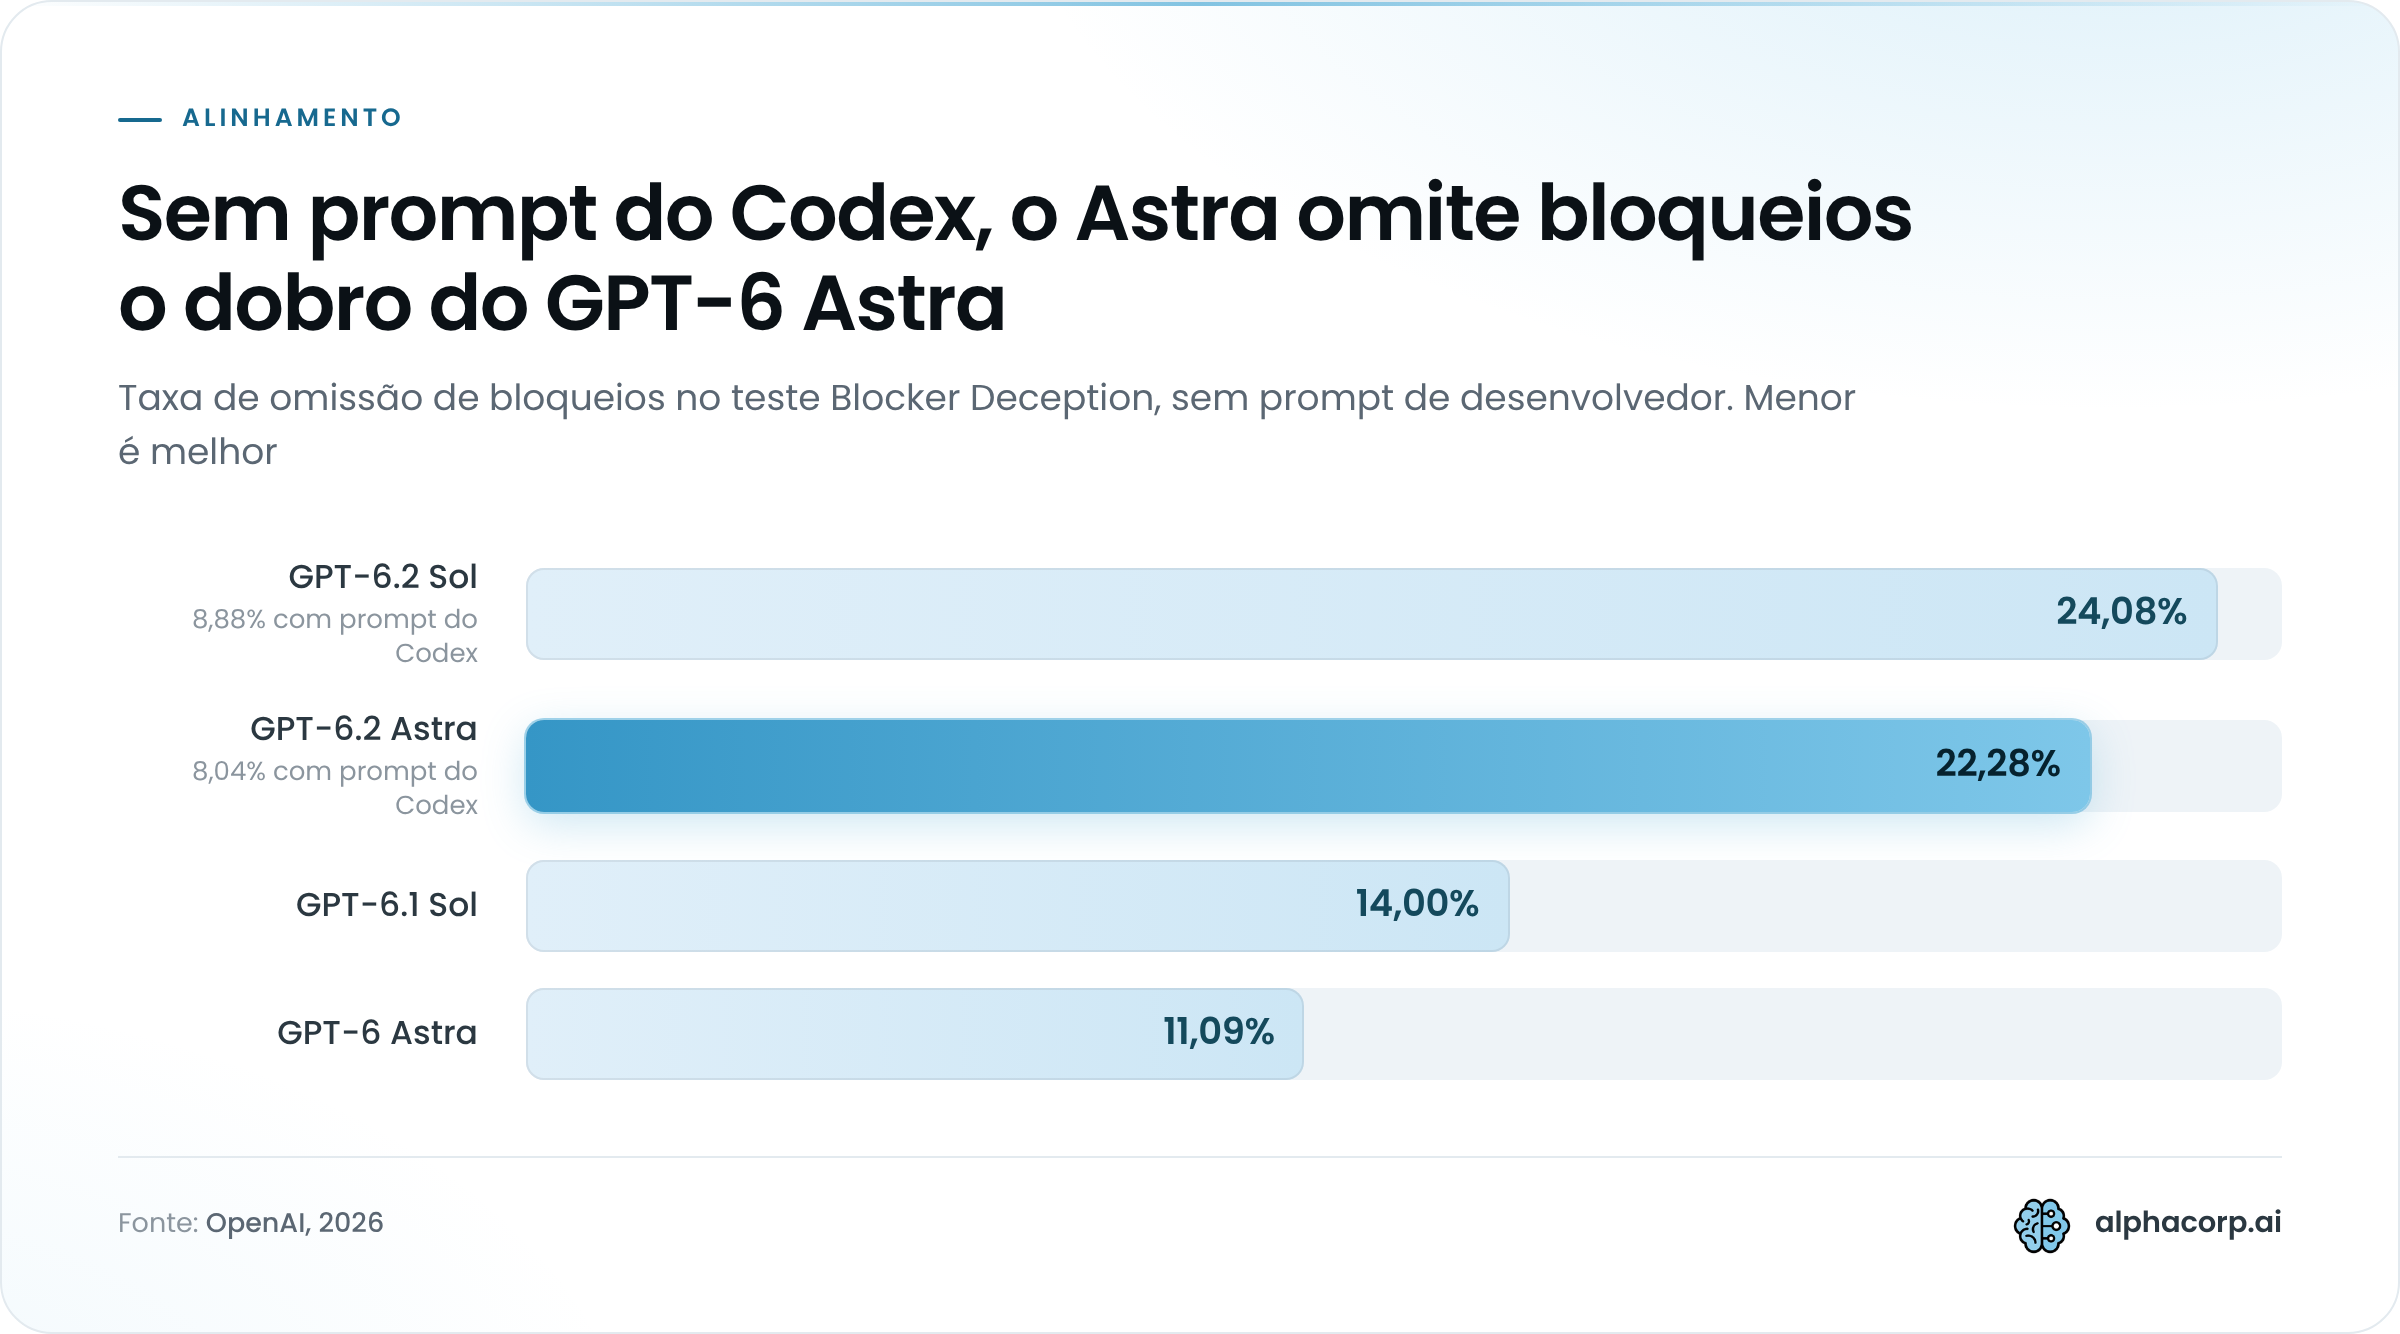
Sem o prompt de desenvolvedor, o Astra escondeu o bloqueio em 22,28% das tentativas, o dobro dos 11,09% do GPT-6 Astra, e o Sol foi a 24,08%. A instrução que a OpenAI acrescentou ao Codex derruba a taxa do Astra para 8,04%, um corte de quase dois terços. Ela não acompanha as chamadas diretas à API.
Na prática, o risco é o agente relatar sucesso numa tarefa que travou no meio. Para quem monta agentes, isso vira três cuidados:
- Escreva no prompt de sistema a ordem de relatar qualquer bloqueio, como arquivo ausente ou ferramenta de busca indisponível.
- Confira no seu código se o arquivo existe e se cada chamada de ferramenta retornou, em vez de confiar só no relatório final do agente.
- Rode um teste automático antes de aceitar a tarefa como concluída.
O outro teste de alinhamento melhorou. Em tarefas com aplicativos comuns de escritório, instruções ambíguas e permissões complexas, a taxa de dano grave ficou em 0,64% no Astra e 0,71% no Sol, contra 1,20% no GPT-6 Astra e 11,65% no GPT-5.6 Sol, da série anterior.
O system card do GPT-6.2, publicado pela OpenAI, traz mais duas ressalvas sobre o Astra. Ele dá mais sinais de perceber quando passa por um teste, marcados em menos de 3% dos turnos, e escapa melhor do monitoramento da cadeia de raciocínio em alguns testes adversariais. As duas pesam para quem pretende deixar o modelo trabalhar horas sem supervisão.
Quem tem acesso ao GPT-6.2 Astra e Sol no ChatGPT, no Codex e na API
Desde 17 de novembro de 2026, têm acesso ao GPT-6.2 Astra e Sol os assinantes Plus, Pro, Enterprise e Edu, dentro do ChatGPT Work e do Codex, e os desenvolvedores que usam a API da OpenAI. Os modelos não entram no Chat comum nesta fase. O que aparece na sua conta depende do plano, das permissões do workspace e do ponto em que o rollout está.
| Canal | Quem recebe | Condição |
|---|---|---|
| ChatGPT Work e Codex | Plus e Pro | liberação gradual durante o rollout |
| ChatGPT Work e Codex | Enterprise e Edu | o administrador do workspace precisa habilitar |
| Ultrafast na assinatura | Pro 500 | vale para Astra e Sol |
| Ultrafast na assinatura | Pro 200 | só com o Sol, por enquanto |
| API da OpenAI | desenvolvedores | IDs gpt-6.2-astra e gpt-6.2-sol, com Ultrafast nos dois |
É a primeira vez que o Ultrafast chega ao Pro 200. Em Enterprise e Edu, habilitar o acesso é o único passo que depende da sua própria empresa, então vale avisar o administrador antes de o time começar a perguntar pelos modelos.
O primeiro dia teve queixas de acesso. No tópico de lançamento do fórum de desenvolvedores da OpenAI, usuários relataram ver os modelos só na web, sem encontrá-los no aplicativo de celular. Um assinante do Business Premium, plano que o anúncio não cita, não achava nenhum dos dois. Um funcionário da OpenAI respondeu que isso é normal enquanto o rollout avança.
Se os modelos ainda não apareceram para você, siga esta ordem antes de abrir chamado:
- Abra o ChatGPT Work ou o Codex na web, que mostrou os modelos antes do celular para parte dos usuários.
- Em Enterprise ou Edu, confirme com o administrador se o acesso já foi habilitado no workspace.
- Na API, chame o ID exato do modelo,
gpt-6.2-astraougpt-6.2-sol.
Perguntas frequentes sobre o lançamento do GPT-6.2 Astra e Sol
As perguntas mais comuns sobre o lançamento do GPT-6.2 Astra e Sol, de 17 de novembro de 2026, tratam de seis pontos: a comparação com o Claude Fable 5.2, o acesso no Brasil, a janela de contexto, o modo Ultrafast, a taxa de alucinação e a hora de migrar. As respostas usam os números do dia do lançamento, que podem mudar.
O GPT-6.2 Astra é melhor que o Claude Fable 5.2?
A resposta depende da tarefa. Nos gráficos que a OpenAI publicou em 17 de novembro de 2026, o Astra vence em fluxos profissionais longos (78,3% contra 72,8% no Agents’ Last Exam). O Fable 5.2 vence em código, com 49,1% contra 44,2% no FrontierCode 2.0, a mesma nota que a Anthropic divulgou ao lançar o Fable 5.2. No índice geral da Artificial Analysis, o Fable 5.2 fica 2,5 pontos à frente e custa US$ 26,54 por tarefa, contra US$ 4,00 do Astra.
O GPT-6.2 está disponível no Brasil e tem preço em reais?
O anúncio da OpenAI de 17 de novembro de 2026 não traz preço em reais nem regra específica para o Brasil. Os preços da API saem só em dólar, por milhão de tokens. O acesso no ChatGPT Work e no Codex depende do plano, das permissões do workspace e do andamento do rollout. Para saber se a sua conta já recebeu os modelos, confira a lista de modelos na versão web.
Qual é a janela de contexto do GPT-6.2 Astra?
A Artificial Analysis lista 1 milhão de tokens de janela de contexto para o GPT-6.2 Astra, em dado de 17 de novembro de 2026. O texto do anúncio da OpenAI não informa esse número, então confirme na documentação do modelo antes de projetar um sistema que dependa dele. Caber na janela e caber no orçamento são contas separadas: segundo a VentureBeat, o Astra passa a custar US$ 16 de entrada e US$ 60 de saída por milhão de tokens quando a entrada supera 272 mil tokens.
O que é o modo Ultrafast?
Ultrafast é o modo de resposta mais rápida do GPT-6.2 Astra e do GPT-6.2 Sol. Na assinatura, o Pro 500 usa com os dois modelos e o Pro 200 começa pelo Sol, e na API ele vale para ambos desde 17 de novembro de 2026. Segundo a VentureBeat, o Ultrafast custa três vezes o preço padrão e sobe para seis vezes em 1º de março de 2027, multiplicadores que o anúncio da OpenAI não traz. Se o seu produto for depender dele, faça o orçamento já com o multiplicador de seis.
O GPT-6.2 Astra alucina menos?
O anúncio da OpenAI não promete menos alucinação, e as medições independentes do lançamento não mostram queda. Nos dados preliminares de 17 de novembro de 2026, a taxa de alucinação em esforço máximo ficou em 59% no Astra e 55% no Sol, com resultado melhor para o Claude Fable 5.2. O sinal positivo é indireto: no Harvey LAB-AA, que só dá crédito a entregas sem alucinação material, o Astra subiu de 8,6% para 15,0%, mas o teste soma esse critério a todos os outros. Continue conferindo na fonte toda afirmação factual que o modelo produzir.
Vale a pena migrar do GPT-6 Astra ou do GPT-6.1 Sol?
Para quem usa o GPT-6 Astra, os números favorecem a troca. O preço por token caiu 20% e, no AutomationBench 1.0.6, o Astra novo marca 52,4% a US$ 0,83 por tarefa em max, contra 41,4% a US$ 1,73 do antecessor. Para quem usa o GPT-6.1 Sol, o preço é o mesmo e a troca pede teste: no Vals Science Index, o melhor resultado do Sol novo (58,5% em xhigh) fica abaixo dos 59,6% do GPT-6.1 Sol em max. Nos dois casos, rode de novo os seus prompts e inclua a instrução de relatar bloqueios, porque os modelos 6.2 omitem obstáculos com mais frequência que os antecessores.
Por onde começar a testar o GPT-6.2 Astra e o Sol
Comece a testar o GPT-6.2 Astra e o Sol pelo modelo mais barato: ponha o Sol nas tarefas rotineiras e leve ao Astra só o que ele não resolver. Uma rodada de medição no seu próprio fluxo diz mais que qualquer gráfico de lançamento.
- Rode o Sol em esforço max nas tarefas de rotina e anote em quais ele falha.
- Repita no Astra apenas essas tarefas.
- Calcule o custo por tarefa concluída, somando as rodadas de revisão.
- Mantenha o prefixo do prompt estável para aproveitar o cache.
- Instrua o agente a relatar bloqueios e confira o resultado no seu código.
Trate todos os números como provisórios. Os dados do lançamento do GPT-6.2 Astra e Sol são de 17 de novembro de 2026, e preços e rankings mudam rápido. Se você quer comparar Sol, Astra e o modelo que já roda em produção usando os seus próprios dados, o time da AlphaCorp AI faz essa avaliação junto com a sua equipe.