Neste artigo(22)
- GPT-6.2 Astra vs Claude Fable 5.2: qual é melhor para cada tipo de trabalho?
- Placar dos benchmarks publicados pela OpenAI: onde cada modelo lidera
- Quanto custam o GPT-6.2 Astra e o Claude Fable 5.2 na API e por tarefa?
- Trabalho profissional de várias etapas: resultados no Agents' Last Exam e no Harvey LAB-AA
- Código e engenharia: resultados no FrontierCode 2.0 e no BenchCAD, onde o Claude Fable 5.2 lidera
- Pesquisa científica: Terminal-Bench-Science e Vals Science Index, com os números de cada laboratório
- Terminal-Bench-Science 0.1: 77,1% do Astra contra 73,3% ou 74,6% do Fable
- Vals Science Index v1: 4,4 pontos de vantagem no mesmo nível de esforço
- Eficiência no GDPval v2: quantos tokens de saída cada modelo gasta
- O que a tabela de benchmarks da Anthropic mostra sobre o Claude Fable 5.2
- Limites desta comparação: testes rodados pela OpenAI, harnesses e níveis de esforço diferentes
- Salvaguardas de cibersegurança e biologia: o que cada modelo restringe
- Perguntas frequentes sobre GPT-6.2 Astra vs Claude Fable 5.2
- Qual é melhor para programar, GPT-6.2 Astra ou Claude Fable 5.2?
- Qual dos dois é mais barato?
- Quanto custam o GPT-6.2 Astra e o Claude Fable 5.2 em reais?
- Quando o GPT-6.2 Astra e o Claude Fable 5.2 foram lançados?
- Onde usar o GPT-6.2 Astra e o Claude Fable 5.2?
- Qual é o tamanho da janela de contexto de cada modelo?
- Qual a diferença entre Claude Fable 5.2 e Claude Mythos 5.2?
- Qual a diferença entre GPT-6.2 Astra e GPT-6.2 Sol?
- Por onde começar: como escolher e testar os dois modelos no seu caso de uso
Na disputa GPT-6.2 Astra vs Claude Fable 5.2, o preço por token é idêntico em 17 de novembro de 2026, e a fatura por tarefa sai bem diferente. Para a maioria das cargas, o Astra é a melhor escolha: lidera seis dos nove benchmarks que a OpenAI publicou com os dois modelos e gasta menos em todos. O Fable 5.2 ganha em código e CAD, cobrando de duas a nove vezes mais por tarefa.
Este comparativo traz a nota e o custo de cada teste, os preços da API e um roteiro para você testar os dois modelos nas suas tarefas.
Os números que mais pesam na decisão, todos de novembro de 2026:
- Preço na API: US$ 8 de entrada e US$ 40 de saída por milhão de tokens na tabela de preços da OpenAI, mesmo valor da tabela da Anthropic para o Fable 5.2
- Placar geral: 6 a 3 para o GPT-6.2 Astra nos nove benchmarks do anúncio da OpenAI de 17 de novembro de 2026
- Agents' Last Exam v1.1: 78,3% a US$ 2,89 por tarefa no Astra, contra 72,8% a US$ 60,05 no Fable 5.2, nos gráficos da OpenAI de 2026
- FrontierCode 2.0: 49,1% a US$ 14,19 por tarefa no Fable 5.2, contra 44,2% a US$ 5,97 no Astra, nos gráficos da OpenAI de 2026
- GDPval v2: 222.344 tokens de saída no Fable 5.2, contra 35.812 no Astra, no benchmark interno da OpenAI de 2026
GPT-6.2 Astra vs Claude Fable 5.2: qual é melhor para cada tipo de trabalho?
Em 17 de novembro de 2026, o GPT-6.2 Astra é a melhor escolha para trabalho profissional de várias etapas, jurídico, ciência e automação, e o Claude Fable 5.2 ganha em código e CAD, cobrando bem mais por tarefa. Não existe vencedor único entre os dois modelos de inteligência artificial (IA) de topo da OpenAI e da Anthropic, lançados com oito dias de diferença.
Um aviso antes dos resultados. Todos os confrontos diretos deste artigo saíram do anúncio do GPT-6.2 Astra publicado pela OpenAI, inclusive as notas e os custos atribuídos ao Fable 5.2. Por tipo de carga, o veredito fica assim:
- Trabalho profissional de várias etapas: GPT-6.2 Astra, por cerca de 5% do custo por tarefa do Fable 5.2
- Trabalho jurídico: GPT-6.2 Astra, com mais que o dobro da taxa de aprovação e cerca de um sexto do custo
- Pesquisa científica: GPT-6.2 Astra nos dois testes, gastando de duas a seis vezes menos
- Código em repositórios reais: Claude Fable 5.2, cerca de 5 pontos percentuais à frente, por pouco mais que o dobro do custo
- CAD e peças 3D: Claude Fable 5.2, com 1 ponto de vantagem e custo perto de nove vezes maior
- Automação de fluxos de negócio: GPT-6.2 Astra, 1 ponto à frente por menos de um quinto do custo
Se você precisa de uma recomendação só, comece pelo Astra. Ele lidera a maior parte dos testes publicados e, nos três em que perde, fica a no máximo 5 pontos do Fable 5.2 pagando uma fração do valor.
O Fable 5.2 se paga em dois perfis. O primeiro é o time que mede código pelo que o mantenedor aceita no merge, e o segundo é a equipe de engenharia que precisa do último ponto de precisão ao montar peças em CAD. Nesses casos, pagar de duas a nove vezes mais por tarefa fecha a conta quando o volume é baixo e o erro custa caro.
Até 17 de novembro de 2026, nenhuma avaliação independente repetiu esses confrontos. Use o veredito como ponto de partida para o seu próprio teste.
Placar dos benchmarks publicados pela OpenAI: onde cada modelo lidera
Nos nove benchmarks em que a OpenAI publicou os dois modelos lado a lado, em 17 de novembro de 2026, o GPT-6.2 Astra tem a maior pontuação em seis e o Claude Fable 5.2 em três. É um 6 a 3, longe de vitória total: o Fable 5.2 leva o teste de código, o de CAD e o índice geral de inteligência. A tabela traz a melhor marca de cada modelo, com o nível de esforço e o custo por tarefa daquela execução, tudo conforme a página da OpenAI, inclusive os números do Fable 5.2.
| Benchmark | Melhor do GPT-6.2 Astra | Melhor do Claude Fable 5.2 | Maior pontuação |
|---|---|---|---|
| Agents' Last Exam v1.1 | 78,3% em Xhigh (US$ 2,89) | 72,8% em Max (US$ 60,05) | GPT-6.2 Astra |
| Terminal-Bench-Science 0.1 | 77,1% em Max (US$ 7,15) | 73,3% em Max (US$ 45,21) | GPT-6.2 Astra |
| Artificial Analysis Intelligence Index v5.0.1 | 62,1 em Max (US$ 4,00) | 64,6 em Max (US$ 26,54) | Claude Fable 5.2 |
| FrontierCode 2.0 | 44,2% em Max (US$ 5,97) | 49,1% em Xhigh (US$ 14,19) | Claude Fable 5.2 |
| Harvey LAB-AA v1.1 | 15,0% em Max (US$ 6,35) | 7,2% em Max (US$ 39,84) | GPT-6.2 Astra |
| GDPval v2 (interno da OpenAI) | 50,4% em Max (35.812 tokens de saída) | 44,8% em Max (222.344 tokens de saída) | GPT-6.2 Astra |
| Vals Science Index v1 | 68,4% em Max (US$ 4,17) | 63,7% em High (US$ 8,79) | GPT-6.2 Astra |
| BenchCAD 2.1 Core | 82,5% em Max (US$ 5,43) | 83,5% em Max (US$ 50,77) | Claude Fable 5.2 |
| AutomationBench 1.0.6 | 52,4% em Max (US$ 0,83) | 51,4% em Max (US$ 4,64) | GPT-6.2 Astra |
Algumas linhas pedem leitura cuidadosa. No Terminal-Bench-Science 0.1, os 73,3% do Fable 5.2 são a medição da Artificial Analysis no harness mini-swe-agent (o ambiente que executa o agente), e a Anthropic reporta 74,6% em esforço máximo no Claude Code. São fontes e ambientes diferentes, e nenhum dos dois números chega aos 77,1% do Astra. No Agents' Last Exam, a OpenAI plotou o Fable 5.2 só em Max, e no Vals Science Index ele aparece só em High.
Em todas as nove linhas, a melhor execução do Fable 5.2 custou mais, ou consumiu mais tokens de saída, que a melhor do Astra. Três resultados merecem contexto:
- Artificial Analysis Intelligence Index v5.0.1: combina nove avaliações de trabalho de conhecimento, código, ciência e conhecimento geral, e o Fable 5.2 fecha 2,5 pontos à frente pagando US$ 26,54 contra US$ 4,00 do Astra
- AutomationBench 1.0.6: o Astra supera o Fable 5.2 por 1 ponto, mas a maior pontuação do gráfico é do Gemini 4 Carbon, com 53,9% em High a US$ 2,12
- AA-3D, da Artificial Analysis: fora dos nove gráficos, juízes humanos votam às cegas entre duas experiências 3D geradas do mesmo prompt, e o Astra lidera com 1.318 de Elo, à frente do Fable 5.2 (1.271) e do GPT-6.2 Sol (1.259)
O índice geral guarda o dado mais útil para quem tem orçamento fixo. Com cerca de US$ 4 por execução, o Astra em Max marca 62,1, e o Fable 5.2 em Medium fica em 56,4 por US$ 3,80. O Fable só passa a melhor marca do Astra a partir de Xhigh, quando faz 62,2 a US$ 14,83. Quem decide por pontuação máxima e quem decide por orçamento chegam a modelos diferentes.
Quanto custam o GPT-6.2 Astra e o Claude Fable 5.2 na API e por tarefa?
Em novembro de 2026, GPT-6.2 Astra e Claude Fable 5.2 têm preço idêntico na API (US$ 8 por milhão de tokens de entrada e US$ 40 de saída), mas o Astra gasta menos por tarefa nos testes da OpenAI. Os dois chegaram a esse valor do mesmo jeito: cortando 20% sobre os US$ 10 e US$ 50 da versão anterior. A tabela de preços do Claude Fable 5.2 na documentação da Anthropic e a página de preços da OpenAI, conferidas em 17/11/2026, só divergem nos detalhes.
| Item (US$ por milhão de tokens) | Claude Fable 5.2 | GPT-6.2 Astra |
|---|---|---|
| Entrada e saída | US$ 8 e US$ 40 | US$ 8 e US$ 40 |
| Leitura de cache | US$ 0,20 | US$ 0,40 |
| Escrita em cache | US$ 10 (5 min) ou US$ 16 (1 h) | US$ 10 (30 min) |
| Batch | 50% de desconto | US$ 4 e US$ 20 |
| Modo rápido | US$ 16 e US$ 80 | US$ 16 e US$ 80 |
| Modo ultrarrápido | Não tem | US$ 24 e US$ 120 até 28/02/2027 |
| Entrada acima de 272 mil tokens | não informado | US$ 16 e US$ 60 |
O Ultrafast da OpenAI passa de 3 para 6 vezes o preço padrão em 1º de março de 2027. A cobrança sai em dólar. A PTAX de venda do Banco Central fechou em R$ 5,7851 em 17/11/2026, contra R$ 5,5840 em 10/11, uma alta de cerca de 3,6% em uma semana, e IOF e impostos ainda entram por cima.
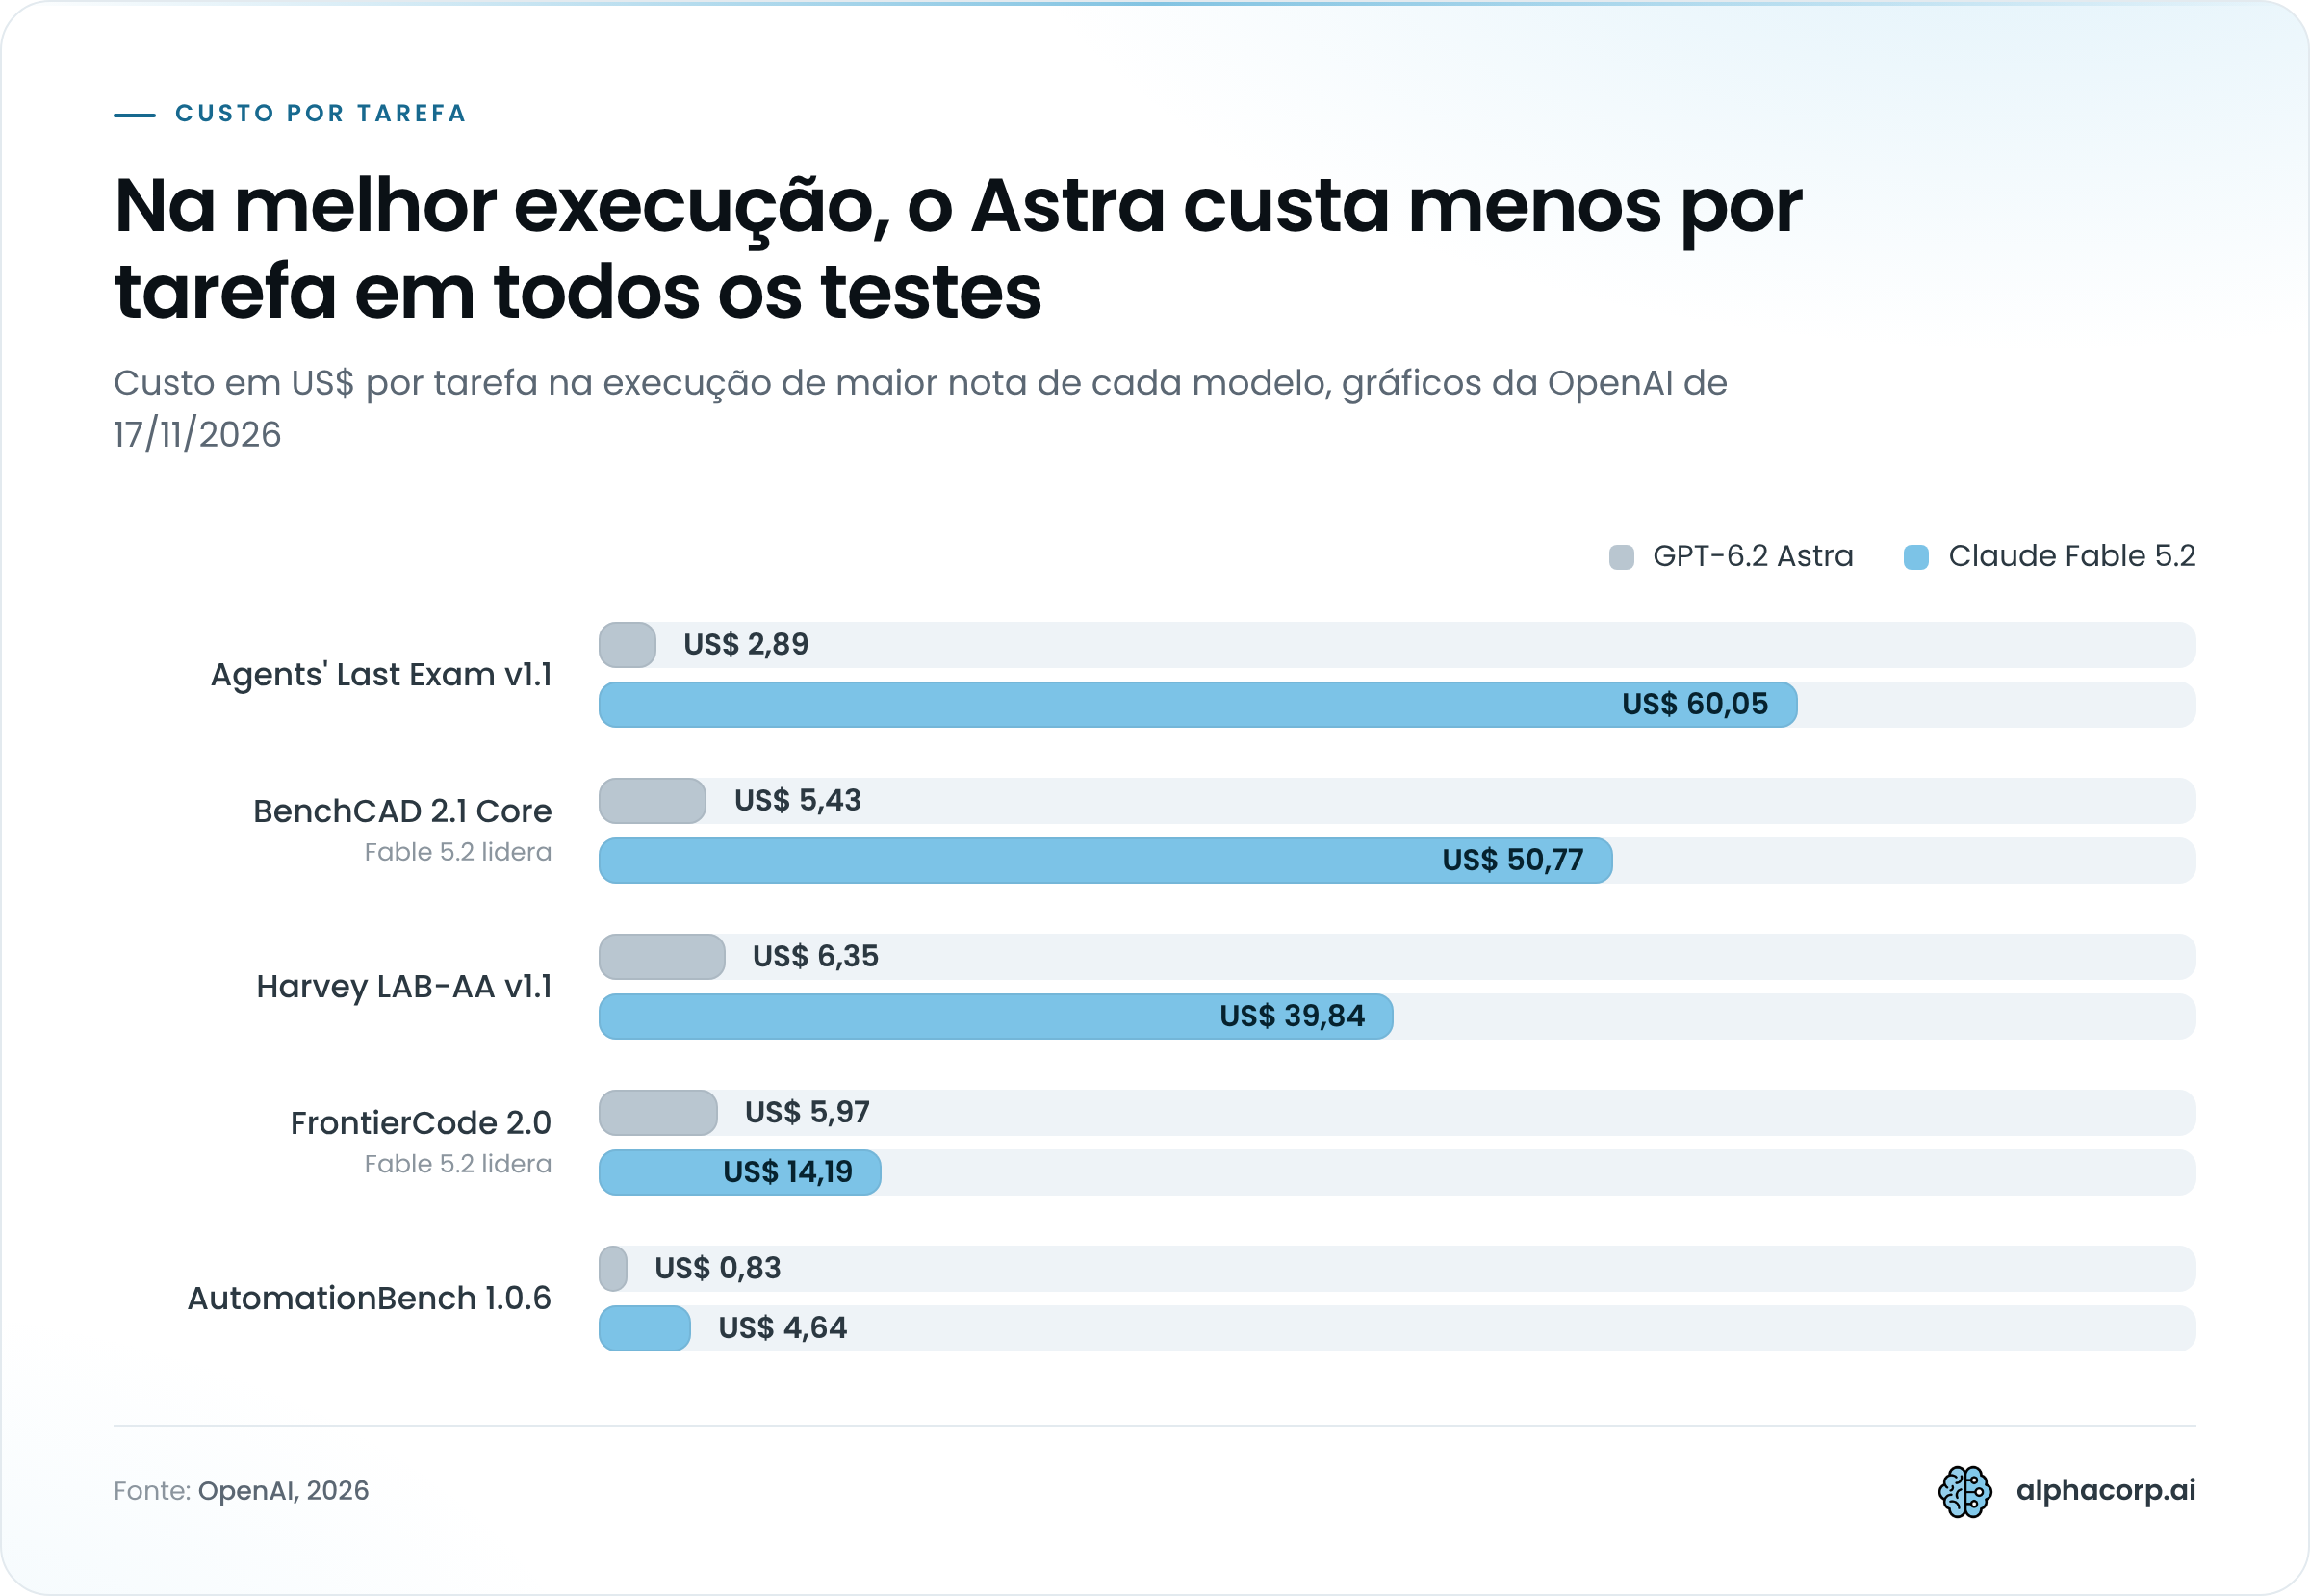
Preço igual não significa fatura igual. Na AlphaCorp AI, chamamos isso de regra do custo por tarefa: com o token no mesmo preço, a fatura depende de quantos tokens cada modelo consome até terminar o trabalho. Nos gráficos que a OpenAI publicou em 17/11/2026, a melhor execução de cada modelo custou, por tarefa:
- Agents' Last Exam v1.1: US$ 2,89 no Astra e US$ 60,05 no Fable 5.2
- Harvey LAB-AA v1.1: US$ 6,35 no Astra e US$ 39,84 no Fable 5.2
- FrontierCode 2.0: US$ 5,97 no Astra e US$ 14,19 no Fable 5.2, que lidera esse teste
- BenchCAD 2.1 Core: US$ 5,43 no Astra e US$ 50,77 no Fable 5.2, que também lidera
- AutomationBench 1.0.6: US$ 0,83 no Astra e US$ 4,64 no Fable 5.2
Antes de pagar pelo topo de linha, olhe o degrau de baixo. O GPT-6.2 Sol custa US$ 2 e US$ 10 por milhão de tokens, o Claude Opus 5.5 sai por US$ 4 e US$ 20 e o Sonnet 5.5 por US$ 2 e US$ 10, nas tabelas de novembro de 2026. A própria Anthropic recomenda começar pelo Opus 5.5 na maioria das cargas e reservar o Fable 5.2 para raciocínio exigente e agentes de longa duração.
Trabalho profissional de várias etapas: resultados no Agents' Last Exam e no Harvey LAB-AA
Em trabalho profissional de várias etapas, o GPT-6.2 Astra supera o Claude Fable 5.2 nos dois testes que a OpenAI publicou em 17 de novembro de 2026: 78,3% contra 72,8% no Agents' Last Exam v1.1 e 15,0% contra 7,2% no Harvey LAB-AA v1.1. Notas e custos dos dois modelos saíram da página da própria OpenAI.
O Agents' Last Exam avalia fluxos profissionais longos, com várias etapas encadeadas até a entrega. O gráfico traz estes pontos:
- GPT-6.2 Astra em Xhigh: 78,3% a US$ 2,89 por tarefa, a maior nota do gráfico
- GPT-6.2 Astra em Max: 77,6% a US$ 4,47, abaixo do próprio Xhigh
- GPT-6.2 Astra em Medium: 72,1% a US$ 1,06
- Claude Fable 5.2 em Max: 72,8% a US$ 60,05, único nível plotado
- Gemini 4 Carbon em High: 77,4% a US$ 4,60, a segunda maior nota
Se você mantém agentes de IA em produção, olhe primeiro a linha do Medium. Com US$ 1,06 por tarefa, o Astra fica a 0,7 ponto da nota que o Fable 5.2 alcança gastando US$ 60,05, ou seja, quase empata por menos de 2% do custo. Duas ressalvas acompanham o gráfico. A OpenAI plotou o Fable 5.2 apenas em Max, então ninguém vê ali quanto ele marcaria em níveis mais baratos, e o resultado dele no leaderboard exclui nove tarefas que usaram um modelo de fallback.
O Harvey LAB-AA v1.1 usa tarefas jurídicas, como revisar cláusulas de contrato. O modelo precisa achar os fatos relevantes nos documentos de origem, aplicar cada um a um briefing detalhado e produzir uma peça que cumpra todos os requisitos. A nota é uma taxa de aprovação total: só pontua a peça que atende a todos os critérios de correção e não traz alucinação material.
- GPT-6.2 Astra em Max: 15,0% a US$ 6,35 por tarefa
- Claude Fable 5.2 em Max: 7,2% a US$ 39,84
- GPT-6.2 Sol em Max: 11,1% a US$ 1,92
- Claude Fable 5.2 em Medium, High e Xhigh: 6,4%, 4,7% e 3,9%
O que mais nos surpreendeu foi a curva do Fable 5.2. Ele sai de 6,4% em Medium (US$ 9,67), cai para 4,7% em High (US$ 15,88) e para 3,9% em Xhigh (US$ 24,32), e só se recupera no nível mais caro. Mais esforço comprou nota pior duas vezes seguidas.
Agora a parte desconfortável. Uma nota de 15,0% quer dizer que, de cada 100 peças, 85 saem com pelo menos um critério descumprido ou uma alucinação material. Nenhum dos dois modelos entrega trabalho jurídico que dispense revisão humana, e o teste mostra apenas qual deles erra menos. A OpenAI afirma que a Astra for Law, configuração do modelo para advogados, pontua ainda mais nesse benchmark.
Código e engenharia: resultados no FrontierCode 2.0 e no BenchCAD, onde o Claude Fable 5.2 lidera
Em código e CAD, o Claude Fable 5.2 lidera o GPT-6.2 Astra nos gráficos que a OpenAI publicou em 17 de novembro de 2026: 49,1% contra 44,2% no FrontierCode 2.0 e 83,5% contra 82,5% no BenchCAD 2.1 Core. A vantagem tem preço. A melhor execução do Fable custa US$ 14,19 no primeiro teste e US$ 50,77 no segundo, contra US$ 5,97 e US$ 5,43 do Astra.
O FrontierCode 2.0, da Cognition, verifica se mudanças em repositórios reais passam pelo padrão de merge dos mantenedores. Por nível de esforço, nota e custo por tarefa ficam assim:
| Nível de esforço | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|
| Low | 38,1% (US$ 1,41) | 34,2% (US$ 2,10) |
| Medium | 42,2% (US$ 2,47) | 37,6% (US$ 2,48) |
| High | 43,6% (US$ 3,95) | 45,3% (US$ 6,72) |
| Xhigh | 44,1% (US$ 4,29) | 49,1% (US$ 14,19) |
| Max | 44,2% (US$ 5,97) | 45,6% (US$ 44,70) |
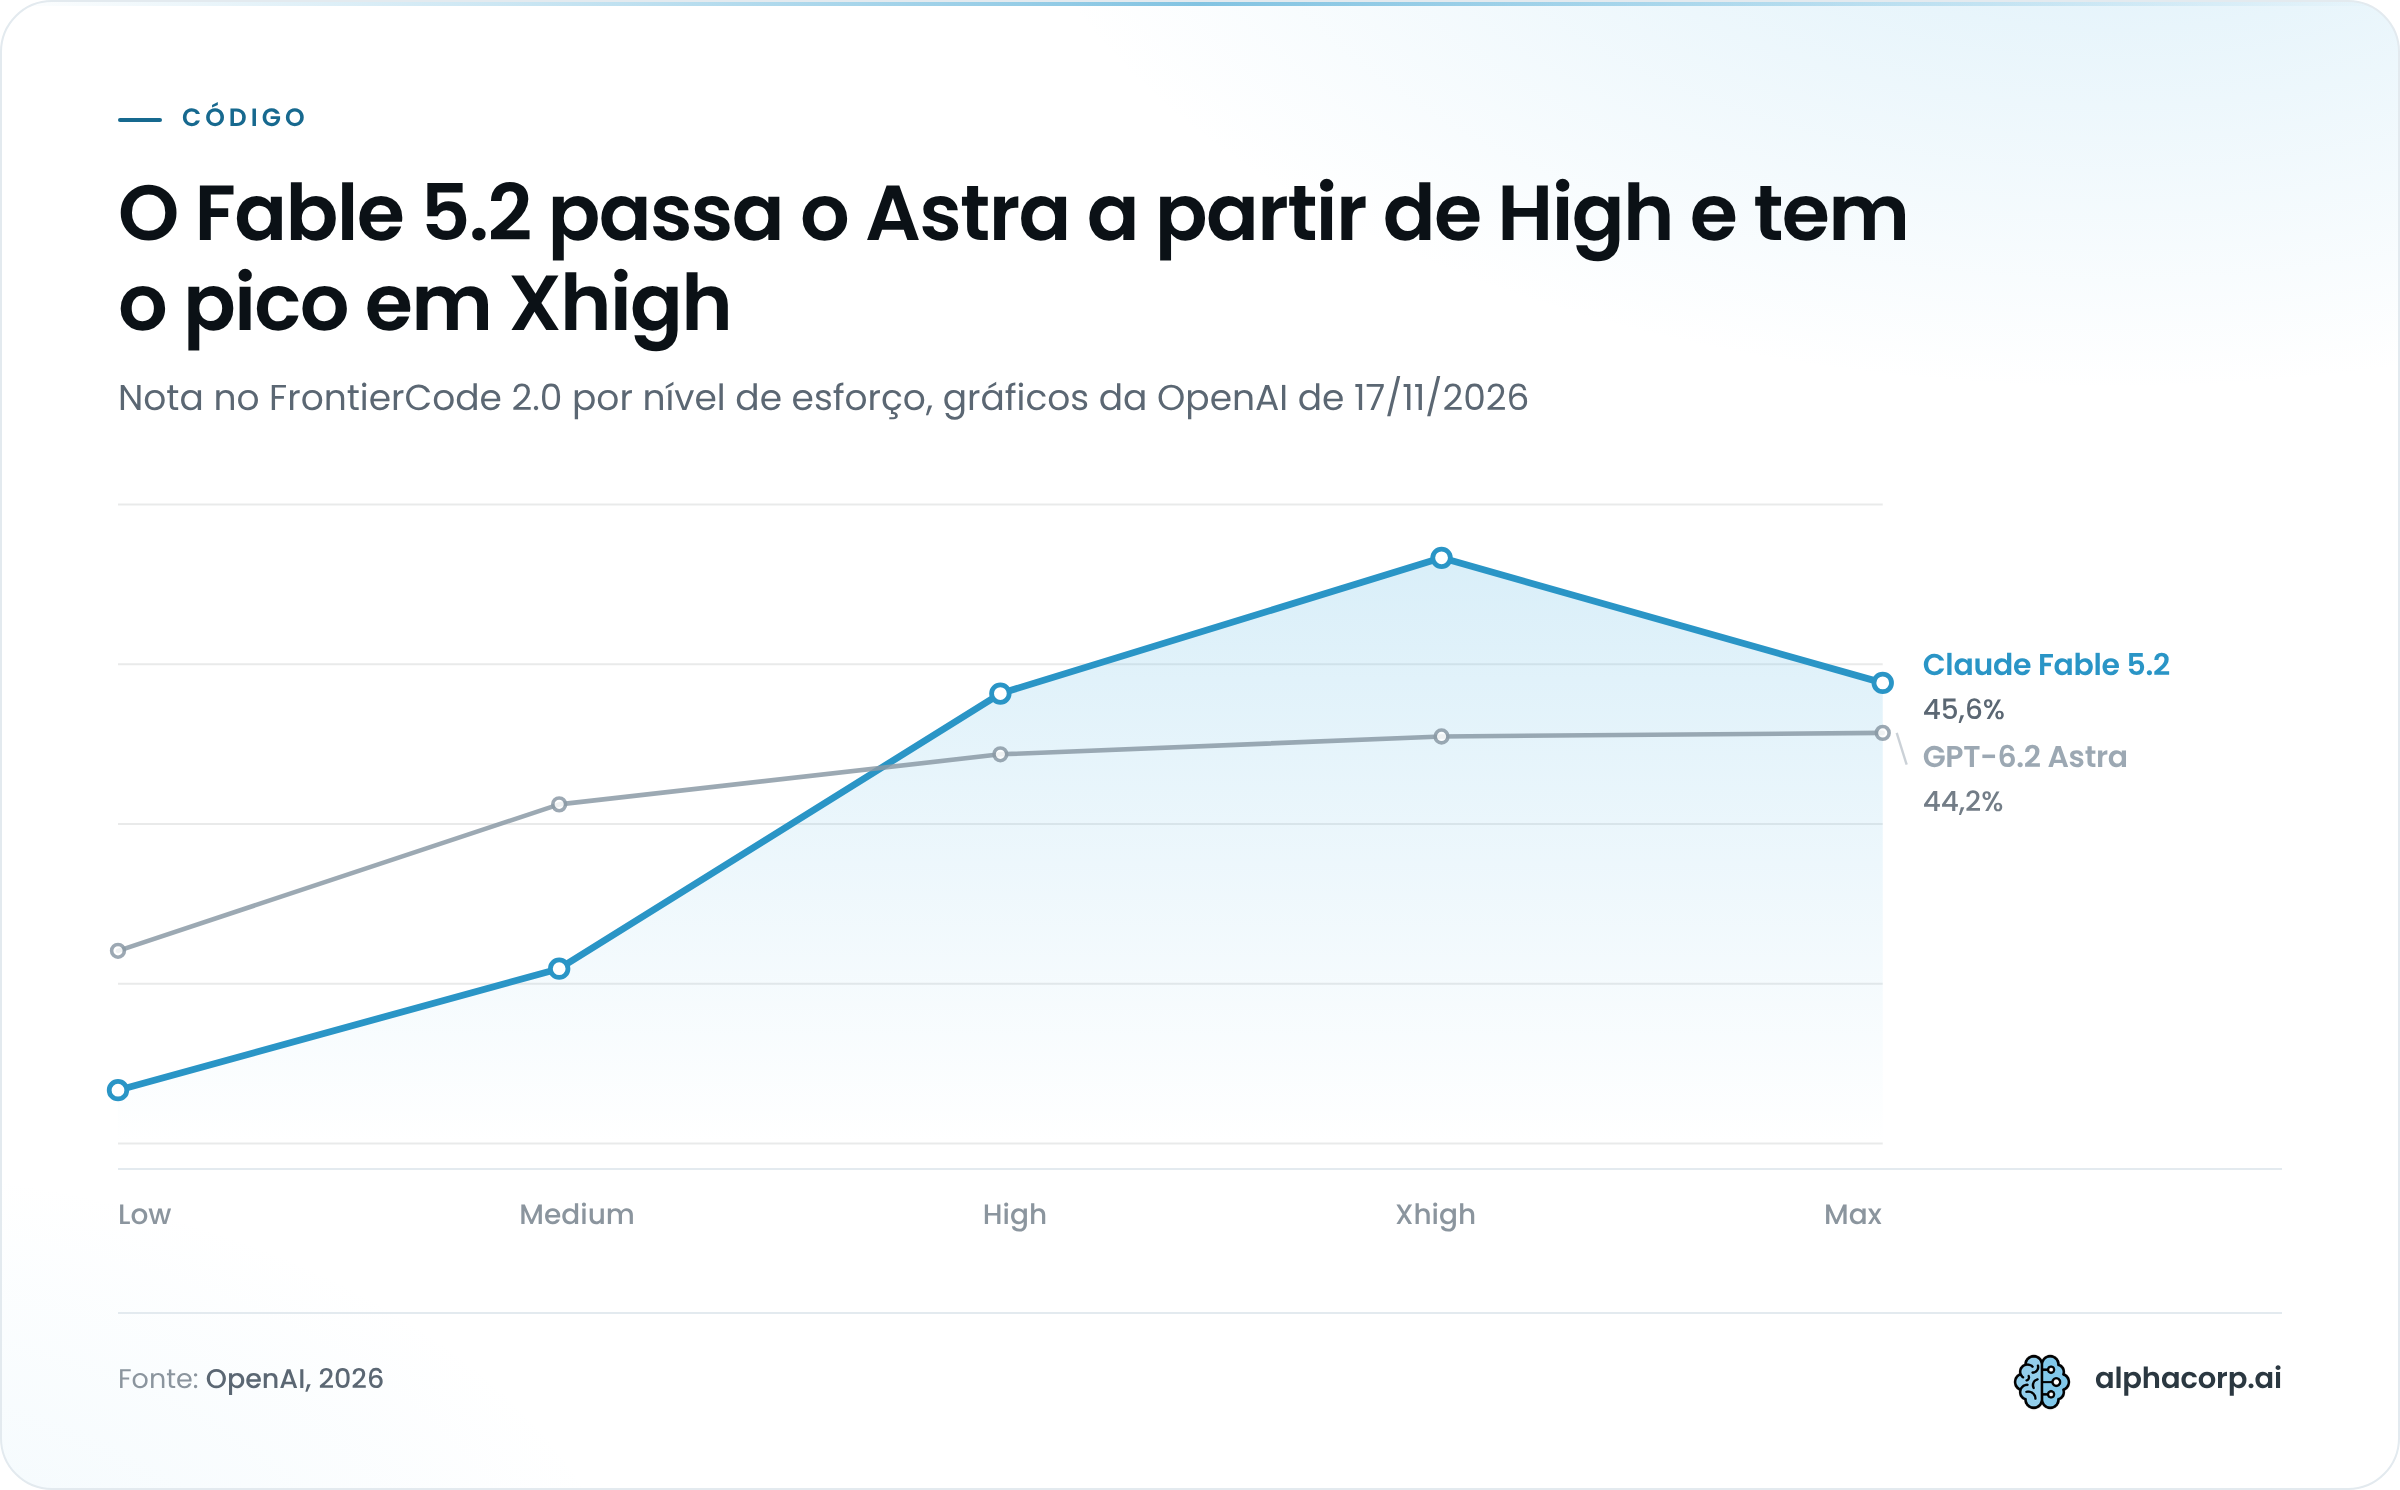
Três leituras saem dessa tabela:
- Até Medium, o Astra vence: em Medium os dois custam quase o mesmo (US$ 2,47 e US$ 2,48) e ele fica 4,6 pontos à frente
- De High a Xhigh, o Fable passa: 45,3% a US$ 6,72 já supera o melhor Astra, e o pico de 49,1% vem em Xhigh
- Em Max, o Fable piora: a nota cai para 45,6% e o custo mais que triplica, de US$ 14,19 para US$ 44,70
Os 49,1% em Xhigh coincidem com o número que a Anthropic reportou ao lançar o modelo, em 9 de novembro de 2026. Pela nossa conta, trocar o melhor Astra pelo Fable em Xhigh custa US$ 8,22 a mais por tarefa e rende 4,9 pontos. A cada 100 tarefas, são cerca de cinco mudanças aceitas a mais por US$ 822, perto de US$ 168 por mudança extra. Se uma rodada de revisão recusada custa mais que isso em hora de engenheiro, o Fable se paga, e em volume alto de tarefas pequenas a conta não fecha.
Existe ainda um terceiro caminho, mais barato. O GPT-6.2 Sol em Max marca 43,8% a US$ 1,29, só 0,4 ponto abaixo do Astra por cerca de um quinto do custo. Steven Hao, CTO da Cognition, resumiu assim no anúncio da OpenAI:
“GPT-6.2 Sol scores within 6 points of the top-performing model at about 90% lower cost.”
Em português: o Sol fica a menos de 6 pontos do modelo de maior nota, que é o Fable 5.2, custando cerca de 90% menos.
O BenchCAD 2.1 Core testa se o modelo constrói peças 3D a partir de desenhos de engenharia e encaixa cada uma em montagens. O Fable 5.2 só lidera em Max, com 83,5% a US$ 50,77 contra 82,5% a US$ 5,43 do Astra. Abaixo disso o Astra vence em todos os níveis: em Xhigh ele faz 77,6% a US$ 3,36, e o Fable faz 74,1% a US$ 23,23. Um ponto percentual por cerca de nove vezes o custo só compensa em peça cujo erro vai parar na fabricação.
Pesquisa científica: Terminal-Bench-Science e Vals Science Index, com os números de cada laboratório
Em pesquisa científica, o GPT-6.2 Astra fica à frente do Claude Fable 5.2 nos dois testes publicados pela OpenAI em 17 de novembro de 2026: 77,1% no Terminal-Bench-Science 0.1, contra 73,3% na medição da Artificial Analysis e 74,6% no número da Anthropic, e 68,4% contra 63,7% no Vals Science Index v1.
Terminal-Bench-Science 0.1: 77,1% do Astra contra 73,3% ou 74,6% do Fable
O Terminal-Bench-Science 0.1 avalia se o modelo conduz trabalho científico dentro de um terminal. O Fable 5.2 tem duas notas nesse teste, cada uma de um laboratório:
| Execução | Origem do número | Ambiente | Nota | Custo |
|---|---|---|---|---|
| GPT-6.2 Astra em Max | OpenAI | não informado | 77,1% | US$ 7,15 |
| Claude Fable 5.2 em Max | Artificial Analysis, no gráfico da OpenAI | mini-swe-agent | 73,3% | US$ 45,21 |
| Claude Fable 5.2 em esforço máximo | Anthropic | Claude Code | 74,6% | não informado |
A Anthropic reporta 74,6% em esforço máximo no Claude Code, no anúncio do Fable 5.2 de 9 de novembro de 2026, 1,3 ponto acima da medição da Artificial Analysis. São fontes e ambientes de execução diferentes, então a distância entre as duas notas do Fable diz pouco. Nas duas leituras o Astra fecha na frente, por 3,8 ou 2,5 pontos.
O custo pesa mais que a nota. No gráfico da OpenAI, o Astra supera o Fable 5.2 nos cinco níveis de esforço e custa menos em cada um. Em High, ele já marca 74,9% a US$ 5,20, acima da melhor execução do Fable naquele ambiente, que saiu por US$ 45,21.
Vals Science Index v1: 4,4 pontos de vantagem no mesmo nível de esforço
O Vals Science Index v1 mede três frentes com peso igual: analisar dados biológicos, descobrir como um sistema funciona e conduzir fluxos de pesquisa. A OpenAI plotou o Fable 5.2 só em High, e a comparação mais limpa é nesse nível:
- GPT-6.2 Astra em High: 68,1% a US$ 2,25
- Claude Fable 5.2 em High: 63,7% a US$ 8,79
- GPT-6.2 Astra em Max: 68,4% a US$ 4,17, a maior nota do gráfico
- GPT-6.2 Astra em Xhigh: 64,8% a US$ 2,47
Em High, o Astra abre 4,4 pontos por cerca de um quarto do custo. O gráfico não mostra quanto o Fable 5.2 marcaria em Max. A curva do Astra quase não sobe depois de Medium (67,6% a US$ 1,88) e ainda cai em Xhigh, então pagar por Max rende 0,3 ponto sobre High e quase dobra o custo.
A OpenAI diz acreditar que o Astra é o melhor modelo do mundo para cientistas. Os dois gráficos apontam nessa direção, mas ambos saíram da página dela, e contra o número da Anthropic a folga no Terminal-Bench-Science é de 2,5 pontos.
Eficiência no GDPval v2: quantos tokens de saída cada modelo gasta
No GDPval v2, o GPT-6.2 Astra gasta 35.812 tokens de saída para marcar 50,4% em Max, e o Claude Fable 5.2 gasta 222.344 para marcar 44,8%, cerca de 6,2 vezes mais. O teste é um benchmark interno da OpenAI, publicado em 17 de novembro de 2026, com tarefas longas de trabalho de conhecimento tiradas de projetos reais em finanças, ciência de dados, biotecnologia e marketing.
A tabela traz nota e tokens de saída em cada nível de esforço, mais a razão entre os dois consumos.
| Nível de esforço | GPT-6.2 Astra | Claude Fable 5.2 | Tokens do Fable por token do Astra |
|---|---|---|---|
| Low | 28,9% (2.112 tokens) | 39,5% (34.961 tokens) | 16,6 |
| Medium | 39,3% (4.987 tokens) | 40,3% (41.334 tokens) | 8,3 |
| High | 45,0% (12.796 tokens) | 41,5% (89.343 tokens) | 7,0 |
| Xhigh | 47,8% (19.640 tokens) | 44,1% (149.959 tokens) | 7,6 |
| Max | 50,4% (35.812 tokens) | 44,8% (222.344 tokens) | 6,2 |
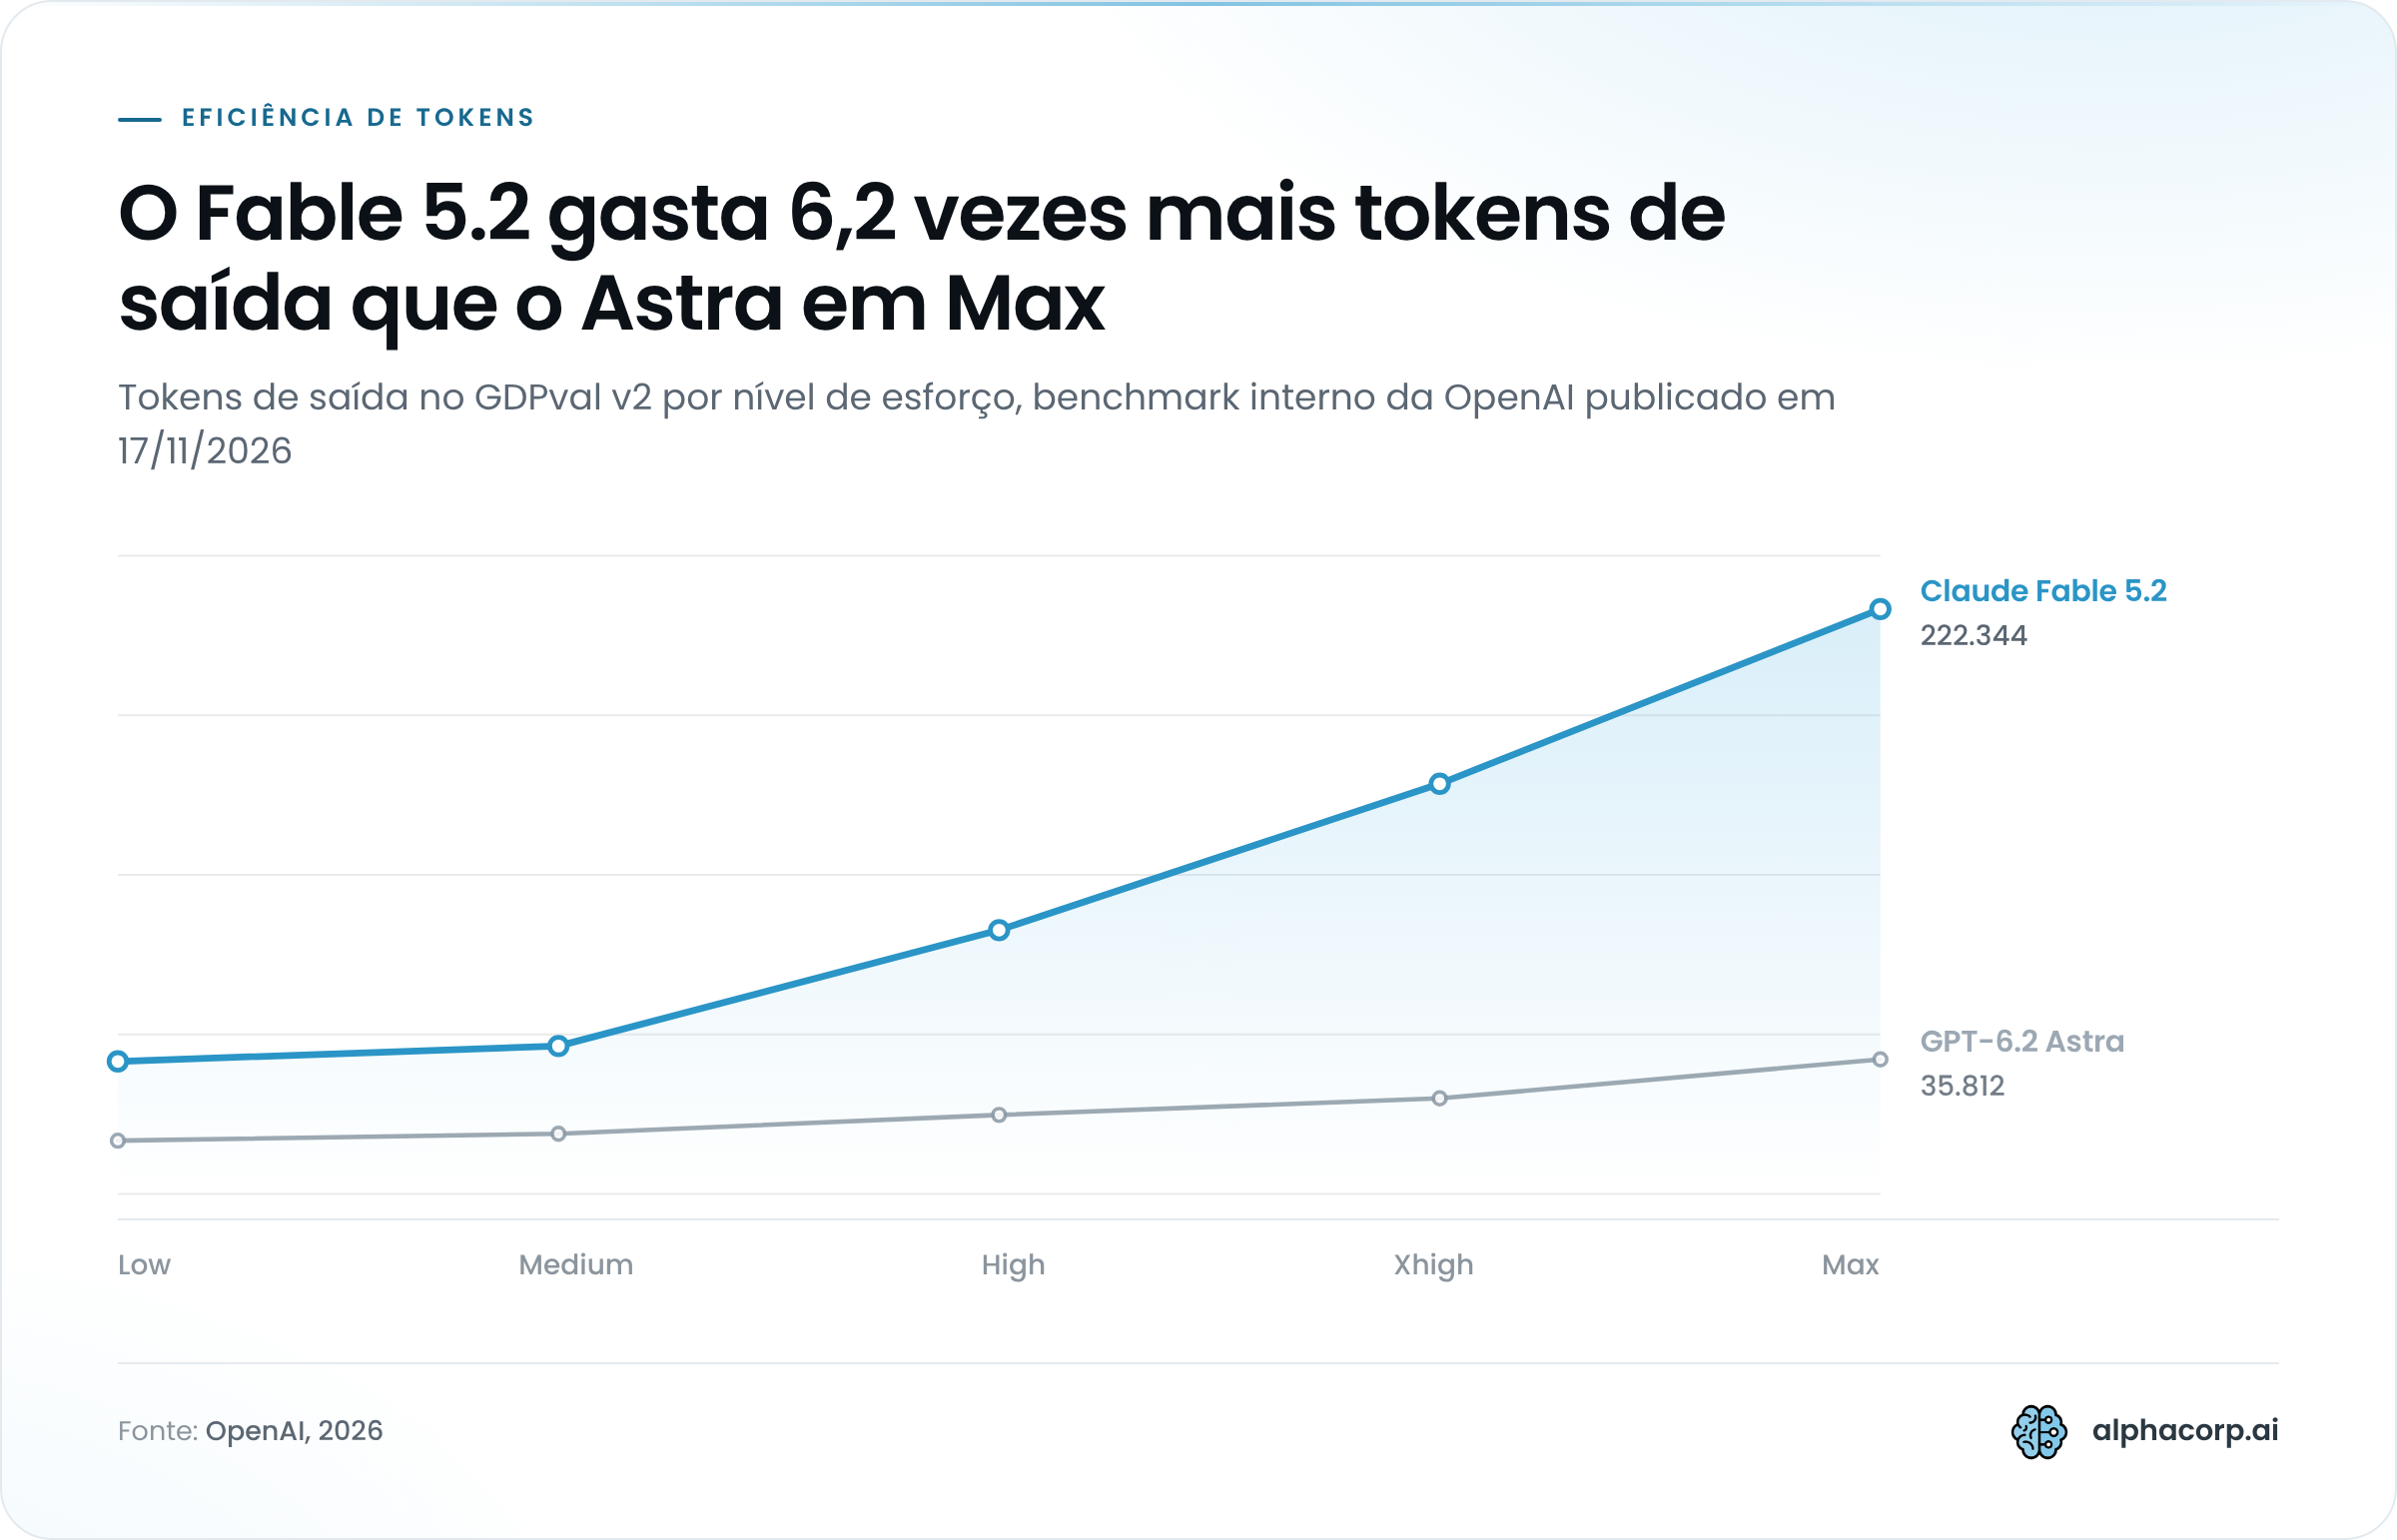
O rótulo de esforço engana nesse gráfico. Em Low, o Fable 5.2 fica 10,6 pontos acima do Astra, mas consome 34.961 tokens, quase o que o Astra gasta em Max. Com um orçamento parecido, perto de 35 mil tokens, o Astra entrega 50,4% e o Fable 39,5%.
- Em Low e Medium, o Fable pontua mais: 39,5% contra 28,9% e 40,3% contra 39,3%
- De High a Max, o Astra lidera, com folga que vai de 3,5 pontos em High a 5,6 em Max
- De Low a Max, o Fable multiplica os tokens por 6,4 e ganha 5,3 pontos, enquanto o Astra multiplica por 17 e ganha 21,5
- Em High, o Gemini 4 Carbon faz 48,8% com 108.729 tokens, a segunda maior nota do gráfico
Token de saída é a parte mais cara da fatura. Com a saída a US$ 40 por milhão de tokens nos dois modelos, 35.812 tokens custam cerca de US$ 1,43 e 222.344 custam cerca de US$ 8,89, pela nossa conta. O gráfico da OpenAI não traz custo em dólar nem tokens de entrada, então esses valores cobrem só uma parte do gasto.
Quem roda milhares de tarefas por mês sente essa diferença de consumo antes de sentir os 5,6 pontos de nota.
O que a tabela de benchmarks da Anthropic mostra sobre o Claude Fable 5.2
A tabela de benchmarks que a Anthropic publicou em 9 de novembro de 2026 mostra o Claude Fable 5.2 à frente do modelo da OpenAI em todas as linhas em que os dois aparecem, com as maiores folgas em robótica, no Remote Labor Index e em raciocínio multidisciplinar. Um detalhe muda a leitura: a coluna da OpenAI nessa tabela é o GPT-6 Astra original, de 3 de setembro de 2026. O GPT-6.2 Astra só saiu oito dias depois.
Oito linhas não têm confronto direto com o GPT-6.2 Astra em nenhuma publicação.
| Benchmark | O que avalia | Claude Fable 5.2 | GPT-6 Astra original |
|---|---|---|---|
| FrontierSWE v2 | Programação agêntica | 69,9% | 65,5% |
| OSWorld 2.1 (conjunto offline, parcial) | Uso de computador | 89,3% | 79,5% |
| RoboDojo Sim | Robótica simulada | 64,9% | 29,8% |
| Remote Labor Index | Trabalho de conhecimento | 41,3% (esforço High) | 20,8% |
| Humanity's Last Exam (com ferramentas) | Raciocínio multidisciplinar | 74,2% | 57,2% |
| AA-Briefcase v1.1, nota por rubrica | Trabalho de conhecimento | 66,1% | 52,0% |
| AA-Briefcase v1.1, Elo | Trabalho de conhecimento | 1.785 | 1.569 |
| Chartography (sem ferramentas) | Leitura de gráficos | 73,4% | 71,0% |
Todos esses números são autorreportados. A Anthropic informa que as notas usam salvaguardas ligadas e o maior esforço disponível de cada modelo, salvo quando a célula diz outra coisa, e que rodou o RoboDojo Sim internamente. O método de cada teste está na ficha de sistema do Claude Fable 5.2 e do Mythos 5.2.
Quatro pontos da tabela costumam ser lidos errado:
- Células do Mythos: CyScenarioBench (76,3%), CVE Rediscovery (89,6%) e design de proteínas (85,1%) são notas do Mythos 5.2, a variante com menos salvaguardas liberada só para organizações verificadas
- CyScenarioBench: do lado da OpenAI aparece o GPT-6 Cyber, com 61%, e cada laboratório foi medido em tarefas próprias
- AA-Briefcase em Elo: o Opus 5.5, modelo mais barato da própria Anthropic, marca 1.800 e fica acima do Fable 5.2
- Remote Labor Index: os 41,3% do Fable 5.2 são em esforço High, abaixo do nível máximo
O que mais nos chamou atenção foi o salto dentro da própria família. Do Fable 5.1 para o 5.2, a nota no RoboDojo Sim passou de 27,6% para 64,9%, e no Remote Labor Index foi de 17,9% para 41,3%.
O anúncio da OpenAI de 17 de novembro de 2026 não traz o GPT-6.2 Astra em nenhum desses testes. Enquanto ninguém rodar os dois modelos atuais em uso de computador, robótica e Humanity's Last Exam, a vantagem do Fable 5.2 nessas frentes vale contra a geração anterior da OpenAI.
Limites desta comparação: testes rodados pela OpenAI, harnesses e níveis de esforço diferentes
Esta comparação entre GPT-6.2 Astra e Claude Fable 5.2 tem um limite central: todos os confrontos diretos saíram da página da própria OpenAI, em 17 de novembro de 2026, e até essa data nenhum avaliador independente repetiu os testes com o GPT-6.2 Astra. A OpenAI escolheu os benchmarks, os níveis de esforço plotados e a conta de custo, inclusive para o modelo concorrente.
Cinco pontos pedem cautela na leitura:
- Fonte única: notas e custos do Fable 5.2 nos confrontos diretos vêm do anúncio de quem vende o modelo rival
- Esforço incompleto: em dois dos nove gráficos o Fable 5.2 aparece em um único nível, o que esconde a curva de custo dele
- Harness diferente: o Fable 5.2 tem duas notas no Terminal-Bench-Science 0.1, com 1,3 ponto de distância entre o mini-swe-agent e o Claude Code
- Benchmark interno: o GDPval v2 pertence à OpenAI e não tem execução de terceiros publicada
- Idioma: nenhum dos dois anúncios traz teste em português
Nível de esforço também não é unidade padrão. Em mais de um gráfico, o nível mais caro de um modelo pontuou abaixo do nível anterior, então “maior esforço disponível” e melhor resultado são coisas diferentes. Max de um fornecedor e Max de outro tampouco representam o mesmo orçamento de tokens.
A tabela da Anthropic tem o problema espelhado: é autorreportada, e a empresa publicou os números antes de o GPT-6.2 Astra existir. Cada laboratório mostra os testes em que o próprio modelo vai bem, e nota tirada da página de um pode vir de harness, esforço ou versão de benchmark diferente da nota tirada da página do outro. Pelo lado do custo, a cobertura do SiliconANGLE sobre o lançamento do GPT-6.2 Astra faz ressalva parecida: os ganhos de manchete dependem do consumo de tokens e podem não se repetir em cargas típicas.
Como ler os placares: na nossa leitura, vantagem de 1 ponto medida por uma única fonte é empate. O que se repete nos nove gráficos é a direção do custo, com a melhor execução do Fable 5.2 sempre mais cara que a do Astra.
Salvaguardas de cibersegurança e biologia: o que cada modelo restringe
Em novembro de 2026, o Claude Fable 5.2 bloqueia a maioria das tarefas de cibersegurança e de biologia de pesquisa, e o GPT-6.2 Astra sai com salvaguardas mais rígidas para pedidos de cibersegurança de maior risco e de uso duplo em biologia. Para segurança ofensiva, nenhum dos dois resolve bem sem acesso especial.
| Ponto | Claude Fable 5.2 | GPT-6.2 Astra |
|---|---|---|
| Cibersegurança de alto risco | Bloqueia teste de invasão, geração de exploits e análise de vulnerabilidade em binários | Restringe parte da pesquisa legítima de vulnerabilidades |
| Biologia | Bloqueia a maioria das tarefas de biologia de pesquisa | Restrições maiores em pedidos de uso duplo |
| Resposta ao bloqueio | Opus 4.8 em cibersegurança, Opus 5 em biologia | não informado |
| Caminho com menos restrição | Mythos 5.2, para organizações verificadas | Daybreak, ainda só com modelos GPT-6 |
No Fable 5.2, quem bloqueia é um classificador. Quando ele barra um pedido, a resposta vem de um modelo Opus mais antigo. A Anthropic afirma que os bloqueios caíram cerca de 55% em relação ao Fable 5.1 nos testes iniciais de 2026, com queda de 60% em cibersegurança e de 40% em biologia. Quem precisa do modelo com menos salvaguardas pede o Mythos 5.2 pelos programas Cyber Verification e Life Sciences Verification.
A OpenAI classifica o risco pelo Preparedness Framework. O GPT-6.2 Astra atinge o limiar Critical em cibersegurança e High em capacidades biológicas e químicas, e é o primeiro modelo que a empresa libera para fora no limiar High de autoaperfeiçoamento de IA. A própria OpenAI admite que as proteções novas barram parte dos testes de segurança legítimos. O programa Daybreak, que dá a defensores acesso com menos recusas, ainda roda só com o GPT-6 Sol, o GPT-6 Astra em alfa e o GPT-6 Cyber.
Três pontos operacionais pesam tanto quanto o bloqueio:
- Retenção de dados no Fable 5.2: a Anthropic retém dados de uso por 30 dias para monitorar segurança, e a retenção zero fica restrita a clientes elegíveis ou ao Enterprise Frontier Safeguards, em beta privado
- Omissão de obstáculos no GPT-6.2 Astra: no teste que a OpenAI publicou em 17 de novembro de 2026, ele deixou de avisar sobre um obstáculo, como um arquivo removido, em 22,28% dos casos sem instrução do desenvolvedor, contra 11,09% do GPT-6 Astra
- Ações indevidas no GPT-6.2 Astra: a taxa de dano de alta severidade em tarefas de escritório simuladas caiu de 1,20% no GPT-6 Astra para 0,64%
A OpenAI incluiu no Codex uma instrução que derruba a omissão para 8,04% e diz que continua investigando o comportamento. Se você roda o Astra pela API, fora do Codex, peça no prompt de sistema que o agente avise quando faltar um arquivo ou uma ferramenta. Para empresa brasileira com dado sensível sob a Lei Geral de Proteção de Dados (LGPD), os 30 dias do Fable 5.2 são cláusula de contrato. Leia essa cláusula antes do primeiro deploy.
Perguntas frequentes sobre GPT-6.2 Astra vs Claude Fable 5.2
As dúvidas mais buscadas sobre GPT-6.2 Astra vs Claude Fable 5.2, em novembro de 2026, têm resposta curta: os dois cobram preço igual por token, o Astra gasta menos por tarefa e o Fable 5.2 pontua mais em código. Os confrontos diretos citados nas respostas saíram da página da própria OpenAI.
Qual é melhor para programar, GPT-6.2 Astra ou Claude Fable 5.2?
O Claude Fable 5.2 tem a maior nota em código: 49,1% no FrontierCode 2.0, em Xhigh, contra 44,2% do GPT-6.2 Astra em Max, nos gráficos que a OpenAI publicou em 17 de novembro de 2026. A execução do Fable custa US$ 14,19 por tarefa, e a do Astra, US$ 5,97. Com orçamento curto, o GPT-6.2 Sol marca 43,8% a US$ 1,29.
Qual dos dois é mais barato?
Por token, nenhum dos dois é mais barato: em novembro de 2026, GPT-6.2 Astra e Claude Fable 5.2 cobram US$ 8 por milhão de tokens de entrada e US$ 40 de saída. Por tarefa, o Astra sai na frente. Nos nove gráficos da OpenAI, a melhor execução dele custou menos, ou consumiu menos tokens de saída, que a melhor do Fable 5.2. A exceção a favor do Fable é a leitura de cache, a US$ 0,20 contra US$ 0,40.
Quanto custam o GPT-6.2 Astra e o Claude Fable 5.2 em reais?
GPT-6.2 Astra e Claude Fable 5.2 têm preço de API em dólar: US$ 8 por milhão de tokens de entrada e US$ 40 de saída, nas tabelas de novembro de 2026. Câmbio, IOF e impostos entram por cima. Como referência, a PTAX de venda do Banco Central fechou em R$ 5,7851 em 17/11/2026, depois de subir cerca de 3,6% em uma semana. Coloque data em qualquer orçamento.
Quando o GPT-6.2 Astra e o Claude Fable 5.2 foram lançados?
O Claude Fable 5.2 saiu em 9 de novembro de 2026 e o GPT-6.2 Astra em 17 de novembro de 2026, oito dias depois. O antecessor direto do Astra, o GPT-6 Astra, é de 3 de setembro de 2026. Qualquer comparativo publicado antes de 17 de novembro trata desse modelo antigo.
Onde usar o GPT-6.2 Astra e o Claude Fable 5.2?
O GPT-6.2 Astra está no ChatGPT Work, no Codex e na API da OpenAI, e o Claude Fable 5.2 está na Claude API, no Amazon Bedrock, no Google Cloud, no Microsoft Foundry e na Claude Platform on AWS. No ChatGPT, o acesso ao GPT-6.2 Astra vale para os planos Plus, Pro, Enterprise e Edu, com liberação em etapas desde 17 de novembro de 2026 e fora do Chat comum. Na API, os identificadores são gpt-6.2-astra e claude-fable-5-2.
Qual é o tamanho da janela de contexto de cada modelo?
Os dois modelos aceitam cerca de 1 milhão de tokens de contexto e geram até 128 mil tokens de saída, nas fichas de novembro de 2026. A ficha do GPT-6.2 Astra na documentação da OpenAI lista 1.050.000 tokens, com entrada máxima de 922.000. No Astra, entrada acima de 272 mil tokens paga o dobro na entrada e 1,5 vez na saída. O corte de conhecimento é junho de 2026 no Fable 5.2 e 18/05/2026 no Astra.
Qual a diferença entre Claude Fable 5.2 e Claude Mythos 5.2?
Fable e Mythos são um modelo só. O Fable 5.2 traz salvaguardas de cibersegurança e biologia e fica aberto a todos os usuários, e o Mythos 5.2 tem menos salvaguardas e só chega a organizações verificadas. Os dois custam US$ 8 e US$ 40 por milhão de tokens, na tabela de novembro de 2026.
Qual a diferença entre GPT-6.2 Astra e GPT-6.2 Sol?
O GPT-6.2 Astra é o modelo de topo da OpenAI para projetos difíceis, e o GPT-6.2 Sol é o modelo do dia a dia, a US$ 2 e US$ 10 por milhão de tokens em novembro de 2026, um quarto do preço. No Agents' Last Exam v1.1, o Sol em Max marca 73,0% a US$ 1,32 por tarefa. O Astra em Xhigh marca 78,3% a US$ 2,89, nos gráficos da OpenAI.
Por onde começar: como escolher e testar os dois modelos no seu caso de uso
Para escolher entre GPT-6.2 Astra e Claude Fable 5.2 em novembro de 2026, parta do tipo de carga, rode as suas tarefas nos dois modelos no mesmo nível de esforço e decida pelo custo por tarefa. Os placares publicados só montam a lista de candidatos.
- Defina o ponto de partida pela carga: Astra para trabalho profissional de várias etapas, jurídico, ciência e automação, Fable 5.2 para código avaliado por merge e CAD de precisão.
- Separe tarefas reais da sua operação que já tenham resposta conferida pela equipe, incluindo algumas em português.
- Rode os dois modelos no mesmo nível de esforço e depois repita um nível abaixo, porque o nível mais caro nem sempre pontua mais.
- Meça custo por tarefa e tokens de saída. O preço por token é igual nos dois e não separa nada.
- Teste o GPT-6.2 Sol e o Opus 5.5 nas mesmas tarefas antes de pagar pelo topo de linha.
Guarde esse conjunto de tarefas depois do teste. Os dois lançamentos saíram com oito dias de diferença, e a próxima versão de qualquer um deles vai pedir a mesma comparação. Quem já tem o teste pronto decide sem depender do anúncio de ninguém.
Se você quer rodar essa comparação com as cargas da sua empresa antes de fechar contrato com um dos fornecedores, fale com o time da AlphaCorp AI.